


Tout le monde se met soudain à parler de graphes de contexte, à la suite de la publication de Jaya Gupta et Ashu Garg sur la prochaine opportunité à mille milliards de dollars de l'IA. Chez Glean, nous nous en réjouissons — car cela porte enfin un nom. Des graphes de contexte qui comprennent non seulement vos données, mais aussi la façon dont votre entreprise fonctionne réellement.
Nous en sommes à un point où presque tout dans l'entreprise a été numérisé : les décisions et les données structurées sont consignées dans les systèmes d'enregistrement, tandis que le travail quotidien se déploie à travers les outils de communication, les systèmes de gestion de projet, les référentiels de code, et bien plus encore.
Les graphes de contexte éclairent la manière dont le travail s'accomplit réellement en entreprise, rendant l'automatisation possible. Avec l'essor des agents et leur capacité à raisonner et à agir, une avancée majeure se profile en matière d'automatisation, mais uniquement si ce raisonnement s'appuie sur le bon contexte d'entreprise.
Le contexte doit évoluer au rythme des progrès de l'IA
Glean a été fondée avec la conviction qu'une excellente recherche constitue le socle du contexte. Cela signifie comprendre le contenu : indexer les données non structurées pour que les collaborateurs puissent effectuer des recherches dans toute leur entreprise et trouver rapidement les informations les plus récentes et les plus pertinentes — comme le dernier document de conception, une mise à jour de politique ou une note client — nécessaires pour répondre à une question ou débloquer une tâche.
Mais à mesure que l'IA a commencé à prendre en charge des travaux plus complexes, nous avons appris que ce socle devait s'élargir. Il ne suffit pas de comprendre les seules données de l'entreprise ; les systèmes ont aussi besoin d'une connaissance des relations. La façon dont le travail s'accomplit en entreprise est fondamentalement guidée par les relations — savoir qui est responsable d'un compte, qui approuve un contrat, quel ingénieur est de garde, ou quelles équipes collaborent lorsqu'un incident s'intensifie.
Les outils de RPA et de workflow ont cherché à automatiser les processus les mieux compris dans les organisations, mais la majorité du travail est distribuée — réalisée par des individus et de petites équipes, avec des processus documentés uniquement sous forme de « savoir tribal ». Comment intégrer cette majorité du travail dans le périmètre de l'automatisation, et permettre aux agents d'apprendre et d'automatiser ce travail ? C'est là que les graphes de contexte entrent en jeu.
Les graphes de contexte visent avant tout à capturer la réalité des processus pour automatiser le travail
L'apport de Glean aux graphes de contexte : « Vous ne pouvez pas capturer le pourquoi de façon fiable ; vous pouvez capturer le comment. »
Le pourquoi relève souvent d'une étape de réflexion qui réside généralement dans la tête de quelqu'un — on ne peut pas réellement le modéliser. Parfois, il transparaît dans la transcription d'une réunion ou un fil Slack, mais la majeure partie n'est jamais consignée de façon claire ou durable.
Le comment, en revanche, laisse une riche trace numérique : étapes récurrentes, mises à jour de données, approbations, schémas de collaboration, champs modifiés et comportements inter-systèmes au fil du temps. Au fil de nombreux cycles, ces traces de processus approximent le pourquoi : vous pouvez déduire les raisons à partir des schémas de la façon dont le travail se répète — plutôt que d'essayer de stocker littéralement chaque pensée humaine.
Dans cette optique, l'objectif derrière les graphes de contexte devient de capturer le « comment » (le processus) dès maintenant, et d'apprendre le « pourquoi » (l'intention) au fil du temps. Si les agents sont censés automatiser le travail réel en entreprise, la voie consiste à modéliser les processus en profondeur afin de comprendre les conditions dans lesquelles le travail progresse, s'arrête ou s'intensifie, de sorte que la prochaine fois qu'une situation se présente, l'agent puisse déterminer les bonnes actions à entreprendre.
Les graphes de contexte sont un investissement technique
Créer ce niveau de connaissance et de compréhension n'est pas chose aisée. Construire des graphes de contexte est difficile :
- Observabilité (via les connecteurs et les applications) : Obtenir une compréhension complète de ce qui se passe dans une entreprise exige bien plus que des données décisionnelles propres et structurées issues des systèmes d'enregistrement. Cela exige une observabilité à travers les connecteurs et les applications où le travail s'accomplit réellement — à la fois l'étendue pour capturer l'activité à travers les nombreux outils utilisés par les collaborateurs, et la profondeur pour extraire des signaux pertinents de chaque connecteur. Par exemple, un connecteur vers Salesforce peut révéler un changement d'étape d'une opportunité, mais la véritable observabilité provient aussi de la visibilité sur l'activité à travers les applications connectées : un document modifié dans Google Docs, un message envoyé dans Slack, une réunion créée dans Calendar, ou un enregistrement mis à jour dans Salesforce — chacun capturé directement depuis le système sous-jacent via son connecteur.
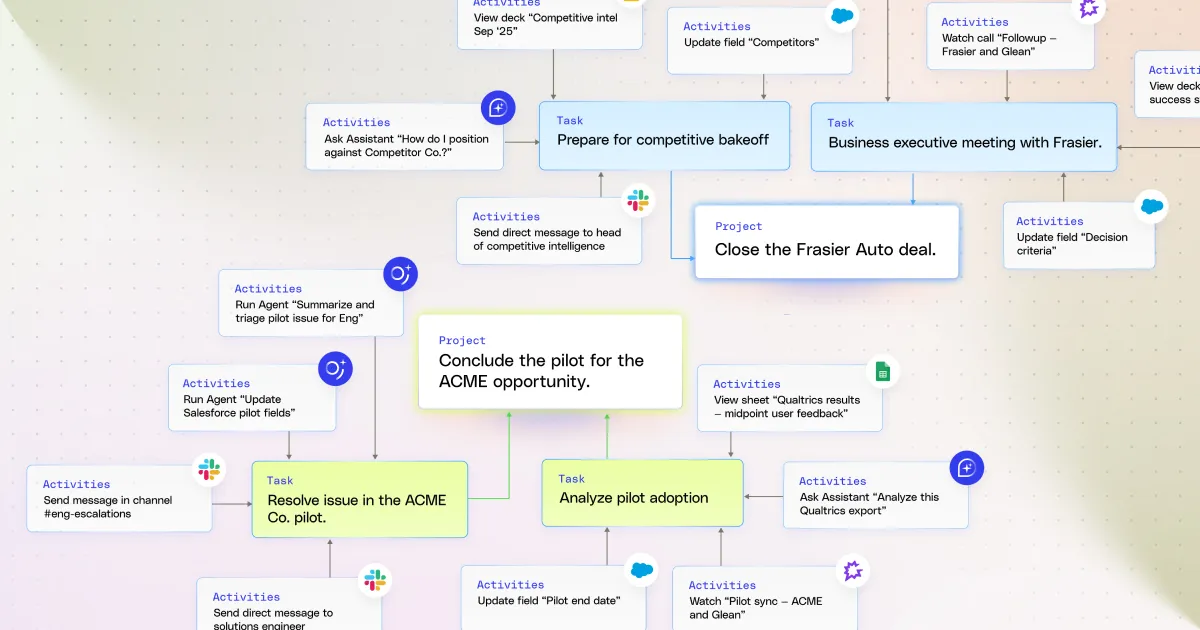
- Comprendre les données d'activité : Au-delà de l'indexation du contenu, les systèmes doivent capturer des signaux d'activité de bas niveau : des actions discrètes et horodatées effectuées au sein des outils. Celles-ci incluent des événements comme la modification d'un document, la mise à jour d'un champ, l'ajout d'un commentaire, l'envoi d'un message Slack ou le téléchargement d'un fichier. Capturer ces actions dans l'ordre chronologique — et suivre l'évolution de l'état entre elles — fournit les données d'activité brutes.
- Dégager une compréhension de plus haut niveau des tâches, projets et initiatives : Ce n'est qu'après avoir collecté ces données d'activité atomiques que les systèmes peuvent commencer à inférer des constructs de plus haut niveau. Des schémas, associés à une compréhension sémantique à travers de nombreuses actions de bas niveau — modifications répétées de documents, messages Slack coordonnés et mises à jour fréquentes des mêmes enregistrements — peuvent être agrégés pour signaler une tâche, un projet ou une initiative plus large. Par exemple, une séquence de création de documents, de modifications, de messages Slack et de mises à jour d'enregistrements sur plusieurs jours peut représenter collectivement un effort d'intégration client ou un lancement de produit, même si ce travail n'a jamais été explicitement étiqueté comme tel dans un seul système.
Distinguer les signaux du bruit est difficile, surtout en entreprise. Chez Glean, par exemple, notre compréhension des tâches atteint environ 80 % de précision — un indicateur de la robustesse que doit atteindre toute la technologie en amont pour rendre cela viable. C'est d'autant plus remarquable que, étant destinés à l'entreprise, les graphes de contexte ne sont pas construits à l'échelle d'Internet. Les données ne peuvent pas être agrégées entre les clients, et les jeux de données qui en résultent sont à la fois plus réduits et inaccessibles aux humains en raison de contraintes de confidentialité — ce qui impose que les graphes soient inférés de façon algorithmique.
Les graphes de contexte font partie de la suite fondamentale de technologies qui constituent la prochaine plateforme de données
Si les graphes de contexte retiennent le plus l'attention en ce moment, chez Glean nous savons que résoudre le contexte ne peut pas reposer sur une seule technologie. Parvenir à une véritable compréhension des processus exige une pile de technologies travaillant de concert : des connecteurs pour observer l'activité à travers les outils, des index pour permettre une récupération rapide, des graphes pour modéliser la structure et les relations de l'entreprise, et une mémoire pour capturer ce qui se passe lorsque les agents exécutent réellement le travail. C'est cette pile qui permet aux systèmes de passer des données brutes de l'entreprise à des agents capables d'agir.
À mesure que les agents commencent à opérer au sein de l'entreprise, l'apprentissage devient essentiel. Ce qui fonctionne pour les humains ne se transpose pas toujours directement aux agents. En capturant les traces d'exécution — comment les agents utilisent les outils, dans quelles séquences et avec quels résultats — les systèmes peuvent apprendre du travail agentique en pratique. Ces traces forment la mémoire de l'entreprise, en capturant ce qui fonctionne réellement pour les agents au fil du temps. La compréhension des processus ne provient pas du graphe de contexte seul ; elle émerge de la combinaison entre compréhension structurelle et comportement appris.
Lorsque vous prenez du recul et considérez toutes ces couches ensemble — connecteurs, index, graphes, mémoire personnelle et mémoire d'entreprise — vous réalisez que vous avez, en pratique, construit une toute nouvelle plateforme de données. Une plateforme conçue non pas pour le reporting ou l'analytique, mais comme la colonne vertébrale de l'automatisation agentique : un système qui observe comment le travail s'accomplit, apprend de l'exécution en pratique et permet aux agents de faire avancer le travail de manière fiable dans toute l'entreprise. Chez Glean, nous disposons désormais de cette plateforme de contexte — y compris le graphe — après six années d'investissement technique.
Le contexte est la base du travail agentique
La véritable question qui sous-tend la publication de Jaya et Ashu est de savoir comment permettre aux agents d'accomplir efficacement le travail au sein de l'entreprise. Comment peuvent-ils apprendre, comprendre et opérer comme votre entreprise ? Si les agents doivent prendre en charge davantage de travail, cette opportunité dépend d'une base de contexte, qui comprend vos données d'entreprise, vos relations et vos processus.
