



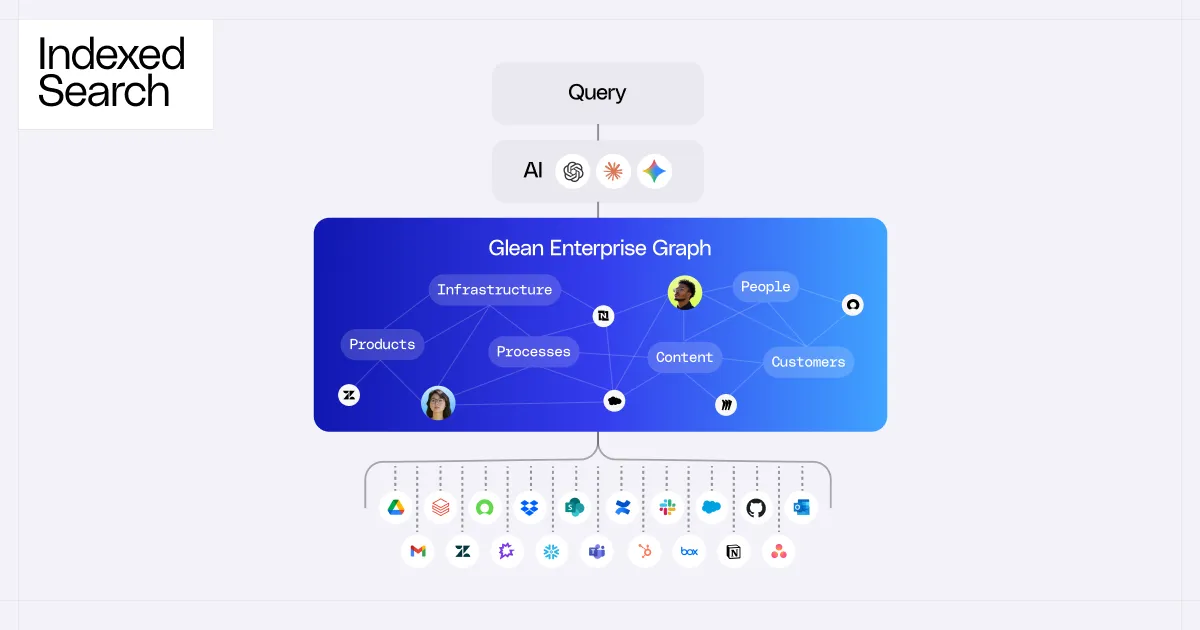
De plus en plus de fournisseurs d'IA d'entreprise se tournent vers l'indexation pour améliorer la précision, la latence et l'efficacité en matière de tokens. C'est une véritable bonne nouvelle. Cela valide un principe autour duquel Glean s'est construit depuis sa création : donner à l'IA l'accès aux systèmes de l'entreprise ne suffit pas. Les données d'entreprise doivent être organisées, soumises à des autorisations et rendues pertinentes avant qu'un modèle puisse les exploiter correctement.
L'indexation est l'un des moyens les plus efficaces pour intégrer le contexte d'entreprise dans l'IA. Nos clients bénéficient de l'indexation de Glean depuis 2019, dans l'ensemble de leurs applications, et ces avantages n'ont fait que se renforcer à mesure que l'IA prend en charge des travaux plus longs et plus complexes. Le rôle de l'indexation prend une importance croissante dans la réduction de la consommation de tokens, en simplifiant la récupération du contexte pertinent.
Mais l'indexation seule ne constitue pas l'ensemble du système. Elle n'est qu'un composant du système de contexte de Glean. L'indexation rend les informations d'entreprise détectables et pertinentes. Les graphes cartographient les relations pour que la pertinence reflète le fonctionnement réel de l'entreprise. La mémoire transmet les apprentissages d'une session et d'une tâche à l'autre. Les connecteurs de données intègrent ou récupèrent les informations via l'indexation, des requêtes structurées ou une fédération en direct, selon la source. Les outils permettent à l'IA d'agir sur ce contexte.
Tous les index ne connectent pas l'entreprise
« Nous indexons vos données » peut décrire des systèmes très différents. Cela peut signifier générer des embeddings limités pour des documents provenant d'une poignée d'applications, ou même maintenir un index distinct pour chaque source. La meilleure indexation s'étend à l'ensemble de vos applications d'entreprise, créant une base unifiée et respectueuse des autorisations qui préserve les entités, les identités, l'activité et les relations. On appelle tout cela des index. Ils ne donnent pourtant pas à l'IA la même vision de l'entreprise.
Un index par application peut améliorer la récupération au sein de cette source. Mais le travail en entreprise reste rarement cantonné à un seul système. Un client peut apparaître dans le CRM, les tickets d'assistance, les notes d'appel et les documents de planification. Si ces sources restent isolées, le modèle doit encore reconnaître qu'elles se rapportent au même client et réconcilier des résultats classés séparément par chaque système.
Glean normalise le contenu et les signaux entre les applications connectées afin que la recherche et les agents partent d'une base cohérente et respectueuse des autorisations. La pertinence est préparée avant la requête, et non reconstruite à chaque fois à partir de résultats déconnectés.
Un index d'entreprise a besoin de largeur et de profondeur
De nombreux fournisseurs affirment se connecter à une variété de systèmes d'entreprise clés, mais compter les connecteurs ne raconte qu'une partie de l'histoire. Ce qui compte, c'est à la fois jusqu'où un index s'étend et ce qu'il préserve une fois qu'il y parvient.
Largeur : l'index atteint-il là où le travail se fait ?
Le contexte n'est utile que dans la mesure des sources qu'il inclut. Un index qui atteint le wiki de l'entreprise et la file d'attente d'assistance, mais s'arrête avant le CRM, peut répondre correctement aux questions de processus et de manière incomplète aux questions clients. Un risque plus grand que l'inexactitude est que la réponse puisse tout de même sembler complète, menant à des erreurs évitables. Aucun système d'IA ne peut tenir compte d'une décision, d'une relation ou d'une exception qu'il n'a jamais eu l'occasion de trouver.
Les lacunes de couverture sont silencieuses. Elles ne produisent pas de message d'erreur. Elles produisent des réponses confiantes auxquelles il manque des pièces.
Profondeur : l'index préserve-t-il ce qui rend chaque source utile ?
Un connecteur peut récupérer du texte tout en perdant la structure qui l'entoure. Un enregistrement peut arriver sans son propriétaire, son statut, ses autorisations ou ses relations. Un document peut perdre les signaux d'activité et de fraîcheur qui indiquent si les équipes s'y fient encore.
Glean indexe le texte intégral, mais indexe aussi les métadonnées, les entités structurées, les identités, les autorisations et les signaux d'activité. Une opportunité Salesforce reste une opportunité, avec ses champs et ses relations intacts, plutôt que d'être stockée comme un bloc censé décrire ces champs. Les autorisations des sources sont reflétées, et les mises à jour, les changements d'autorisations et les suppressions sont répercutés à mesure que les systèmes sous-jacents évoluent.
Cette profondeur façonne également le classement. La similarité sémantique peut montrer que deux documents traitent du même sujet. Elle ne peut pas indiquer au système celui auquel l'entreprise fait confiance. La paternité, les consultations, les modifications, les commentaires, la fraîcheur et les relations aident à déterminer ce qui est réellement pertinent, tandis que les autorisations protègent toujours les données sensibles et contrôlent ce que chaque personne peut voir.
Des travaux différents nécessitent des index différents
Les informations d'entreprise n'ont pas toutes la même apparence ni le même comportement. Un document de politique, un dépôt de code, un enregistrement client, un profil d'employé et un événement de calendrier présentent chacun un problème de récupération différent. Résoudre ces problèmes de récupération rapidement et efficacement devient de plus en plus important à mesure que l'IA prend en charge des tâches plus vastes, plus importantes et plus complexes.
La récupération sémantique aide lorsqu'une personne décrit une idée différemment de la source. La récupération lexicale est préférable lorsque les mots exacts comptent, comme un nom, un identifiant, un nom de fichier ou un message d'erreur. Les enregistrements structurés doivent préserver leurs champs et leurs relations au lieu d'être aplatis en texte. Trouver le bon expert ou le bon outil repose sur des signaux différents de ceux utilisés pour trouver un document.
C'est pourquoi Glean ne s'appuie pas sur un seul index polyvalent. Il utilise des index spécialisés pour les données d'entreprise, le code, les experts, les profils, les outils et les calendriers. Ces index rendent la récupération plus rapide et plus simple, réduisant l'effort dont l'IA a besoin pour fournir des réponses utiles, précises et fiables.
Un meilleur index améliore l'efficacité en matière de tokens et le rendement
Lorsque les informations sources sont correctement indexées, les modèles ont moins de travail à fournir. Fait important, l'efficacité en matière de tokens commence avant même que le modèle ne commence à raisonner. Au moment où une question parvient au modèle, le système devrait déjà avoir réalisé une grande partie du travail consistant à trouver et à préparer le bon contexte. Glean construit des index sémantiques et lexicaux personnalisés, entraînés sur le corpus de votre entreprise, apprenant les acronymes, les noms de produits, les noms d'équipes, les termes sectoriels, afin que la récupération trouve le bon contexte dès le premier passage, au lieu que le modèle doive trier et résoudre lui-même les ambiguïtés.
L'efficacité en matière de tokens ne consiste pas à rechercher le nombre de tokens le plus bas possible pour le principe. Il s'agit de dépenser des tokens dans le raisonnement plutôt qu'à trier à plusieurs reprises des résultats faibles ou redondants. Une fenêtre de contexte plus grande ne résout pas ce problème à elle seule. Davantage d'informations non triées donnent au modèle plus de choses à passer au crible, et non une meilleure compréhension de ce qui compte.
Cela devient d'autant plus important à mesure que les agents prennent en charge des tâches plus longues. Un contexte faible à une étape peut fausser tout ce qui suit. Une base de récupération plus solide rend la qualité et la latence plus prévisibles et libère une plus grande part de l'attention du modèle pour le raisonnement, la planification et l'action.
Concrètement, une meilleure efficacité en matière de tokens signifie qu'une plus grande part de l'effort du modèle est consacrée à la tâche et moins au tri du contexte.
L'index est la fondation de l'IA d'entreprise
Un index performant aide l'IA à trouver les bonnes informations. Mais la récupération n'est qu'une partie du travail. Un agent doit encore comprendre comment ces informations s'articulent, comment le travail s'accomplit, quels outils utiliser et si le résultat est réellement satisfaisant.
L'indexation n'est qu'un élément d'un système de contexte efficace
C'est précisément ce que le système de contexte de Glean est conçu pour faire. Les index, les graphes, la mémoire, les connecteurs de données et les outils résolvent chacun une partie différente du problème du contexte.
- Les index trouvent les informations pertinentes. Glean utilise des index spécialisés pour les données d'entreprise, le code, les experts, les profils, les outils et les calendriers, ainsi qu'une récupération sémantique, lexicale et structurée adaptée aux différents types d'informations et de questions.
- Les graphes expliquent comment les informations s'articulent entre elles. Le Graphe d'entreprise relie les personnes, les équipes, les clients, les projets, le contenu, les applications et les processus qui sous-tendent le travail. Les graphes personnels ajoutent du contexte sur la façon dont un individu travaille, notamment ses tâches, ses préférences, ses projets et ses habitudes d'activité.
- La mémoire fait avancer le contexte utile. La mémoire d'entreprise aide les agents à appliquer ce qui a été appris tout au long de travaux de longue durée, tandis que la mémoire personnelle permet d'adapter les réponses et les tâches à un individu au fil du temps.
- Les connecteurs de données empruntent le bon chemin pour chaque source. Certaines informations sont mieux indexées. Les systèmes structurés peuvent être interrogés directement. D'autres sources requièrent une récupération fédérée ou en temps réel. Glean prend en charge chacune de ces approches plutôt que de forcer tous les systèmes à passer par la même méthode de récupération.
- Les outils permettent à l'IA d'agir. Les actions natives et basées sur MCP permettent aux agents de mettre à jour des enregistrements, d'envoyer des communications et d'accomplir des tâches dans les applications connectées.
Il ne s'agit pas de cinq fonctionnalités indépendantes assemblées autour d'un index. Elles se renforcent mutuellement. Des signaux plus riches issus des connecteurs et des outils donnent au graphe davantage d'entités, de relations et de signaux de pertinence avec lesquels travailler. Ensemble, le Graphe d'entreprise et les graphes personnels ajoutent du contexte sur le fonctionnement de l'entreprise et sur la manière dont chaque personne y travaille. La mémoire fait avancer ce contexte, et les outils le transforment en action.
Un index superficiel limite tout ce qui repose sur lui. Mais même le meilleur index ne peut pas tout faire à lui seul.
C'est là toute la différence entre ajouter un index et construire un système de contexte. Un index aide l'IA à trouver des informations. Le système de contexte de Glean l'aide à comprendre l'entreprise, à agir sur ce qu'elle sait et à apprendre du travail accompli.
Les questions que les entreprises devraient se poser ensuite
Voir davantage de fournisseurs investir dans l'indexation est une évolution bienvenue. Mais l'annonce d'un index n'est qu'un point de départ. Les entreprises devraient examiner le fonctionnement de l'index, puis regarder au-delà.
Comment l'index fonctionne-t-il ? Unifie-t-il les informations entre les applications ou garde-t-il chaque source séparée ? Préserve-t-il les entités, les champs, les identités, les permissions, la fraîcheur et l'activité ? Utilise-t-il des méthodes de récupération adaptées aux différents types de travail ? Et quelle part de classement, de filtrage et de préparation du contexte intervient avant que le modèle ne commence à consommer des tokens ?
Qu'a construit le fournisseur au-delà de l'index ? Le système peut-il relier les informations à travers les relations d'entreprise, comprendre la personne et le processus derrière la tâche, faire avancer l'apprentissage, choisir et utiliser les bons outils, et déterminer si le travail a été réalisé avec succès et conformément à la politique de l'entreprise ?
Comment le fournisseur assure-t-il la sécurité des données indexées ? L'index peut-il refléter les permissions des systèmes sources ? Comment le fournisseur protège-t-il contre les données sensibles qui pourraient ne pas être correctement autorisées au sein d'une organisation ?
Glean construit sur cette fondation depuis 2019. La norme n'est pas de savoir si un fournisseur dispose d'un index. C'est de savoir s'il a construit le système de contexte dont l'IA a besoin pour comprendre l'entreprise et mener à bien un travail réel.
