
Depuis que l'IA générative et les LLM occupent le devant de la scène dans le monde entier, les professionnels se demandent comment appliquer au mieux ces nouveaux outils transformateurs à leurs flux de travail. Toutefois, beaucoup d'entre eux ont rencontré des problèmes similaires en tentant d'intégrer l'IA générative dans des environnements d'entreprise : atteintes à la confidentialité, manque de pertinence et besoin d'une meilleure personnalisation des résultats obtenus.
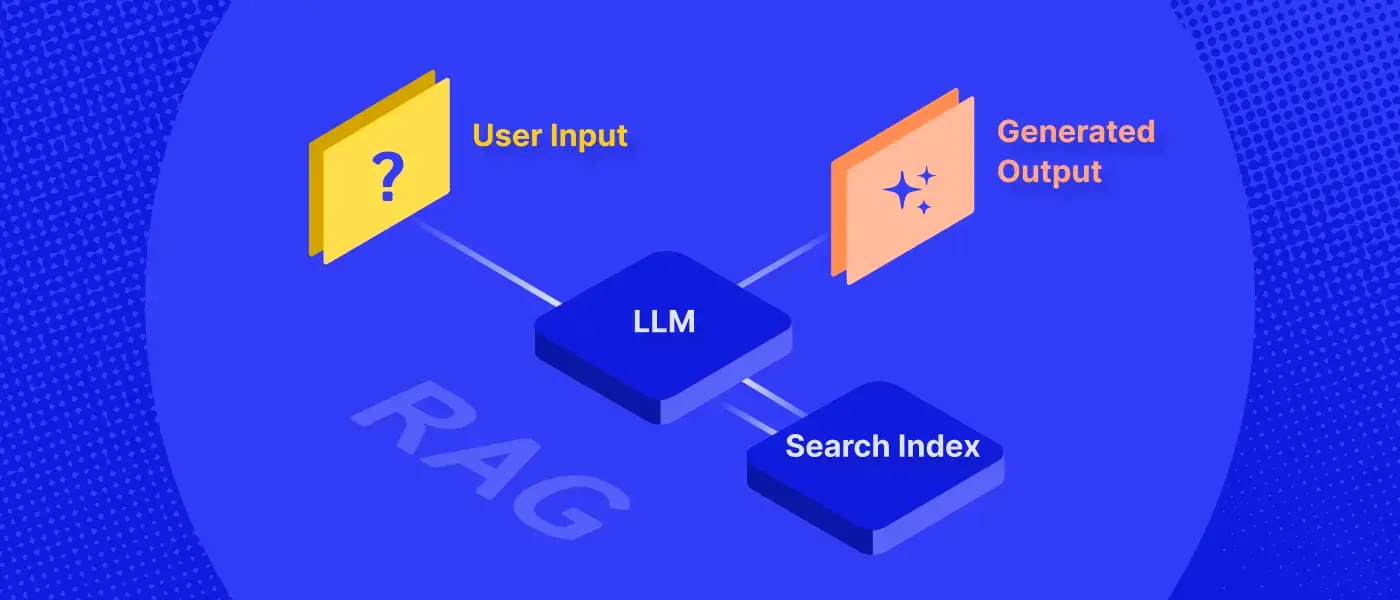
Pour y remédier, la plupart ont conclu que la réponse résidait dans la génération augmentée par récupération (RAG). Le RAG sépare la récupération des connaissances du processus de génération grâce à des systèmes de découverte externes comme la recherche d'entreprise. Cela permet aux LLM et aux réponses qu'ils fournissent de s'appuyer sur de véritables connaissances d'entreprise externes, qui peuvent être facilement mises en évidence, retracées et référencées.
La recherche vectorielle ou lexicale seule ne suffit pas
Maintenant que les entreprises comprennent que les solutions d'IA générative nécessitent une solution de récupération distincte, beaucoup se demandent — pourquoi ne pas simplement placer notre contenu dans une base de données vectorielle et mettre en œuvre un simple prompt RAG ? La réponse n'est malheureusement pas si simple, en particulier lorsqu'il s'agit d'offrir une expérience véritablement adaptée à l'entreprise.
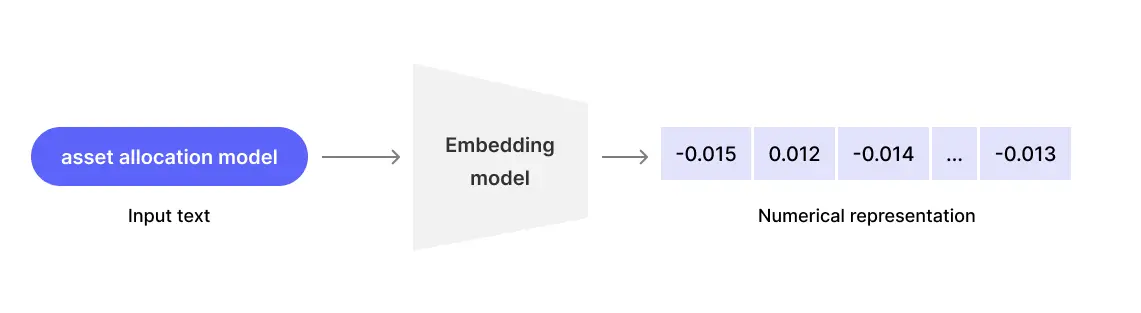
Explorons brièvement le fonctionnement de la recherche vectorielle et des bases de données pour l'indexation et la récupération des données. Les modèles d'embedding associent efficacement un texte spécifique à un vecteur fixe de nombres — à partir d'un ensemble de mots, le modèle attribue une valeur numérique qui le représente au sein de la base de données. Ensuite, à partir du texte d'une requête, le système peut calculer à quel point le texte de la requête est « proche » des textes de documents préindexés dans cet espace vectoriel, qu'il extrait ensuite pour les afficher dans les résultats.
Cette étape ne devrait servir qu'au processus de récupération de l'information. Les LLM sont ensuite strictement utilisés comme une couche de raisonnement pour d'abord appeler le moteur de recherche/récupération, lire un contexte limité, puis distiller et générer des réponses cohérentes à partir des bonnes informations issues de la base de données vectorielle.
Bien que les améliorations de la recherche vectorielle marquent un changement fondamental dans la compréhension sémantique, elles ne représentent qu'une petite pièce du puzzle lorsqu'il s'agit de fournir des résultats de haute qualité pour la recherche d'entreprise. À elle seule, une simple recherche vectorielle est incapable de reconnaître les connexions plus complexes entre l'ensemble du contenu, des personnes et des activités au sein d'une organisation.
Plus anciens encore sont les simples systèmes de recherche lexicale, qui font plutôt correspondre directement les termes de la requête au contenu des documents et aux termes de métadonnées. Bien que faciles à mettre en œuvre, ils ne sont capables d'utiliser que les correspondances exactes de mots ou d'expressions dans une base de données, ce qui pose de sérieuses limites — en particulier face aux erreurs humaines lors de la formulation des requêtes.
Des résultats améliorés grâce à la recherche hybride
La recherche hybride s'impose en entreprise parce qu'elle offre à la fois précision et rappel. La précision provient de la correspondance par mots-clés qui capture le terme exact, l'identifiant ou le titre saisi par l'utilisateur. Le rappel provient de la correspondance sémantique qui fait remonter les documents pertinents même lorsque la formulation diffère. Vous avez besoin des deux lorsque vos données s'étendent aux messages Slack, aux documents, aux tickets et aux wikis.
Un système de recherche hybride peut combiner les atouts des deux. La solution complexe de RAG de Glean dispose de quatre différenciateurs techniques fondamentaux qui distinguent sa recherche hybride et son IA générative :
- Un cadre de graphe de connaissances pour toutes les données d'entreprise, avec des ancres et des signaux propriétaires qui alimentent la recherche
- Un crawler riche et évolutif se connectant à toutes les données d'entreprise et aux règles de permission
- Des niveaux pour contrôler et optimiser le LLM vers l'interface de recherche de Glean
- Une optimisation de l'expérience utilisateur de bout en bout
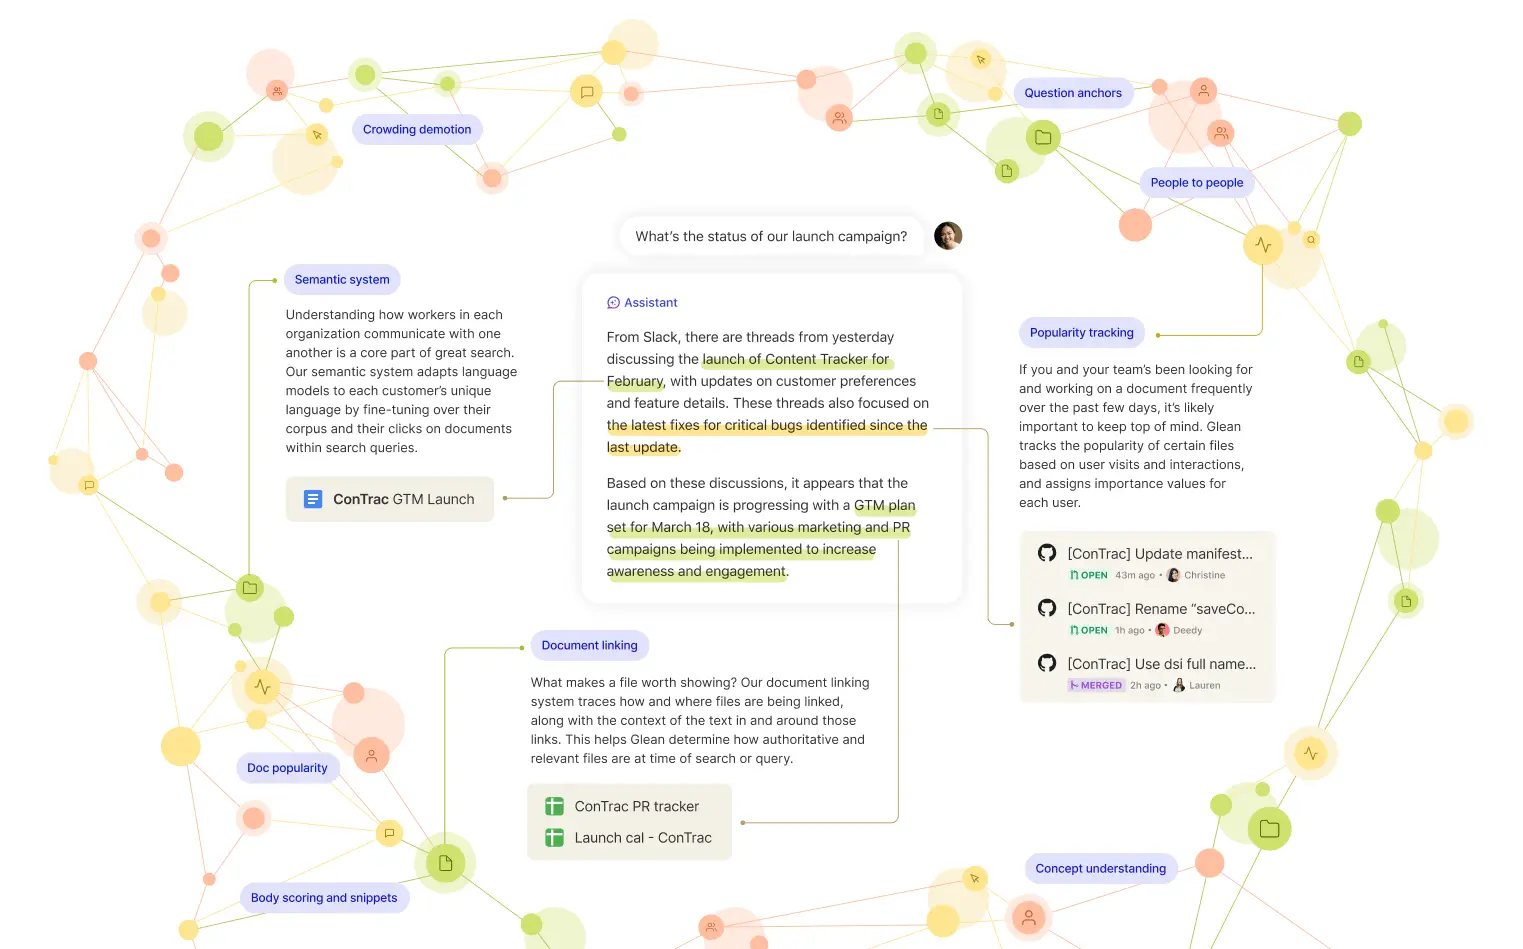
Au cœur des résultats de Glean se trouve le graphe de connaissances, un réseau de signaux et d'ancres qui travaillent de concert pour résoudre les problèmes auxquels un développeur doit faire face. Ces facteurs confèrent à Glean le contexte riche qui entoure les documents, les personnes et les activités au sein d'une organisation, ce qui aide les modèles à fournir de meilleurs résultats. Les signaux et les ancres sont comme les indices dont vous avez besoin pour résoudre une énigme. Plus une solution dispose d'éléments à exploiter, meilleur est le résultat.
Par exemple, les signaux de Glean résolvent activement des problèmes individuels de recherche et de personnalisation tels que :
- La normalisation (tokenisation, racinisation, lemmatisation)
- La synonymie (extraction, scoring contextuel, acronymes)
- L'annotation structurée (extraction et scoring de concepts et d'entités)
- L'internationalisation
- La classification des intentions
- La compréhension des documents (termes saillants, modélisation thématique, gestion des modèles, classification des documents)
- La récupération et la pertinence thématique (recherche sémantique, pondération des termes, optionalisation, mixage de termes, ancres, clickboost, optimisation hybride)
- La popularité (personnalisation, obsolescence/fraîcheur, modélisation par département)
- Etc.…
Alors, quelle est la différence entre un système doté d'une solution complexe de RAG et un système qui en est dépourvu ? Voici un exemple rapide de résultats générés.
Chez Glean, Scholastic est notre approche pour intégrer la recherche sémantique dans les piles de classement, axée sur la récupération et le scoring basés sur les titres, les ancres et les en-têtes. Voici ce qu'une solution RAG standard pourrait répondre comparé à Glean lorsqu'on l'interroge sur Scholastic :
Alors, quelle est la différence notable entre un système doté d'une solution RAG complexe et un système qui en est dépourvu ? Prenons un exemple rapide de quelques résultats générés.
Chez Glean, Scholastic constitue notre approche pour intégrer la recherche sémantique dans les piles de classement, en mettant l'accent sur la récupération et le scoring basés sur les titres, les ancres et les en-têtes. Voyons ce qu'une solution RAG standard pourrait répondre par rapport à Glean lorsqu'on l'interroge sur Scholastic :
Standard (vectoriel, RAG simple)
Q : Qu'est-ce que Scholastic ?
R : Scholastic, basé à New York, dans l'État de New York, est un éditeur et distributeur de livres pour enfants, de technologies éducatives et de services connexes…
Glean (hybride, RAG complexe)
Q : Qu'est-ce que Scholastic ?
R : Scholastic est notre système de récupération et de scoring basé sur des vecteurs appris (un clin d'œil à notre système basé sur les mots-clés, Elastic). Il apprend les embeddings d'items pour les documents et les messages, et récupère/score les plus proches voisins pour une requête donnée...
La réponse standard est totalement hors sujet pour une requête professionnelle, tandis que la réponse de Glean comprend la mission et fournit exactement ce que l'utilisateur recherche.
Qu'il s'agisse de réponses fournies par l'IA générative ou de résultats proposés au sein d'une recherche, les solutions de recherche hybride et de RAG complexe, enrichies par des réseaux de signaux et d'ancres, offrent indéniablement de meilleurs résultats que les solutions de recherche lexicale ou vectorielle incomplètes. La capacité d'exploiter les données propriétaires comme clés et indices pour affiner les modèles fournit la contextualisation riche dont les environnements d'entreprise ont besoin de la part des solutions de recherche et d'IA générative.
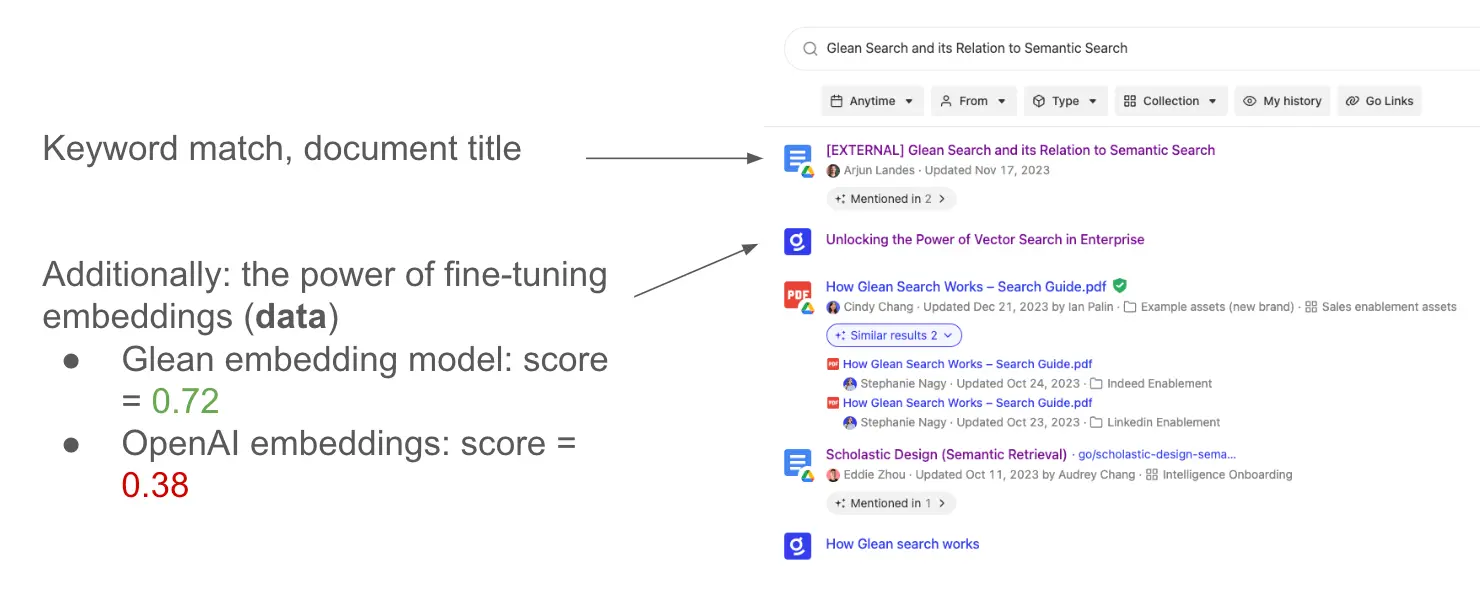
Dans le domaine de la recherche d'entreprise, il est également évident que s'appuyer uniquement sur la recherche vectorielle ou sémantique ne donne pas toujours les résultats les plus optimaux. C'est particulièrement vrai dans les scénarios où la précision est requise, par exemple lors de la recherche de termes, de documents ou de mots-clés spécifiques. La recherche vectorielle, avec son imprécision inhérente, ne correspond pas toujours à la précision requise dans ces cas.
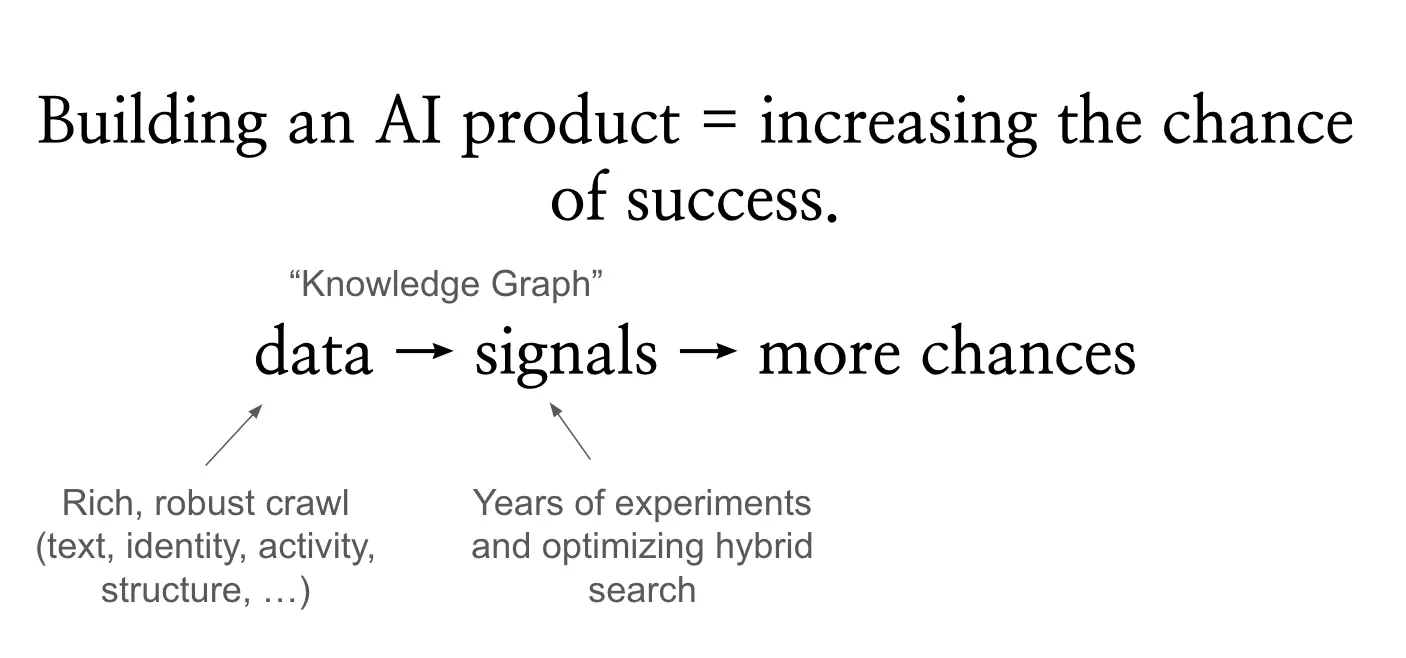
Pour Glean, nos capacités de recherche lexicale se distinguent également par la robustesse de nos données. Cette force nous permet non seulement de faire correspondre les requêtes avec une grande précision, mais aussi de personnaliser les résultats parmi une multitude de correspondances potentielles. L'approche de recherche hybride adoptée par Glean marie le meilleur des deux mondes, en combinant la précision de la recherche lexicale et la compréhension nuancée de la recherche vectorielle, le tout alimenté par le contexte et la nuance supplémentaires fournis par les signaux et les ancres de notre graphe de connaissances.
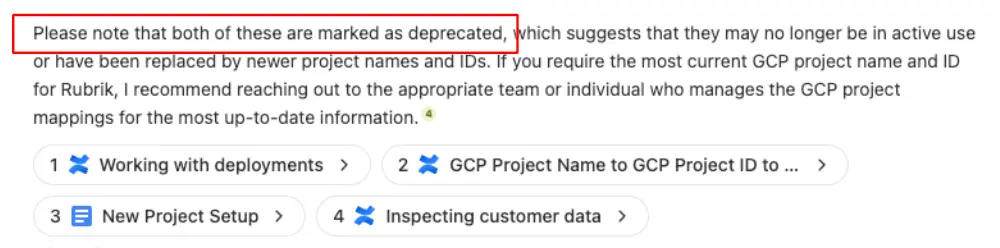
Pour couronner le tout, la capacité de Glean à relier les LLM à notre interface de recherche propriétaire nous permet de gérer les échecs de recherche et de récupération avec bien plus d'élégance. Les LLM intégrés à notre interface de recherche gèrent les échecs de recherche et de récupération avec bien plus de finesse. Par exemple, la plupart des solutions tierces, confrontées à une question à laquelle elles ne peuvent pas répondre de manière adéquate, fournissent souvent des informations de mauvaise qualité qui ne sont ni fraîches ni pertinentes.
Avec Glean, en revanche, les LLM reçoivent le contexte supplémentaire dont ils ont besoin pour clarifier les réserves et les précautions. Ces informations supplémentaires permettent à l'IA de donner aux collaborateurs les éléments dont ils ont besoin pour poursuivre les étapes suivantes, ou pour mieux comprendre pourquoi les informations qu'ils reçoivent peuvent être incomplètes.
La meilleure voie à suivre
Si vous cherchez à garder une longueur d'avance en exploitant dès aujourd'hui le potentiel de l'IA générative, Glean est la meilleure solution pour y parvenir. Glean respecte toujours les permissions, offre des résultats pertinents et personnalisés, frais et actuels, et s'intègre universellement à vos applications les plus utilisées.
Boostez la productivité de votre équipe avec une solution d'IA générative véritablement prête pour l'entreprise. Inscrivez-vous dès aujourd'hui pour une démo !