







Glean est utilisé pour des tâches allant de simples recherches à un travail approfondi comme l'analyse de données, la création de contenu et la prise d'actions. Bien que nous ayons historiquement utilisé des modèles de pointe pour les tâches de recherche, nous avons récemment constaté que des modèles spécialisés peuvent accomplir ce travail plus efficacement. C'est pourquoi nous présentons le premier modèle de recherche agentique de Glean, surnommé Waldo, qui décide comment décomposer la question, quels outils utiliser, quoi lire ensuite et à quel moment il dispose de suffisamment d'éléments pour transmettre la main à un modèle de pointe afin de fournir une réponse de haute qualité.
Nous pensons que l'avenir de l'IA d'entreprise ne repose pas seulement sur des outils spécialisés, mais aussi sur des modèles spécialisés conçus pour des tâches bien définies et à forte demande, où la latence et le coût peuvent être optimisés. Si les modèles de pointe peuvent gérer seuls la récupération d'informations, cela s'avère souvent plus lent et plus coûteux que nécessaire. La meilleure approche consiste à utiliser un modèle dédié, comme Waldo, qui travaille de concert avec les modèles de pointe pour produire des résultats agentiques de bout en bout.
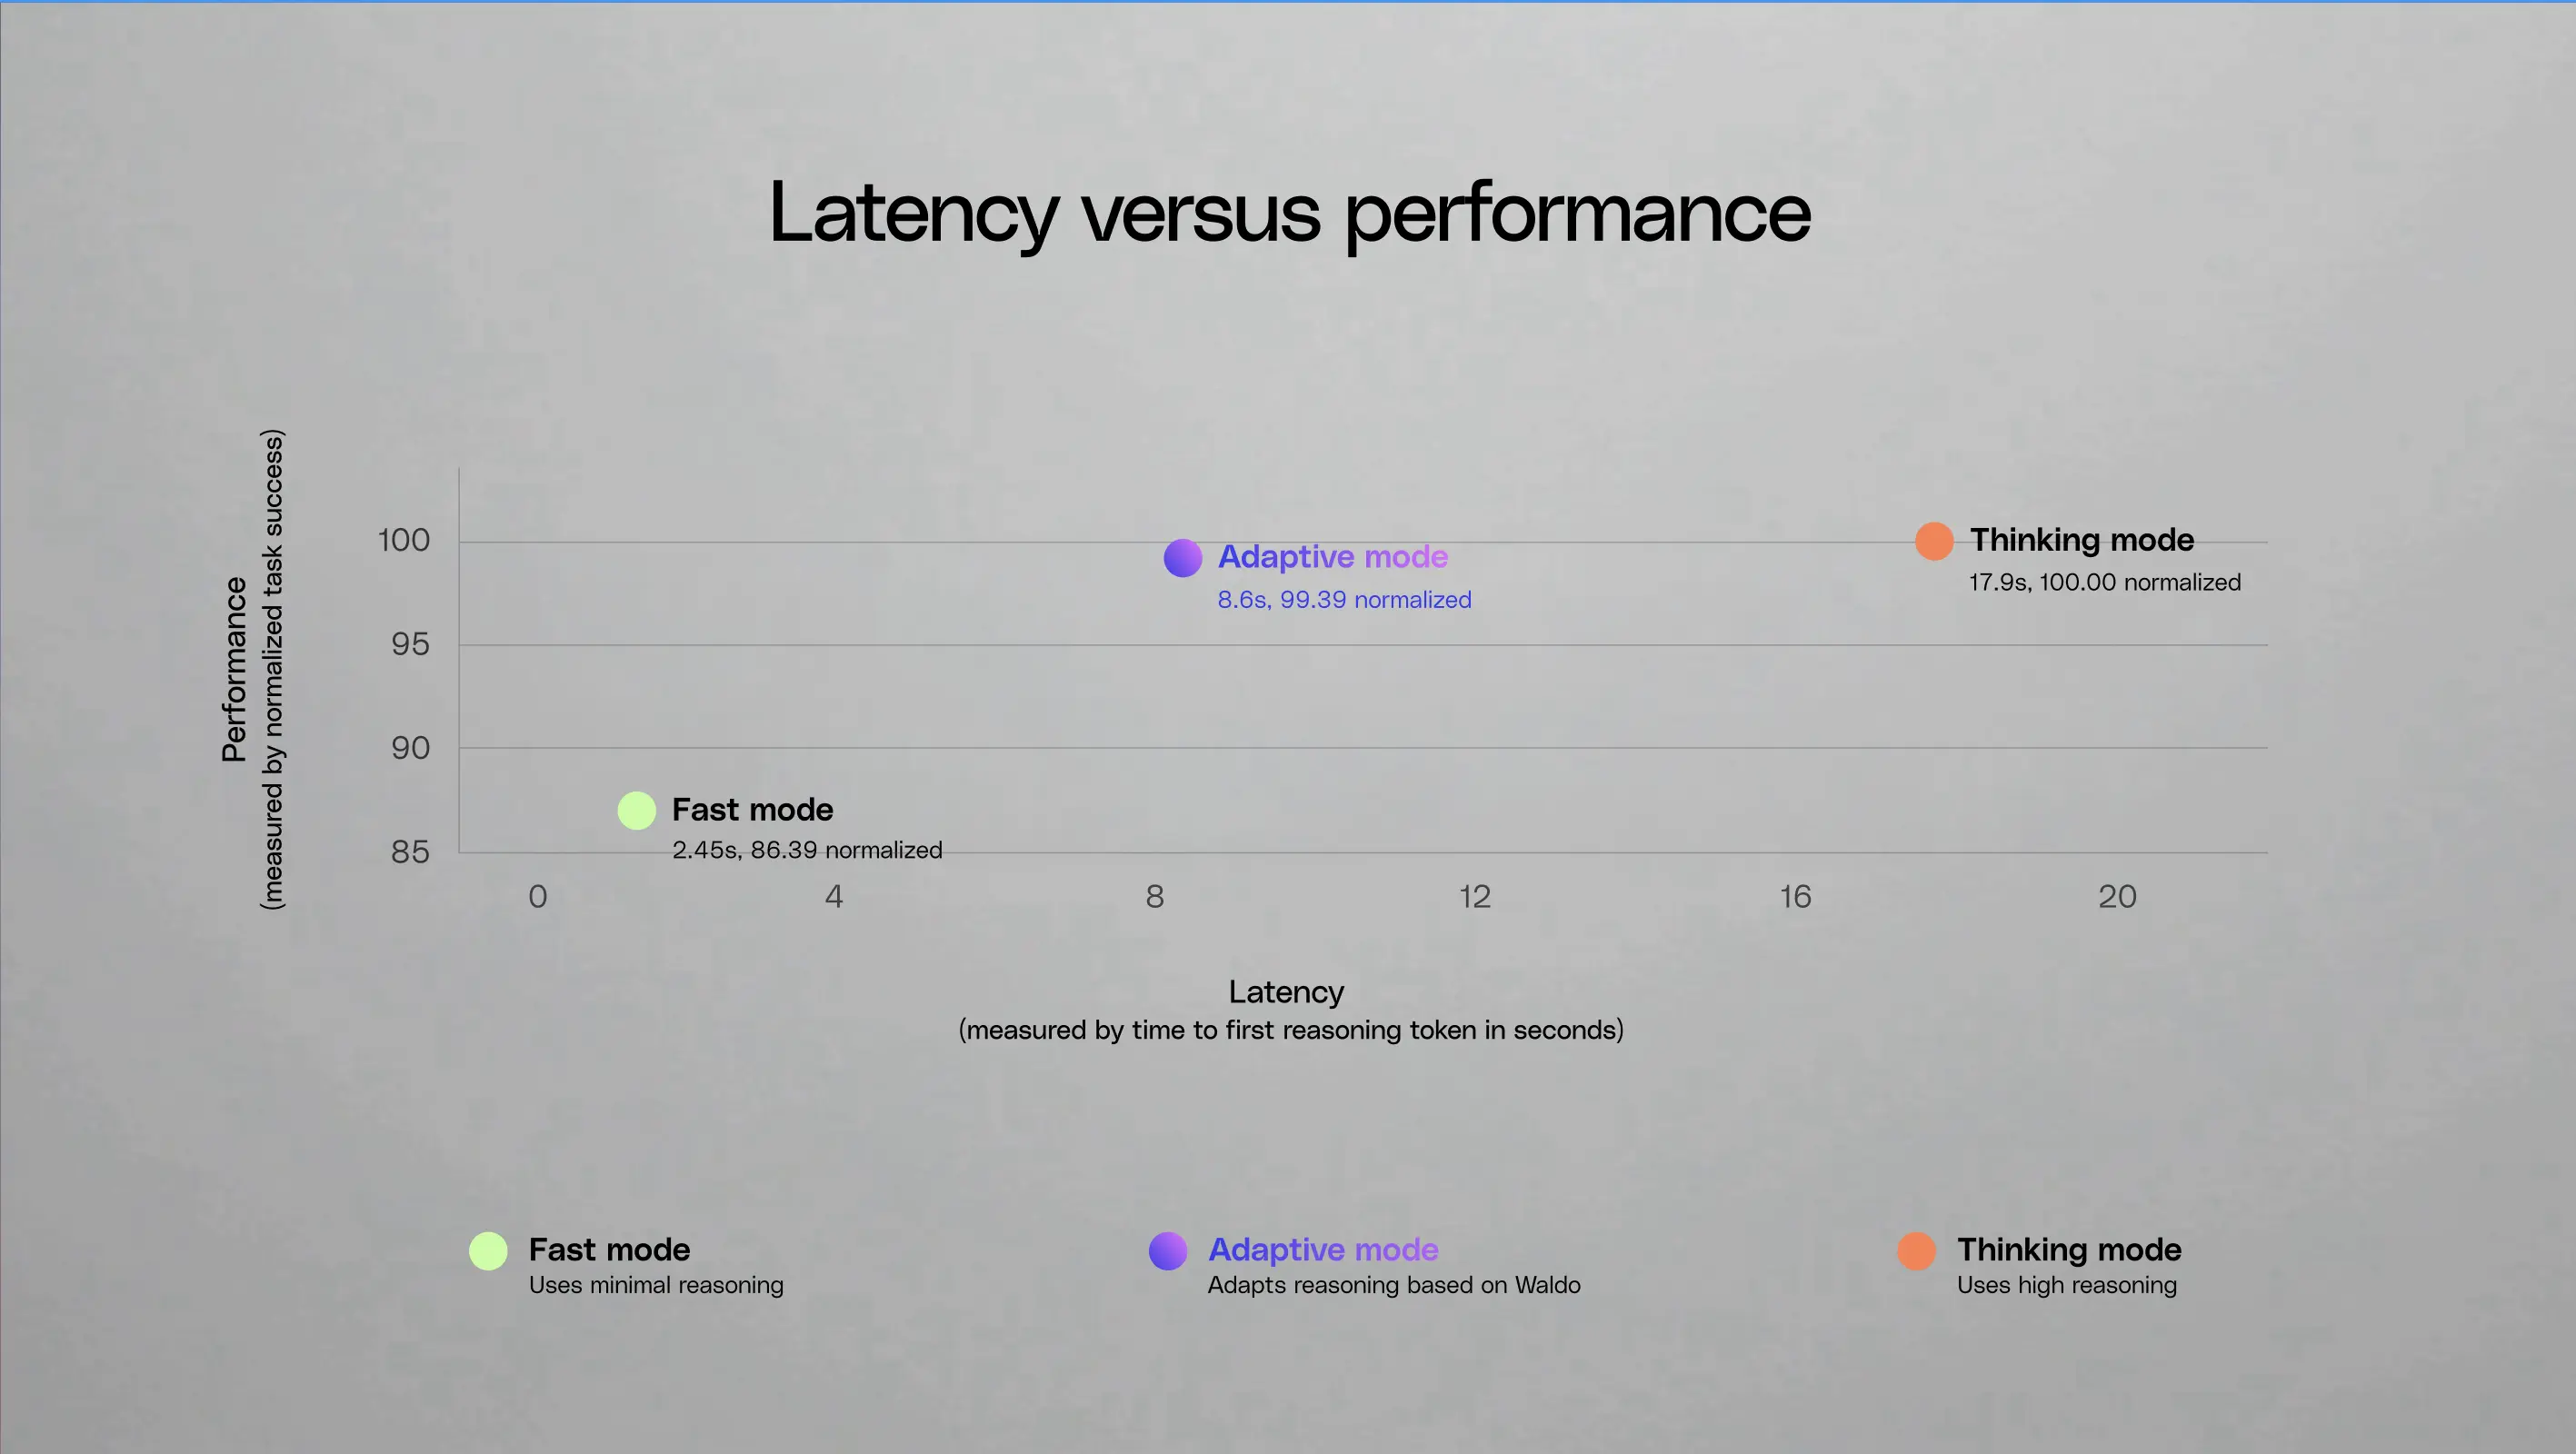
Waldo ne se contente pas de recueillir des informations. En s'exécutant en premier et en constituant un contexte avant même que le modèle de pointe ne voie la requête, il devient un élément naturel de la décision concernant le niveau de raisonnement requis pour la tâche : cette requête nécessite-t-elle une réponse rapide et légère, ou doit-elle être escaladée vers un niveau de raisonnement supérieur ? Le contexte fourni par Waldo, notamment les outils utilisés, le nombre de recherches et la correspondance sémantique de la requête avec des tâches à forte et à faible complexité, aide à déterminer le niveau de raisonnement requis.
À lui seul, Waldo est plus de 10 fois plus rapide que notre modèle de raisonnement par défaut (GPT-5.4 medium) pour chaque appel au LLM, avec des améliorations de latence moyennes d'environ 250 ms contre environ 3 s. Intégré à notre harnais, cela se traduit par une latence réduite d'environ 50 % et environ 25 % de tokens en moins, sans régression de qualité. Conçu pour la recherche d'entreprise, Waldo utilise NVIDIA Nemotron 3 Nano comme modèle de base et est post-entraîné pour la planification de recherche.
Cet article explique comment nous avons conçu Waldo, comment nous l'avons entraîné et les décisions de conception que nous avons prises en cours de route.
La plupart des tâches en entreprise commencent par une recherche
Lorsque nous avons analysé les schémas de requêtes dans Glean, un élément est ressorti : quelle que soit la complexité de l'objectif final, la plupart des tâches commencent par une recherche. Lorsqu'un utilisateur a besoin d'informations sur un projet, un client, un processus ou une décision, Glean effectue des recherches dans les documents internes, lit les résultats et synthétise une réponse. Parfois, cela nécessite une seule recherche ; souvent, cela demande plusieurs boucles itératives de lecture d'un résultat, d'affinage de la requête et de nouvelle recherche. Même les tâches qui nécessitent finalement la création de documents, l'exécution de flux de travail ou des actions inter-systèmes commencent par cette phase de collecte de contexte.
Les modèles de pointe gèrent bien cela, mais ils accomplissent deux tâches très différentes en même temps : planifier ce qu'il faut rechercher et raisonner sur ce qu'ils ont trouvé pour générer une réponse. La première tâche est relativement mécanique : correspondance de schémas sur l'intention de la requête, sélection d'outils et suffisance des éléments. La seconde tâche requiert un raisonnement approfondi, une synthèse à long contexte et une génération nuancée. Regrouper ces deux tâches dans un seul modèle coûteux signifie que vous payez le prix d'un modèle de pointe pour la planification de recherche, et que vous ajoutez de la latence à chaque tour de boucle.
Lorsque vous disposez d'une tâche bien définie qui s'exécute à grand volume, nous avons constaté qu'il vaut la peine de l'isoler dans un modèle plus petit, spécifiquement entraîné, plutôt que d'utiliser un modèle de raisonnement polyvalent. Le coût du modèle de pointe est mieux employé pour la synthèse et la génération de réponses.
Waldo est un modèle de recherche agentique
Waldo est un modèle de recherche agentique entraîné par apprentissage par renforcement qui s'exécute avant qu'un modèle de pointe ne soit invoqué. Son rôle est d'exécuter de courts plans d'outils sur un ensemble d'outils fixe, incluant Glean Search, la recherche d'employés et la recherche web, puis de transmettre le contrôle au modèle de pointe avec le contexte récupéré déjà en place.
Waldo effectue des recherches jusqu'à ce qu'il dispose d'un contexte suffisant ou qu'il reconnaisse que la tâche nécessite des capacités allant au-delà de la recherche (création de documents, exécution de code, outils d'écriture). Une fois terminé, il ne génère pas de langage naturel. Il transmet le contrôle au modèle de pointe, qui perçoit la conversation comme s'il avait lui-même effectué le travail de recherche : mêmes messages, mêmes sorties d'outils.
La décision architecturale clé a été de faire fonctionner Waldo comme une étape initiale plutôt que de laisser le modèle de pointe l'invoquer en tant que sous-agent. Nous avons envisagé l'approche par sous-agent car elle rend l'histoire de l'orchestration plus claire, mais la latence était trop importante. Dans la conception par sous-agent, même une simple requête à une seule recherche nécessite trois étapes d'inférence en série : le modèle de pointe décide d'appeler Waldo, Waldo effectue la recherche, puis le modèle de pointe génère la réponse. Faire de Waldo le premier modèle appelé peut aboutir au scénario optimal d'un seul appel au modèle de pointe, puisque Waldo a déjà effectué le travail.
Entraînement : DPO + apprentissage par renforcement
Notre pipeline d'entraînement comporte deux phases : un échauffement supervisé suivi d'un apprentissage par renforcement avec un signal de récompense spécifique à la tâche. Nous avons utilisé l'API Tinker de Thinking Machine Labs pour un fine-tuning basé sur LoRA, ce qui nous a permis d'adapter efficacement le modèle sans gérer d'infrastructure d'entraînement distribué.
Waldo est un planificateur de recherche. Il décide quelles requêtes exécuter et quand s'arrêter, mais la qualité réelle de la récupération provient de l'infrastructure de recherche existante de Glean, fruit d'années de travail à construire des modèles de recherche sémantique d'entreprise qui apprennent le langage d'une entreprise et un Graphe d'entreprise qui comprend les relations entre les personnes, le contenu et les systèmes. Rien de tout cela n'est remplacé par Waldo ; au contraire, il vient l'enrichir. Ce que Waldo doit apprendre, c'est la couverture : combien de recherches exécuter, comment varier les requêtes et quand les éléments récupérés sont suffisants.
Phase 1 : Optimisation directe des préférences (DPO)
La première phase utilise le DPO pour amener le modèle de base dans le bon espace comportemental. Le DPO fonctionne en s'entraînant sur des paires de préférences : pour chaque requête, le modèle voit une sortie « préférée » et une sortie « rejetée », et apprend à attribuer une probabilité plus élevée à la sortie préférée. Au fil de nombreuses paires, le comportement du modèle évolue vers la distribution préférée sans nécessiter de fonction de récompense explicite.
Nous construisons ces paires à partir de traces de production de haute qualité et anonymisées, issues du propre déploiement de Glean. Fait important, Waldo ne s'entraîne jamais sur les données clients ni sur le contenu des documents. Les traces ne capturent que les schémas d'utilisation des outils : quels outils ont été appelés, dans quel ordre, et si le plan a réussi. Pour le côté préféré de chaque paire, lorsque le système de production utilise des outils principaux (recherche, lecteur de documents), nous extrayons le plan d'outils. Lorsque la tâche ne nécessite pas d'outils principaux, la sortie préférée est un signal de transmission ou de passage direct. Pour le côté rejeté, nous échantillonnons les sorties du modèle de base et filtrons les cas qui diffèrent de manière non triviale du comportement de production.
Il s'agit d'un modèle entraîné sur la façon d'utiliser les outils, et non sur les données d'entreprise. Son objectif est le conditionnement : enseigner au modèle le vocabulaire de base du « quand rechercher, quand s'arrêter, quand transmettre ».
Phase 2 : apprentissage par renforcement
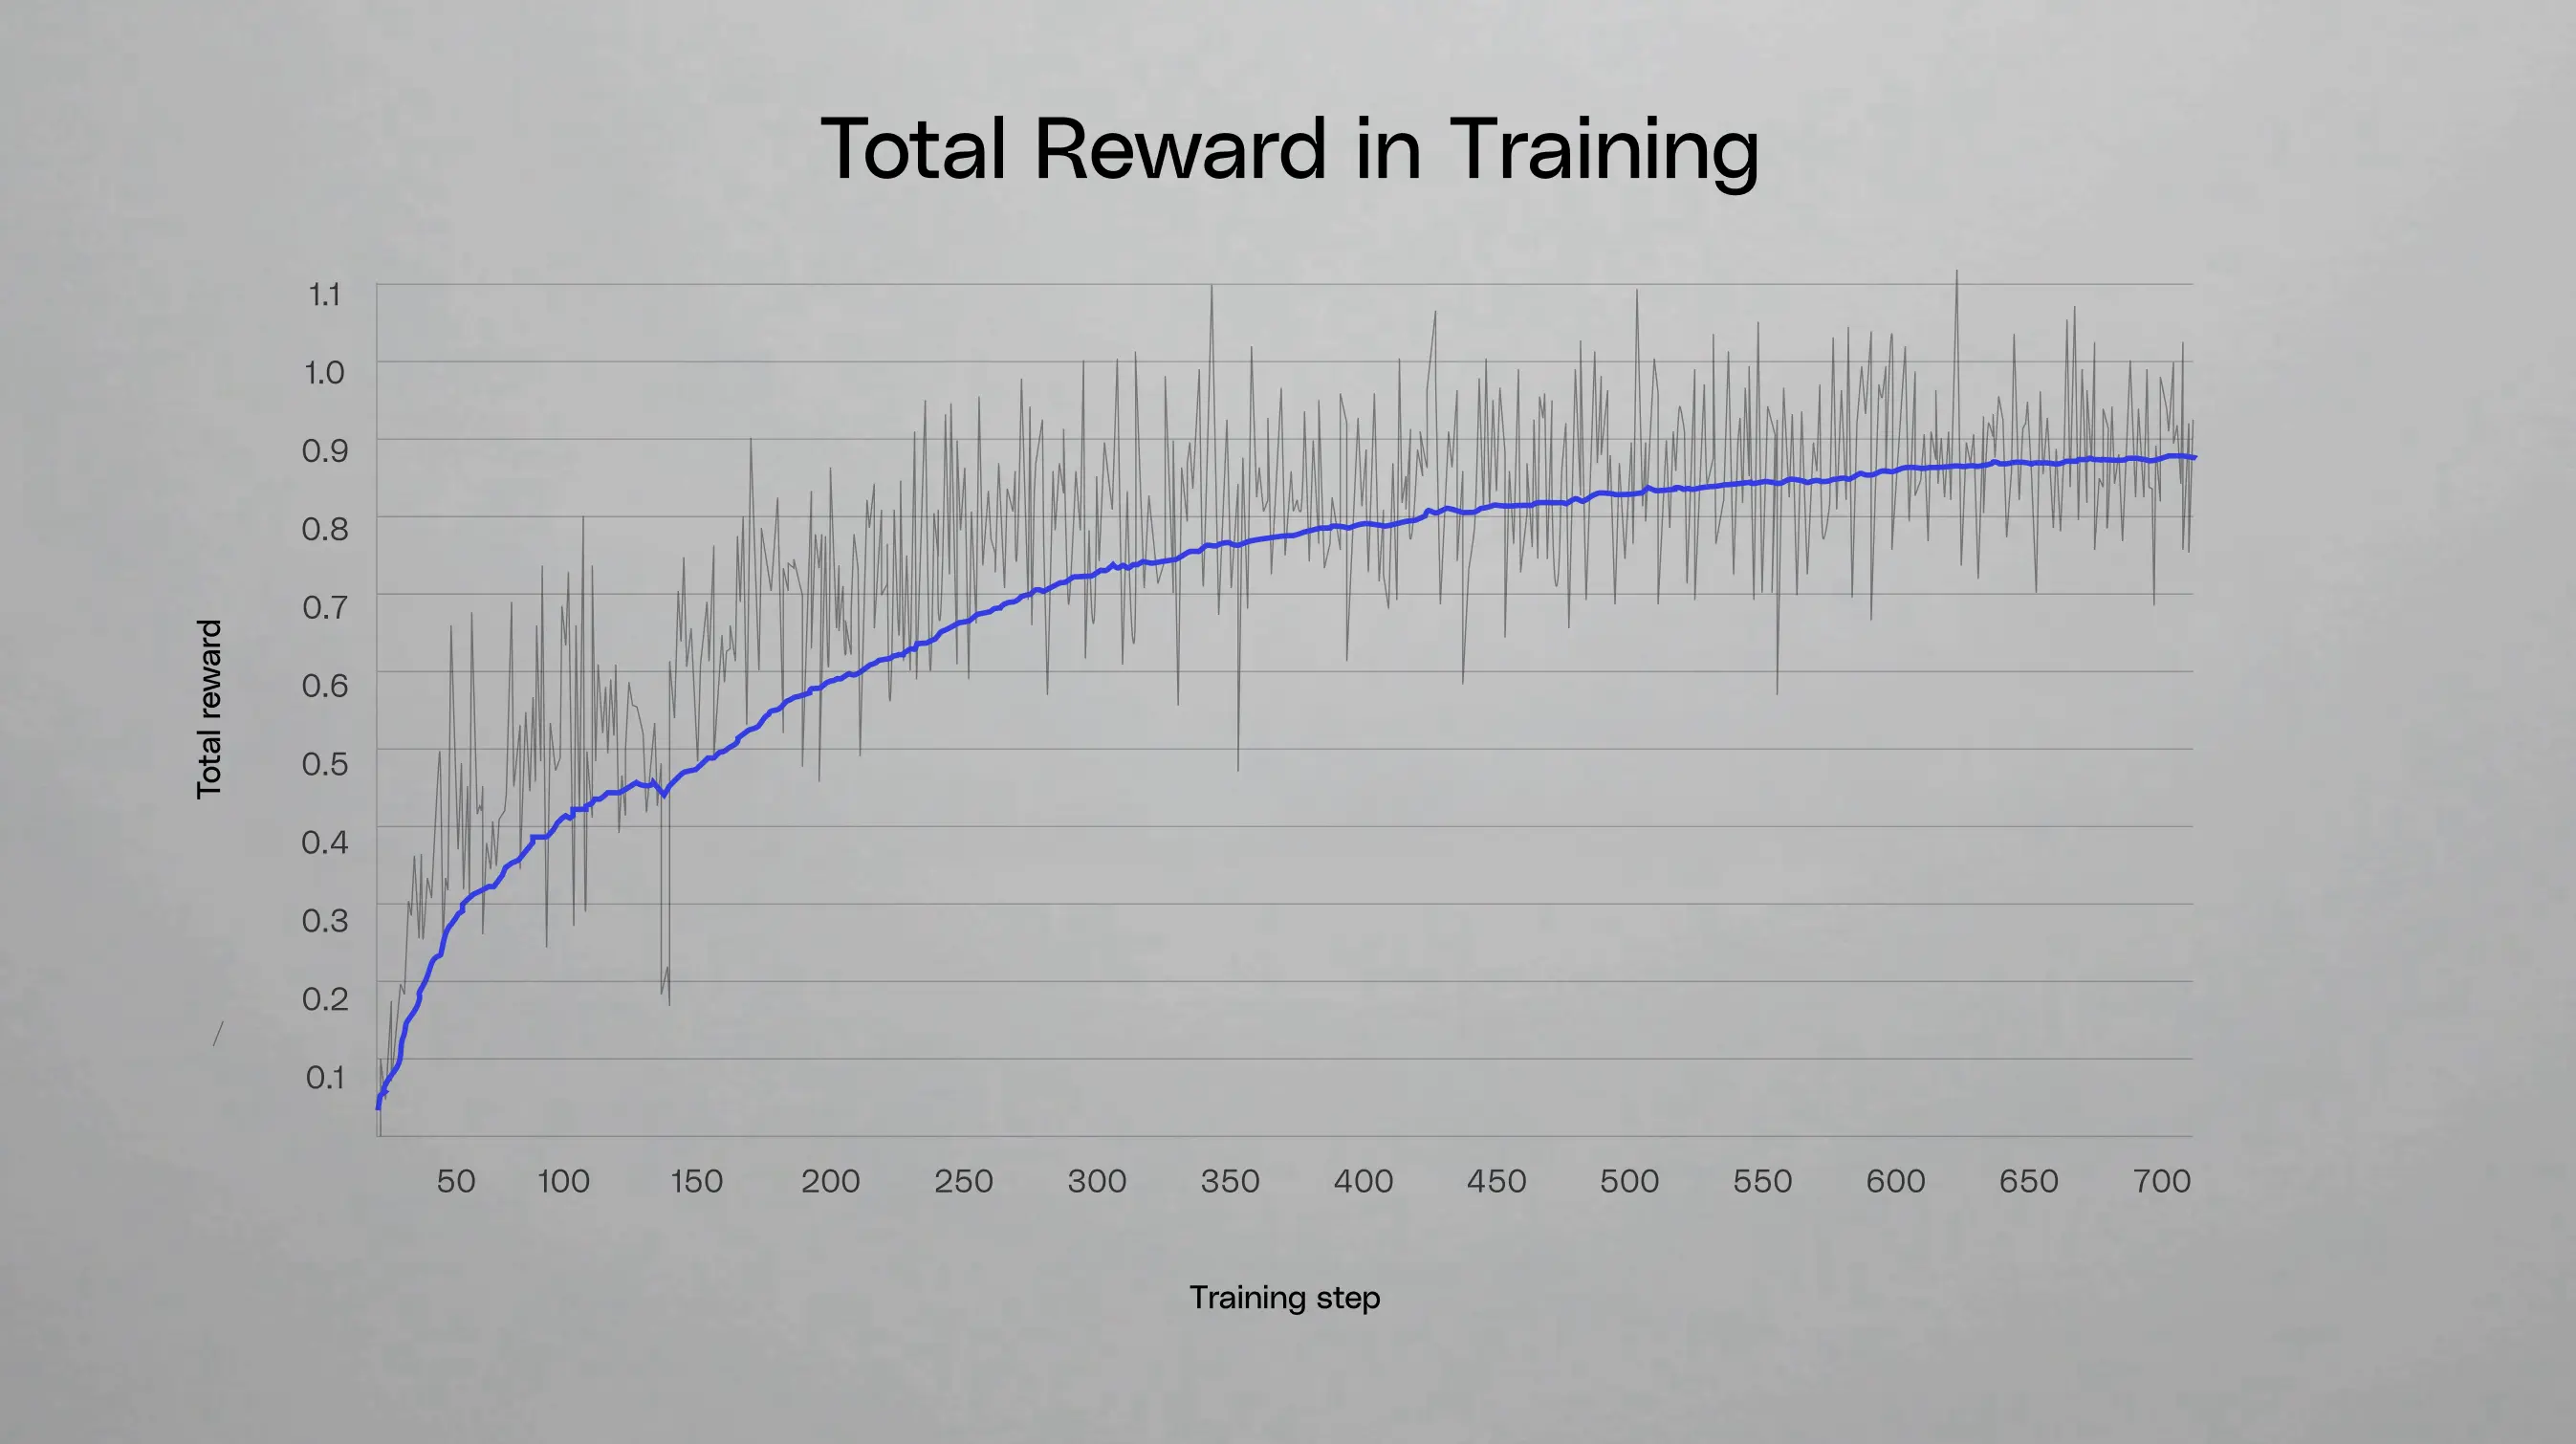
C'est la phase qui permet à Waldo de créer de meilleurs plans que le système de production. Nous déployons le modèle face à des requêtes de production et le récompensons en fonction des résultats.
Pour les requêtes nécessitant une recherche, la récompense comporte deux composantes. Premièrement, un signal binaire de terminaison indiquant si Waldo a déterminé que les outils principaux étaient suffisants ou non. Deuxièmement, un signal de récompense basé sur le rappel/F1 par rapport aux documents que le système de production a cités dans la réponse finale. Une fois que le système complet a produit une réponse finale, nous examinons quels documents il a réellement cités, puis nous remontons en arrière pour nous demander : les recherches de Waldo ont-elles fait remonter ces documents ? Le rappel mesure si Waldo a trouvé tous les documents qui se sont finalement avérés importants. Le F1 équilibre ensuite le rappel et la précision, en pénalisant Waldo s'il récupère beaucoup de bruit en même temps que les documents pertinents.
Ce qui est intéressant, c'est que si le système de production a nécessité plusieurs recherches itératives pour trouver un document, Waldo peut apprendre à le trouver en une seule. Le signal de récompense ne se soucie pas de la manière dont Waldo y est parvenu ; il se soucie de savoir si les bonnes preuves ont été récupérées.
Nous nous entraînons sur des traces de production issues du propre déploiement de Glean, et nous avons constaté que le modèle se généralise bien aux déploiements de clients externes. Le modèle de base est Nemotron 3 Nano (une architecture de mélange d'experts avec 30 milliards de paramètres au total et 3 milliards de paramètres actifs), choisi pour son profil de latence et de coût. Nous avons délibérément choisi d'utiliser Nemotron en mode instruct, plutôt qu'avec du raisonnement, afin de repousser les limites de la latence, car notre environnement de post-entraînement nous permet d'atteindre nos objectifs de qualité sans modèle de raisonnement.
De Waldo au raisonnement adaptatif
Waldo a résolu le problème de la collecte d'informations, mais il a également révélé une seconde opportunité : utiliser les signaux du modèle de recherche agentique pour déterminer dynamiquement le niveau de raisonnement requis par une tâche.
Parce que Waldo s'exécute en premier, sa propre exécution devient la base de cette décision. Il sait combien d'outils il a invoqués, combien de documents sont revenus, et si ses sorties étaient vides ou éparses. En d'autres termes, il sait à quel point il a peiné. Une requête qui a déclenché plusieurs appels d'outils mais a renvoyé peu de contenu pertinent est un signal fort qu'un modèle léger ne suffira pas. Lorsque Waldo détermine que la tâche nécessite des outils au-delà de la recherche pour agir ou exécuter du code, ce signal de transmission devient une autre entrée de routage, que le modèle produit naturellement dans le cadre de son flux de travail. En lisant son propre travail et en le pondérant par rapport à la complexité de la demande initiale, le modèle de recherche agentique décide du niveau de raisonnement nécessaire.
Économies de coûts et de latence grâce aux modèles spécialisés
En combinant Waldo avec un modèle de pointe, Glean a pu offrir une latence inférieure d'environ 50 % et un nombre de tokens inférieur d'environ 25 % tout en maintenant une qualité similaire. Nous avons constaté qu'environ la moitié de toutes les requêtes restent sur une voie rapide avec un raisonnement minimal, n'ont jamais besoin de la pleine capacité d'un modèle de pointe, et ce, sans sacrifier la qualité des réponses.
Nous pensons que ce schéma de petits modèles spécialisés travaillant de concert avec des modèles de pointe deviendra de plus en plus courant à mesure que les systèmes agentiques mûriront. Toutes les tâches du pipeline n'ont pas besoin d'une intelligence de niveau pointe, et le reconnaître constitue une étape significative vers la construction de systèmes à la fois plus performants et plus efficaces.
Disponibilité : Waldo sera bientôt déployé auprès des clients.
