






Les agents sont désormais sur le point de prendre en charge des tâches de bout en bout, de longue durée. Ils peuvent résoudre des tickets d'assistance, écrire du code, pousser des PR et même finaliser des plans de compte commerciaux complets. Mais à mesure que les agents s'attaquent à des tâches plus complexes, ils sont de plus en plus limités par la fenêtre de contexte du modèle. Lorsque vos données saturent la fenêtre de contexte, les agents sont contraints de faire des compromis : plafonner les résultats, résumer de manière agressive ou supprimer des détails, ce qui limite artificiellement la quantité de travail réel qu'ils peuvent accomplir. Même avec des modèles prenant en charge de grandes fenêtres de contexte, nous constatons toujours que les agents perdent leur attention, et le coût des tâches à long contexte reste élevé.
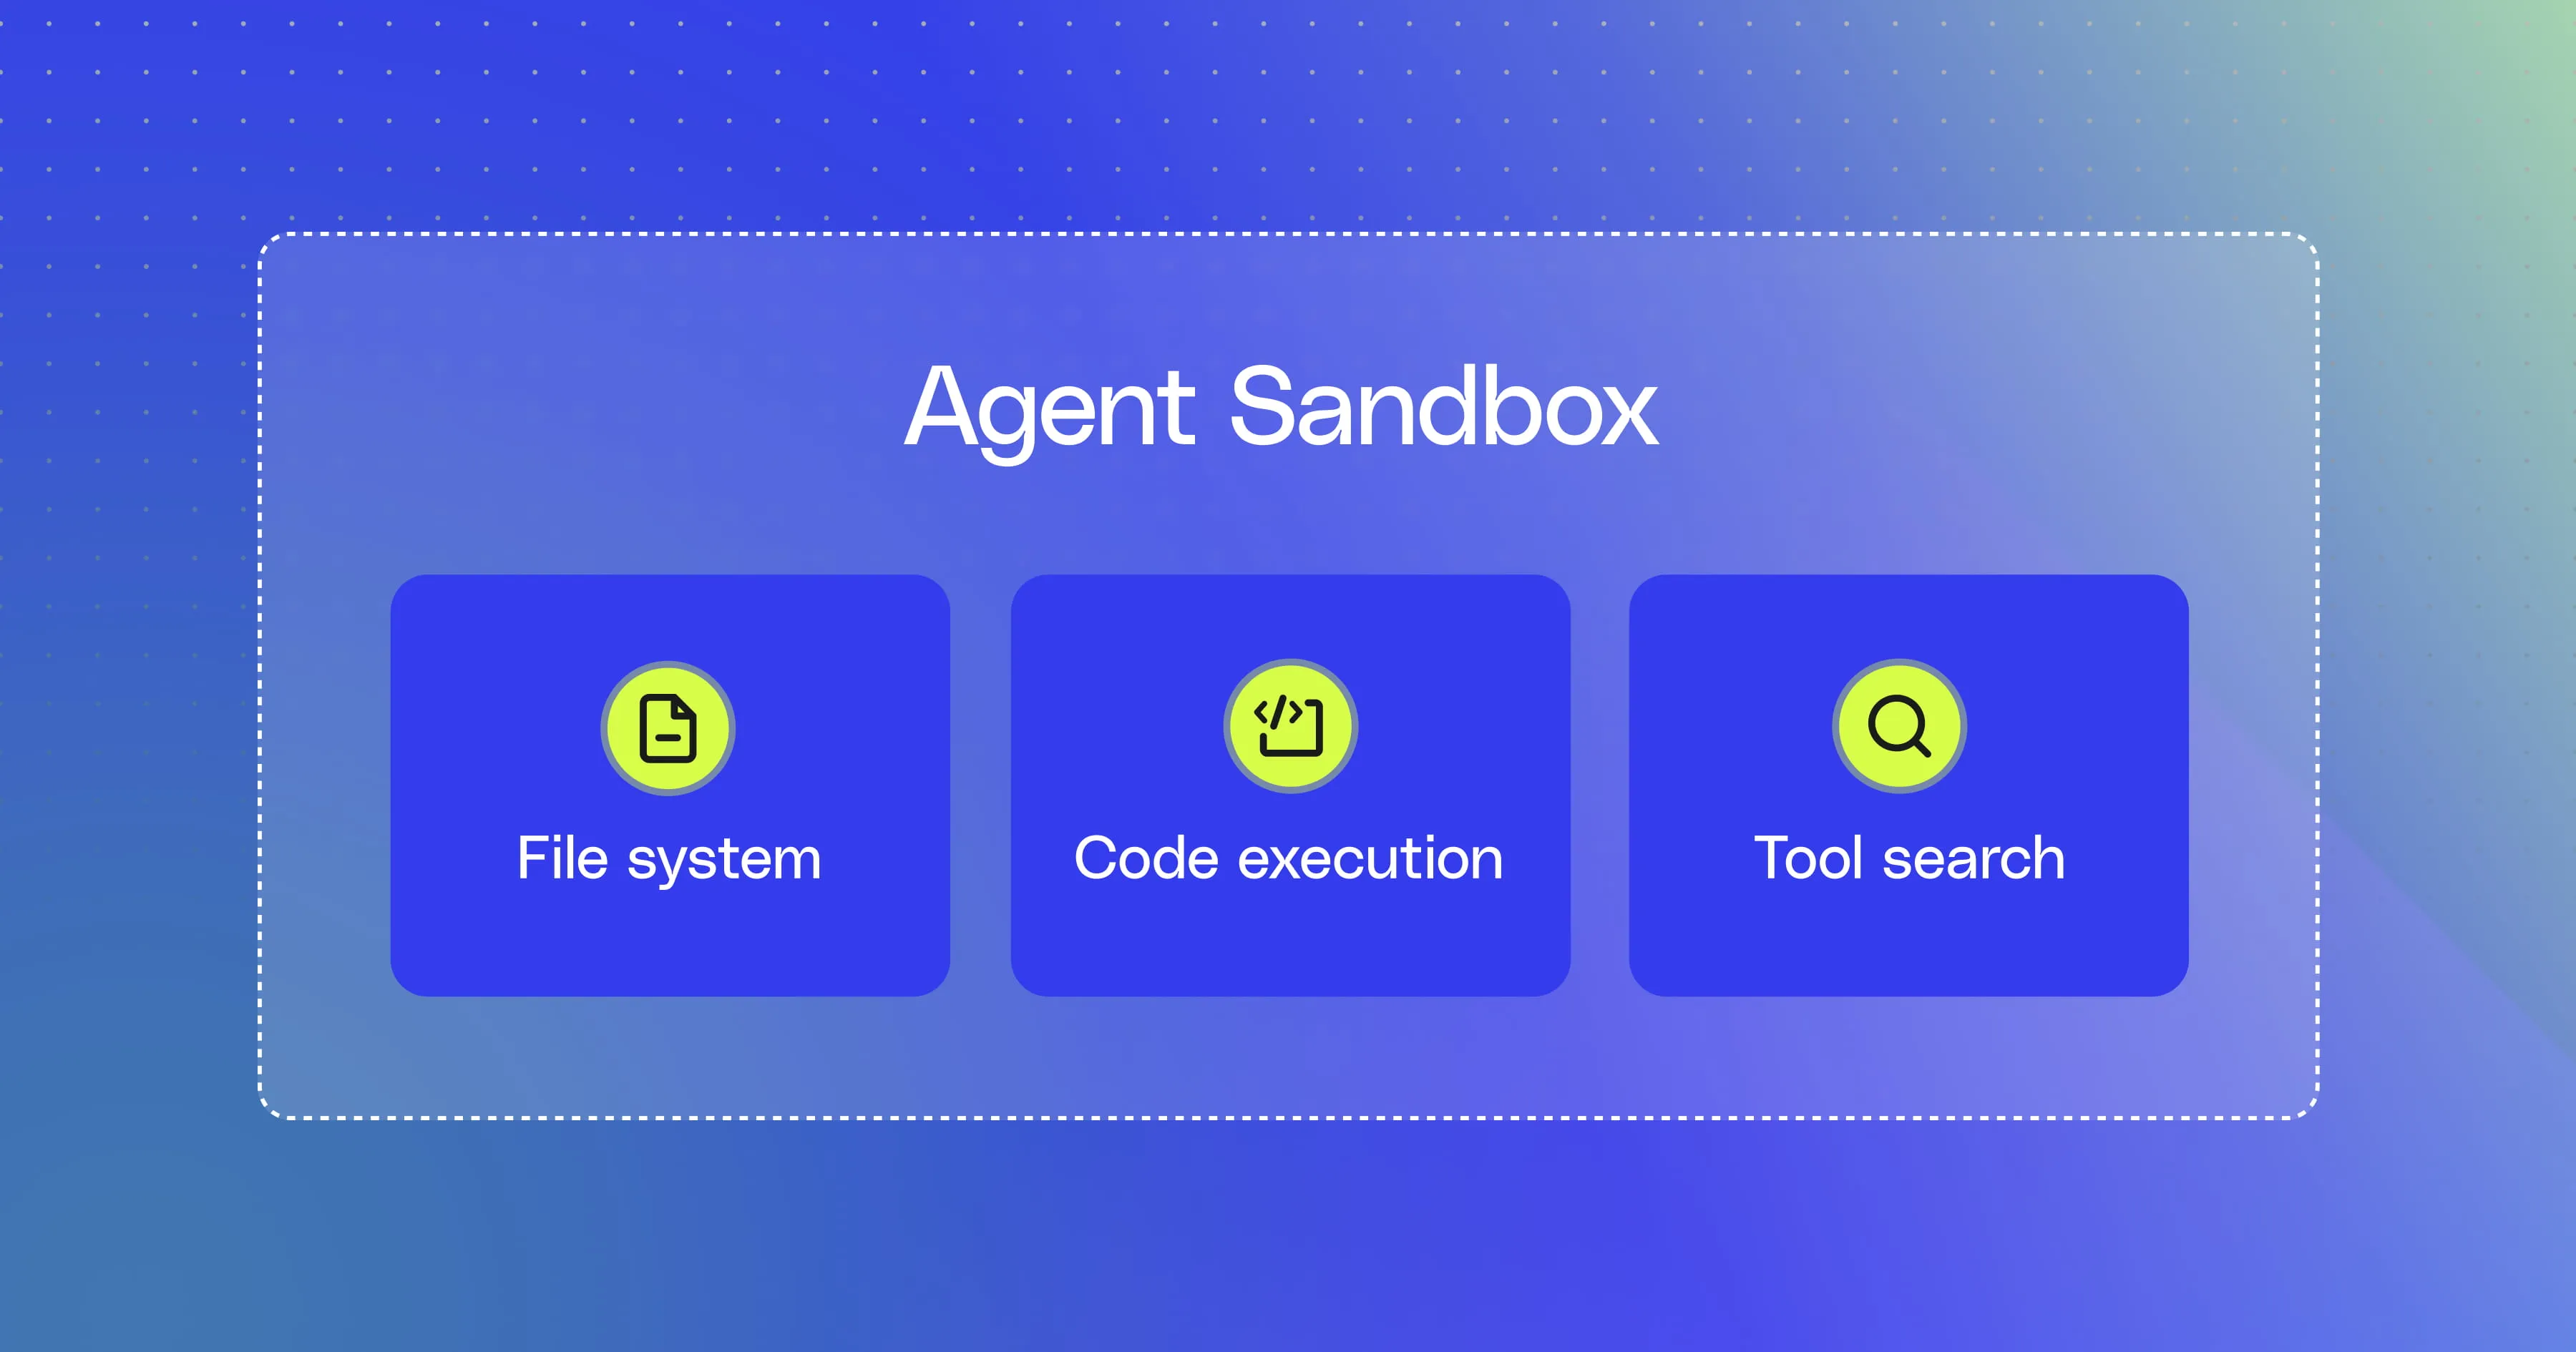
Ce que nous avons découvert, c'est que si vous donnez à un agent un sandbox, un ordinateur virtuel équipé d'un système de fichiers, d'une ligne de commande, d'un environnement d'exécution de code et d'un index d'outils, il peut utiliser cet environnement pour étendre sa mémoire à court terme effective et traiter bien plus de données que ne le permettent les fenêtres de contexte des LLM. Les agents peuvent lire directement les systèmes de fichiers, rendant les données entièrement itérables afin que l'agent puisse extraire ce dont il a besoin à chaque phase d'exécution, plutôt que d'essayer de tout faire tenir dans la fenêtre de contexte.
En entreprise, cela débloque de nouveaux cas d'usage analytiques, notamment l'agrégation de jeux de données à grande échelle qui étaient auparavant hors de portée pour les agents. Dans ce blog, nous allons vous présenter un cas d'usage concret que cela rend possible.
Analyse complète de toutes vos données structurées et non structurées
De nombreuses tâches de routine pour les responsables commerciaux semblent simples : « Passer en revue toutes mes opportunités du T4 pour analyser la santé du pipeline. » En réalité, cela nécessite de rassembler des milliers de points de données provenant des systèmes d'enregistrement et des applications de productivité pour obtenir une vue d'ensemble complète.
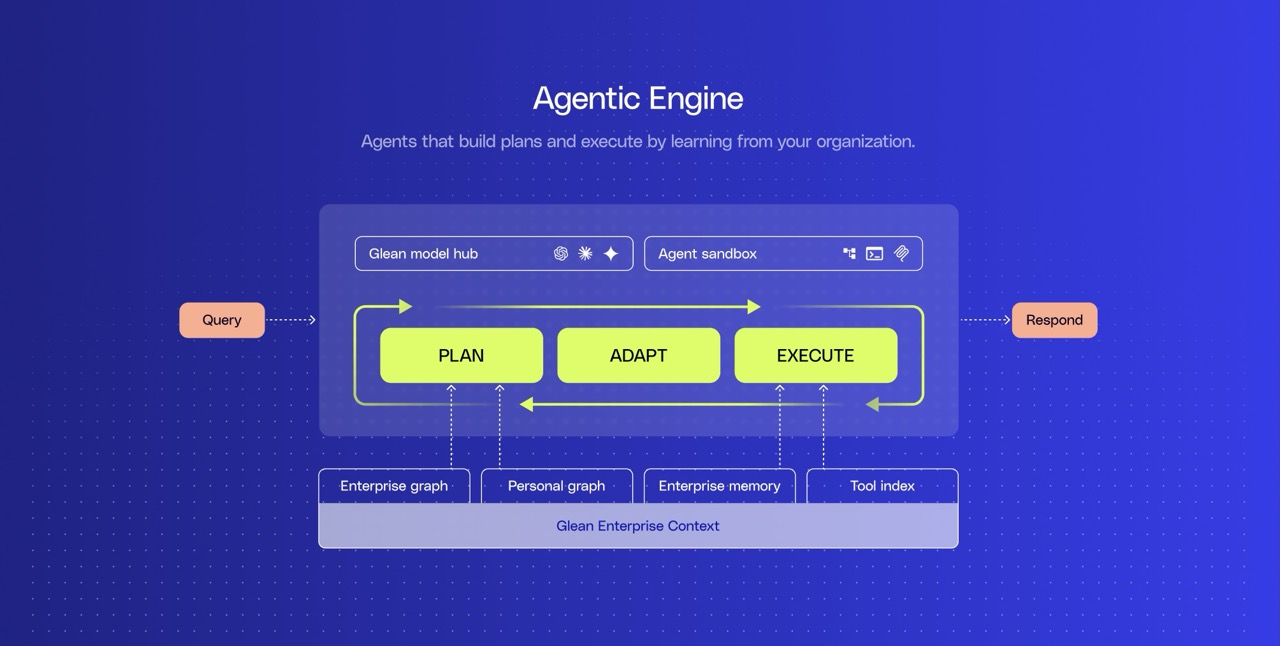
À mesure que l'agent s'exécute et récupère le contenu nécessaire au rapport de pipeline, il approche de la limite de la fenêtre de contexte du modèle et active un sandbox d'agent.
Le sandbox d'agent fonctionne aux côtés du contexte d'entreprise de Glean, en intégrant les données d'opportunités structurées de Salesforce, ainsi que les transcriptions d'appels Gong non structurées, les messages Teams, les e-mails Outlook, les documents Word, les présentations PowerPoint, et bien plus encore.
Glean permet à l'agent de donner du sens à ces données en les cartographiant dans le Graphe d'entreprise, qui relie les clients, les gestionnaires de comptes et l'activité à travers toutes vos applications professionnelles. Ainsi, seules des données pertinentes et de haute qualité atterrissent dans le sandbox et sont utilisées à chaque étape de l'exécution de l'agent, évitant la surcharge et les interférences de contexte. Le sandbox permet aux agents d'extraire un maximum de valeur de grandes quantités de contexte, mais uniquement s'il est alimenté dès le départ avec le bon contexte.
Le sandbox d'agent inclut un environnement d'exécution Python pour l'analytique et le traitement des données. Pendant son exécution, l'agent peut utiliser l'exécution de code pour évaluer le risque du pipeline, réaliser des analyses de sensibilité, détecter les valeurs aberrantes et générer une liste classée d'opportunités avec des probabilités de réussite prédites.
La véritable avancée réside dans le fait que cette analyse ne se limite pas aux données nettoyées et structurées qui apparaissent dans les rapports CRM : l'agent peut intégrer et analyser des données non structurées issues de toutes vos conversations clients, des conversations qui étaient auparavant hors de portée pour mener à bien l'analyse. Désormais, votre prévision reflète la réalité de ce qui se passe avec les clients, et non plus la simple fraction capturée dans les champs de données structurées.
Les leçons de l'ingénierie de la gestion de la mémoire à court terme
Avant de construire les sandboxes, les fenêtres de contexte des LLM étaient la seule mémoire à court terme dont disposaient les Glean Agents. Même si les fenêtres de contexte se sont élargies à chaque nouvelle version de modèle, les agents avaient toujours besoin d'une gestion du contexte à court terme efficace et structurée pour atteindre de bonnes performances.
Chez Glean, nous avons conçu une hiérarchie de classification pour les données affluant dans la fenêtre de contexte. Cela permettait aux agents de distinguer les entrées utilisateur, les instructions système et les sorties d'outils à travers différentes parties d'une conversation. Ces heuristiques aidaient les agents à décider quel contenu élaguer tout en préservant les faits et instructions critiques. Le sandbox utilise cette même hiérarchie pour une approche plus puissante. Au lieu de supprimer des informations, un agent conserve dans la fenêtre de contexte du LLM les données dont il a immédiatement besoin et stocke les données supplémentaires dans le système de fichiers pour un accès à la demande ultérieur. Avec le sandbox, la gestion de la mémoire est passée de la suppression à la persistance.
Nous avons également construit des outils de sélection qui permettent aux agents de charger en mémoire des extraits spécifiques de documents volumineux en fonction d'une similarité sémantique propre à l'entreprise. Cela permettait aux agents de comprendre rapidement de longs documents sans avoir à tout lire en amont. Le système de fichiers du sandbox alimente une stratégie similaire avec une capacité accrue. Avec les sandboxes, nous pouvons utiliser les outils de sélection pour cibler rapidement les bons extraits, mais désormais associés à une matérialisation gourmande, en analysant l'intégralité du document, en revisitant des sections spécifiques ou en écrivant du code pour les analyser.
Nous avons exposé des filtres avancés dans les outils de recherche de Glean, afin que les agents puissent exploiter les données de manière plus efficace et plus rapide, en leur permettant de spécifier des plages de dates, des types de documents et des signaux de classement tels que la similarité sémantique et la popularité. Ces mêmes filtres avancés servent désormais à rendre le sandbox plus efficace.
Si nos premiers systèmes étaient efficaces, ils étaient fragiles. Un cadre qui fonctionnait pour GPT-5 pouvait s'avérer insuffisant pour Claude Sonnet 4.5. Même des mises à jour mineures (par exemple, de GPT-5.1 à 5.2) provoquaient de grandes variations de performance. Cela s'explique par le fait que la mémoire dans la fenêtre de contexte repose sur l'attention du modèle, qui change à chaque mise à jour. Par conséquent, l'interprétation par le LLM des résumés, des instructions et des états de tâche varie d'une version à l'autre, entraînant une dérive de la qualité même si le système d'agents reste inchangé. Maintenir la qualité d'un modèle à l'autre impliquait d'ajuster continuellement la mémoire. Voilà pourquoi les agents n'ont pas besoin de fenêtres de contexte plus grandes : le problème de la fragilité de la mémoire à court terme persisterait. Ce dont ils ont besoin, ce sont des sandboxes.
Cette fragilité était le coût caché du fait de traiter la fenêtre de contexte comme la seule forme de mémoire. Les sandboxes nous permettent de déplacer cet état hors de la fragile fenêtre de contexte vers un environnement stable dans lequel l'agent peut travailler de manière fiable. Bon nombre de nos investissements antérieurs dans la classification, la récupération et le classement restent pertinents aujourd'hui. Parallèlement, une grande partie du travail consacré à la troncature agressive, à la compression et à la microgestion du budget de tokens a disparu avec les sandboxes.
Comment nous avons sécurisé le sandbox d'agent
La sécurité est intégrée au sandbox d'agent dès sa conception. Chaque sandbox s'exécute dans un environnement isolé au sein de votre propre VPC, avec des limites de ressources strictes, des systèmes de fichiers cloisonnés et une isolation au niveau de la session. Les données, le code et les artefacts intermédiaires d'une session ne fuient jamais vers une autre. L'accès réseau du sandbox est désactivé par défaut et sera entièrement configurable à l'avenir, ce qui minimise l'exposition tout en offrant un contrôle précis lorsqu'une connectivité externe est nécessaire. Comme les outils et les appels aux LLM transitent toujours par les mêmes chemins d'orchestration qu'auparavant, le sandbox hérite de l'ensemble des garde-fous, autorisations et contrôles de gouvernance existants de Glean.
Les modèles et le contexte fonctionnent mieux ensemble avec le sandbox d'agent
Les sandboxes d'agent ne remplacent pas de meilleurs modèles ou un contexte plus riche. Ils rendent les deux plus utiles ensemble. Lorsque vous donnez un sandbox aux agents, ils cessent de lutter contre la fenêtre de contexte et commencent à prendre en charge plus de travail qu'auparavant.
Pour une plateforme d'IA pour le travail où des agents performants rencontrent le contexte complet de l'entreprise, inscrivez-vous dès aujourd'hui à une démo de Glean !
Disponibilité : les sandboxes d'agent Glean seront bientôt disponibles.
