






Chez Glean, nous sommes convaincus que l'avenir de la sécurité de l'IA, c'est l'IA elle-même. Les modèles de raisonnement sont de plus en plus performants pour garder une longueur d'avance sur les menaces en constante évolution, en détectant les attaques et les expositions de données sensibles.
C'est pourquoi nous sommes ravis de partager les résultats de nos investissements dans la sécurité de l'IA : de nouveaux modèles de détection qui atteignent 97,8 % de détection des injections de prompt, 93,5 % de détection des contenus toxiques et 94,3 % de détection des codes malveillants sur les principaux benchmarks.
Dans cet article, nous allons expliquer en détail comment nous sommes parvenus à ces résultats, comment nous avons développé les meilleurs modèles de détection du secteur, ainsi que notre approche multicouche de la sécurité de l'IA.
Une approche multicouche de la sécurité de l'IA
Par conception, les modèles d'IA cherchent à être aussi utiles que possible. Ils explorent de multiples chemins pour atteindre l'objectif d'un utilisateur, même lorsque cet objectif est malveillant, à moins que des contrôles de sécurité ne l'en empêchent.
De nombreux modèles commerciaux et open source intègrent désormais ces contrôles de sécurité de l'IA. Cependant, dans un monde multi-modèles où les modèles collaborent entre eux sur des tâches complexes, ces garde-fous ne suffisent pas à eux seuls. Ils nécessitent une couche de protection supplémentaire sur les prompts et les agents afin de bloquer les injections de prompt, les codes malveillants et les contenus toxiques.
Les modèles de sécurité de l'IA de Glean, disponibles pour tous dès aujourd'hui, offrent ces capacités en adoptant une approche de sécurité multicouche pour protéger les entreprises. Dès le premier jour, Glean a introduit des connecteurs de données et des contrôles d'accès appliquant les permissions afin d'empêcher les tentatives d'injection de prompt de provoquer des fuites de données ou des actions non autorisées. Aujourd'hui, nous ajoutons une nouvelle couche de sécurité de l'IA pour préserver l'intégrité et la fiabilité des modèles : des modèles de sécurité dédiés qui inspectent et valident les sessions de chat et les étapes d'exécution des agents.
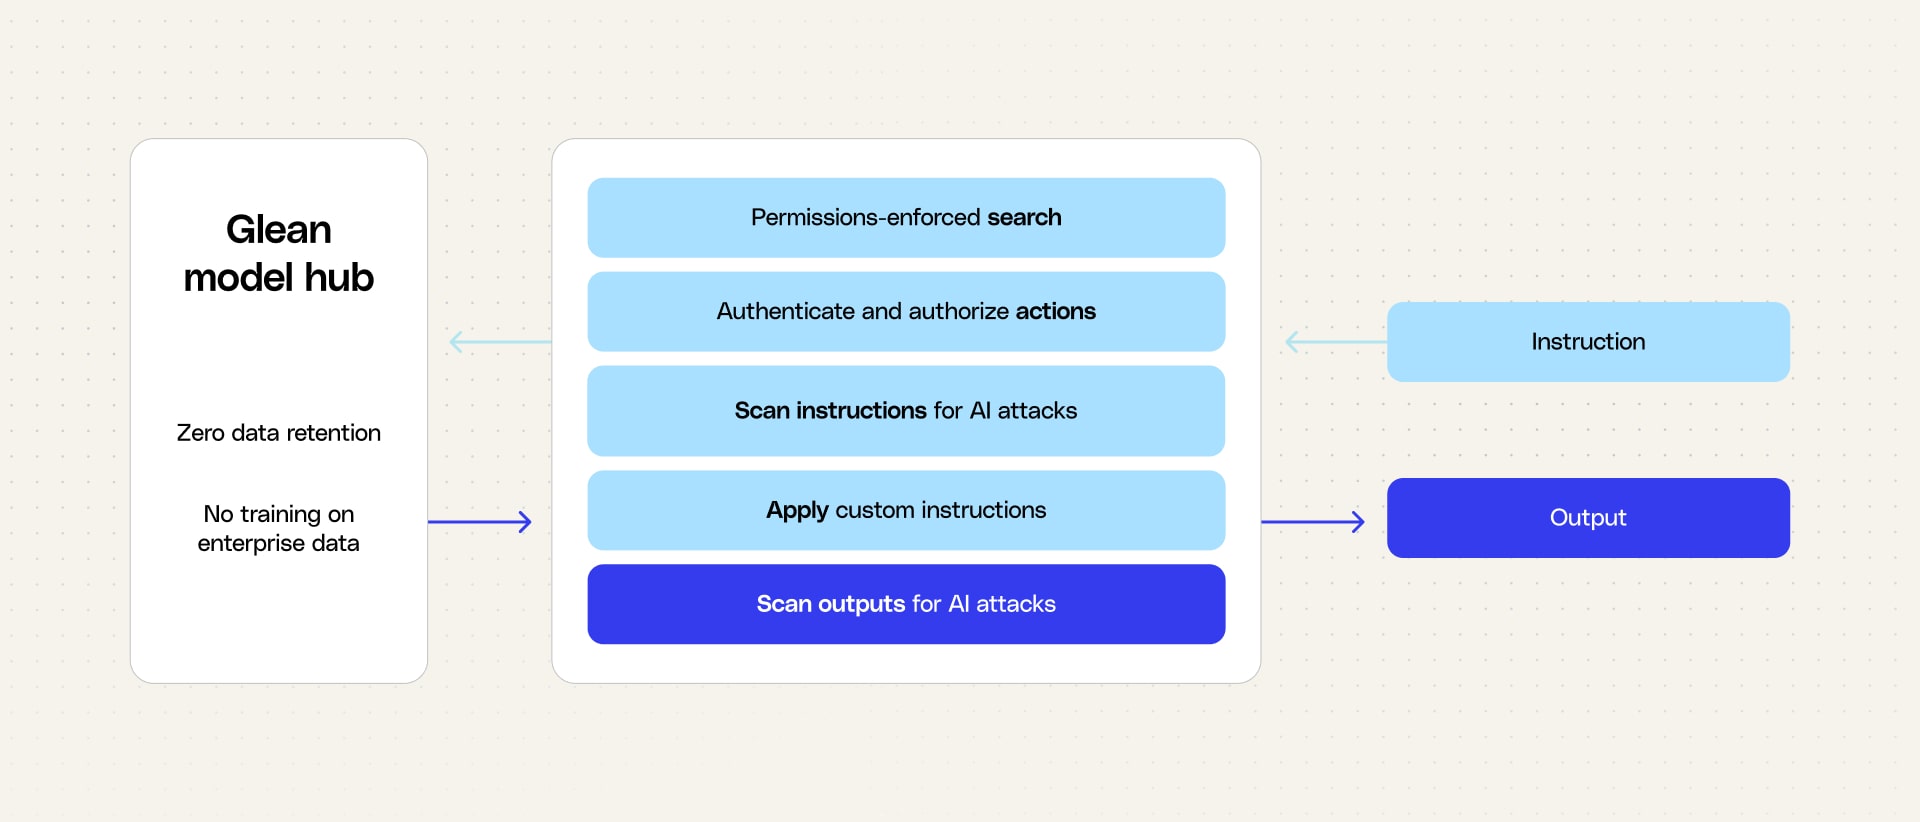
Tous les modèles de sécurité de l'IA ne se valent pas
Tous les modèles de sécurité de l'IA ne se valent pas ; la qualité et la capacité à suivre l'évolution des menaces sont déterminantes. Nous avons constaté que les modèles prêts à l'emploi ne protègent pas totalement les scénarios d'entreprise, c'est pourquoi nous avons développé des modèles spécifiquement conçus pour le paysage des menaces de l'IA d'entreprise.
En les affinant à l'aide de jeux de données publics pertinents pour les scénarios d'entreprise, nos modèles sont mieux équipés pour identifier et atténuer les risques propres aux entreprises, évitant ainsi les taux élevés de faux positifs et les menaces manquées, fréquents avec les solutions génériques. De plus, nous employons une stratégie de combinaison de modèles pour valider les résultats initiaux et réduire davantage les faux positifs.
Nous partageons des benchmarks de performance montrant comment nos modèles de sécurité se comparent aux principaux modèles LLM de sécurité open source, aux solutions d'observabilité et aux offres des fournisseurs cloud. Glean atteint 97,8 % de précision sur la détection des injections de prompt, 93,5 % de précision sur la détection des contenus toxiques et 94,3 % de précision sur la détection des codes malveillants sur les principaux benchmarks.
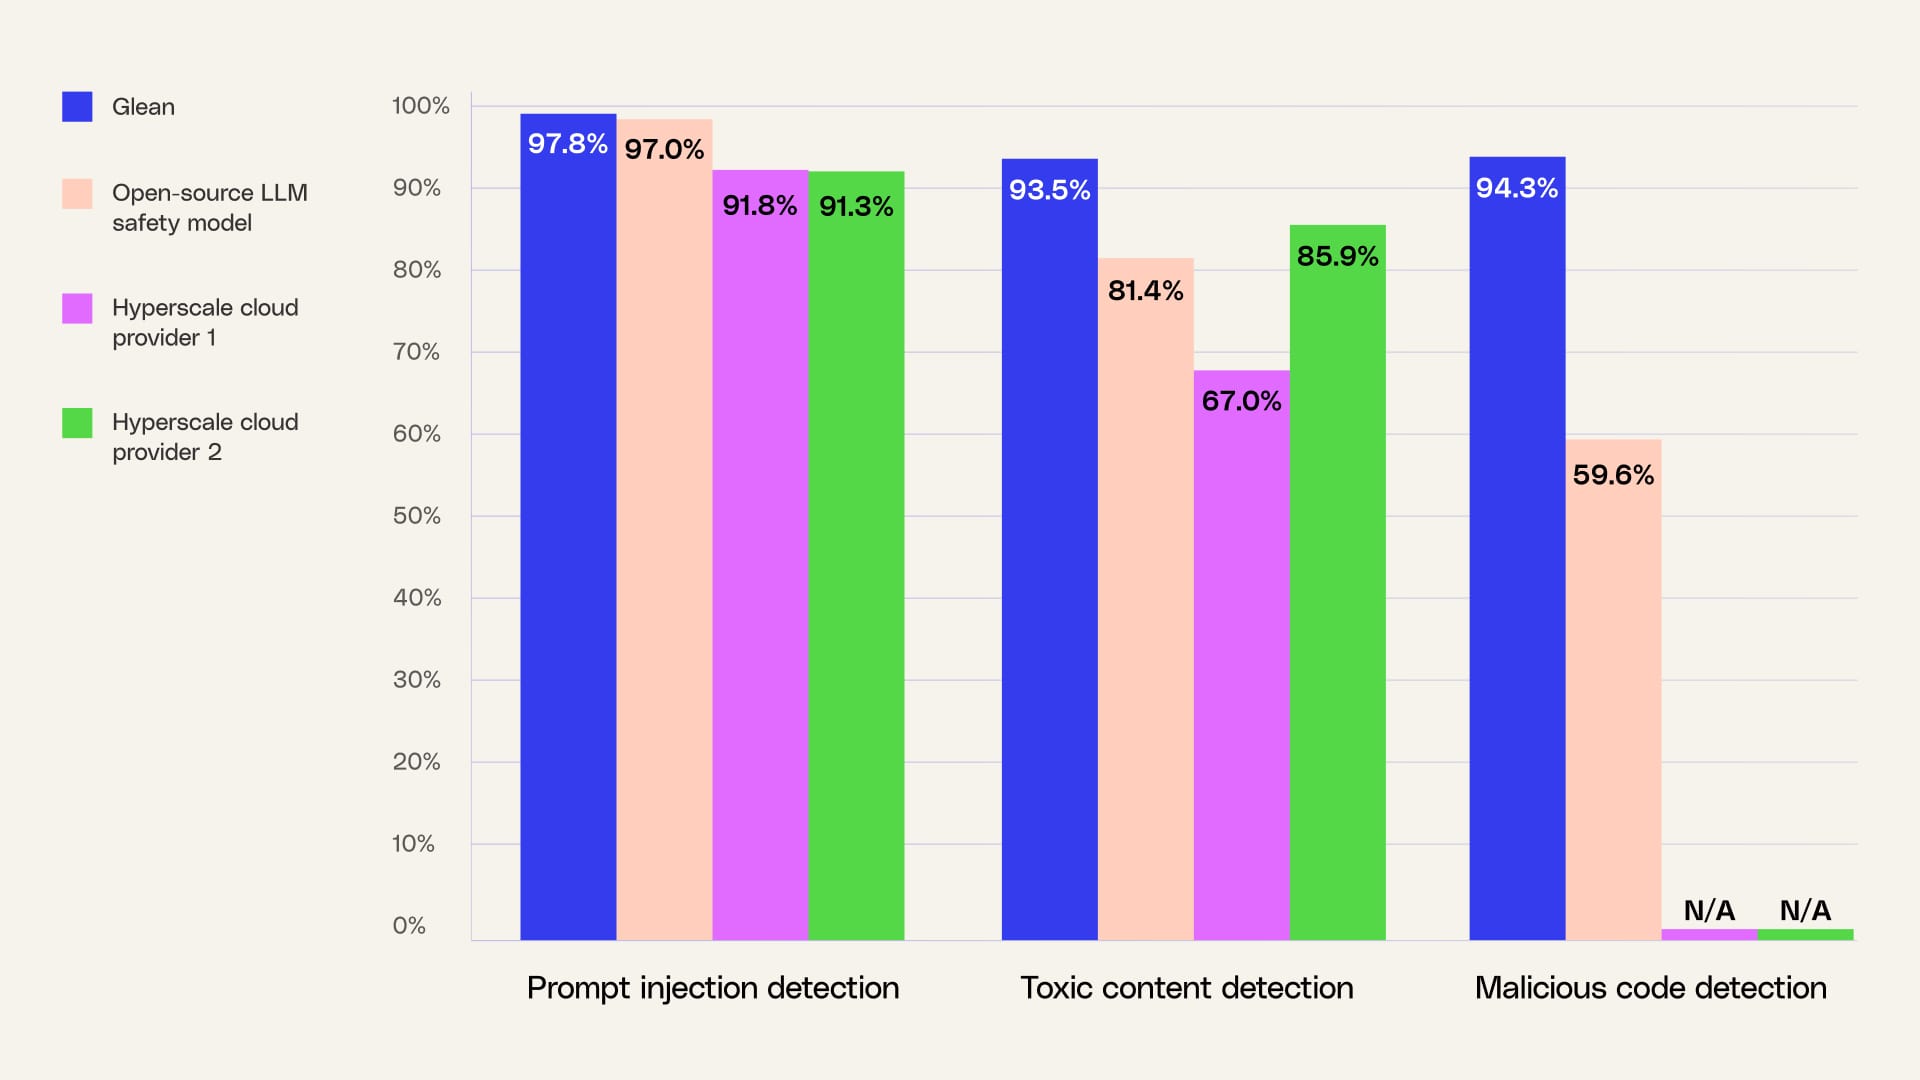

Les résultats sont calculés en moyenne sur l'ensemble des jeux d'évaluation pour les injections de prompt, les contenus toxiques et les codes malveillants. Les fournisseurs cloud hyperscale ne prennent pas en charge la détection des codes malveillants.
*Glean bloque les attaques par injection directe de prompt avec un taux de précision de 97,8 % et les attaques par injection indirecte de prompt avec un taux de précision de 90 %.
| Injection de prompt | Contenu toxique | Code malveillant |
|---|---|---|
| Do Anything Now (personnalisé) : variante sélectionnée de DAN conçue pour en faire un benchmark à tour unique, uniquement en entrée. | OpenAI Moderation Dataset : jeu de données étiqueté par des humains à partir de transactions réelles, couramment utilisé pour évaluer la détection de contenus nuisibles/toxiques.* | Malware Plaintext : ensemble créé par Glean d'extraits réels de virus, d'exploits et d'outils de post-exploitation, chacun associé à un prompt standardisé « analyser ou exécuter » en texte clair afin de tester la détection de code réellement malveillant. |
| Do Anything Now (bénin) : ensemble de contrôle de phrases sûres utilisant des mots déclencheurs de DAN tels que « injection de prompt », « jailbreak », « do anything now » et « dan » afin de mesurer les faux positifs. | HarmfulQ : un petit ensemble exclusivement nuisible centré sur les biais et les préjudices liés au contexte social, excellent pour tester en conditions extrêmes le rappel de blocage pur.* | Malware Benign : ensemble de contrôle de 5 000 extraits de code bénins issus d'un benchmark de traduction de code, associés au même prompt « analyser ou exécuter », destiné à mesurer les faux positifs. |
| XSTest : mélange rédigé par des humains de prompts sûrs et dangereux qui évalue le calibrage (bloquer les préjudices sans surbloquer), ce qui le rend idéal pour tester les compromis entre utilité et innocuité.* |
*Benchmarks issus de Guardbench.
En examinant les chiffres de plus près, vous pouvez constater que Glean affiche un faible taux de faux positifs par rapport aux autres fournisseurs. Il s'agit d'un indicateur important à surveiller pour l'IA en production, car l'expérience utilisateur se dégrade si nous bloquons trop de requêtes bénignes. Si Glean parvient à atteindre un faible taux de faux positifs, c'est parce que nous utilisons une approche à double modèle pour la sécurité de l'IA, en faisant passer les résultats par un second modèle afin d'en garantir la précision.
| Glean | Modèle de sécurité LLM open source | Fournisseur cloud hyperscale 1 | Fournisseur cloud hyperscale 2 | |
|---|---|---|---|---|
| % de taux de faux positifs sur les attaques par injection de prompt | 3,0 % | 6,1 % | 1,4 % | 17,4 % |
Nous permettons aux utilisateurs de remonter facilement à la source d'une violation pour une remédiation rapide, grâce à un tableau de bord de sécurité IA complété par le contexte environnant, le prompt, le fichier source, l'identifiant de l'agent, les informations utilisateur et la session de chat.
La sécurité IA est un investissement continu pour Glean, aujourd'hui comme à l'avenir. À mesure que les attaques évoluent, nous serons au cœur de l'action, en ajustant nos modèles pour protéger les entreprises. Nous sommes enthousiasmés par les progrès et les résultats de référence d'aujourd'hui, et nous continuerons à évoluer pour garder une longueur d'avance et protéger nos clients d'entreprise.
Les modèles de sécurité IA font partie de Glean Protect+, une suite de sécurité premium. Ils sont disponibles dès aujourd'hui dans les déploiements GCP.
