






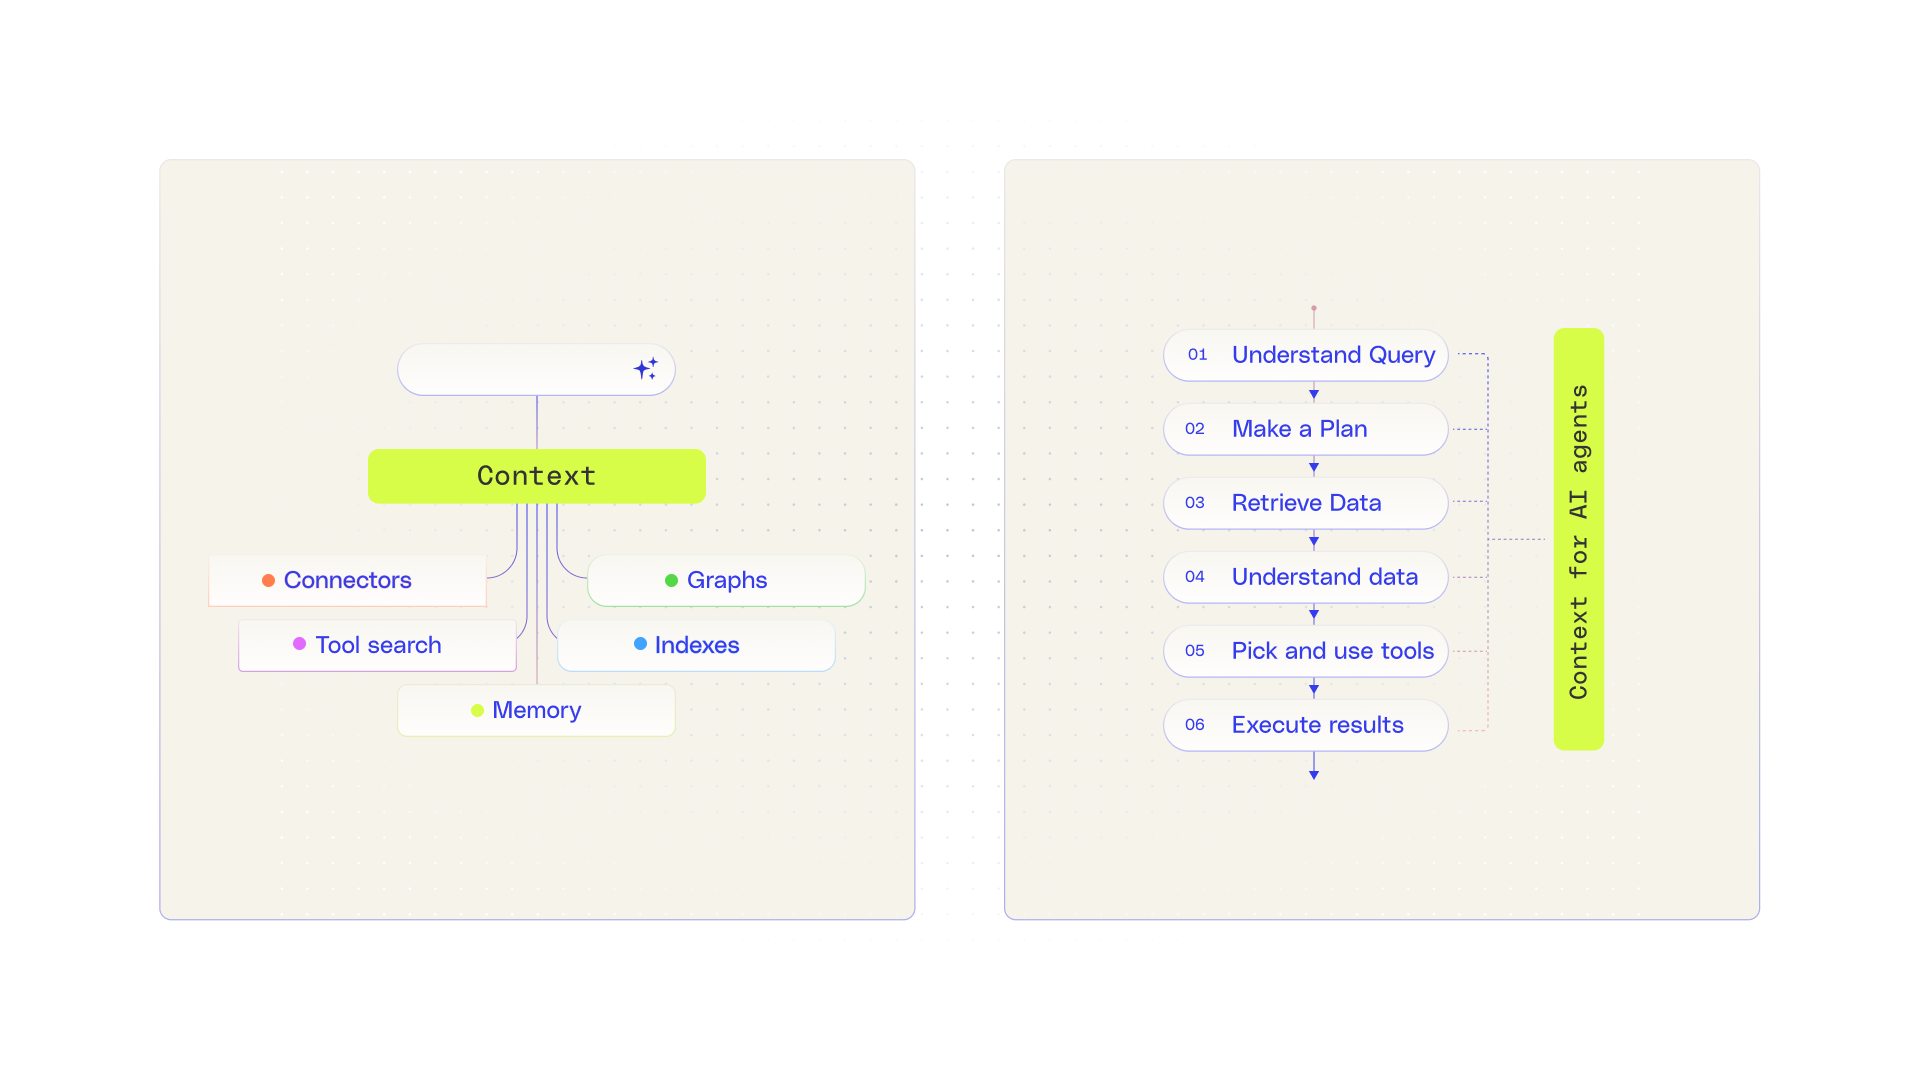
Au cours de l'année écoulée, l'ingénierie du contexte est devenue centrale dans la création d'agents IA performants, en façonnant la manière dont les modèles interprètent l'information et se coordonnent entre différents outils pour accomplir un véritable travail. À mesure que les fenêtres de contexte s'élargissent et que les workflows agentiques gagnent en sophistication, le rôle du contexte n'a cessé de croître. Bien le gérer est désormais fondamental pour déterminer si les agents réussissent en entreprise.
Des frameworks comme le Model Context Protocol (MCP) ont accéléré cette évolution en facilitant la connexion d'outils et l'exposition de fonctionnalités. Ce faisant, ils ont aussi mis l'importance du contexte en pleine lumière. L'accès seul ne garantit pas la compréhension, et sans couche d'unification, la seule disponibilité d'un outil peut donner un faux sentiment d'exhaustivité. En pratique, cela conduit souvent les équipes sur l'un de ces deux chemins : orchestrer manuellement les outils MCP en workflows rigides et déterministes qui deviennent vite fragiles à mesure que les systèmes évoluent, ou s'appuyer sur des appels d'outils génériques qui héritent de la sémantique fragmentée et de la recherche faible de chaque système. Dans les deux cas, la charge de la gestion du contexte retombe sur les ingénieurs, au lieu d'être résolue au niveau de la plateforme.
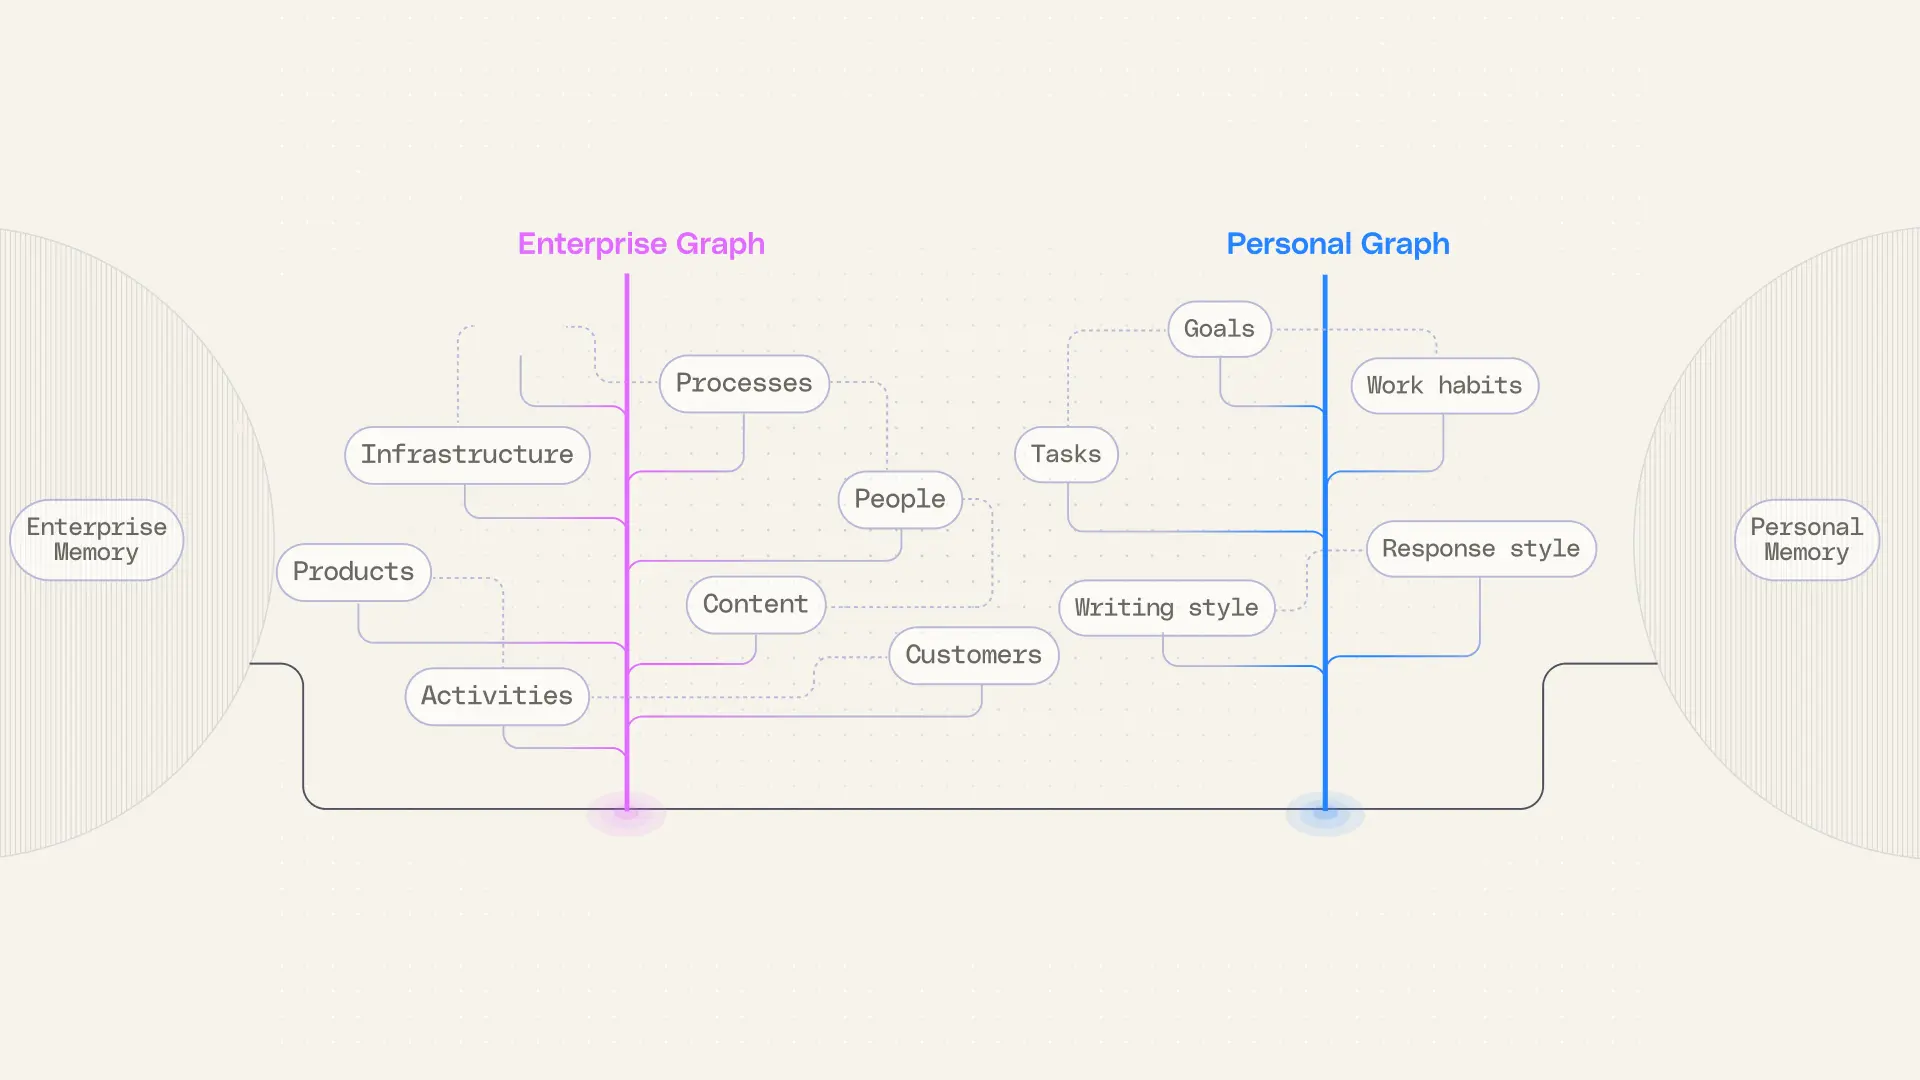
Selon nous, le contexte doit être une capacité fondamentale — unifiée, apprise en continu et livrée de manière cohérente — pour que les agents puissent fonctionner de façon fiable à grande échelle. Les agents efficaces s'appuient sur le contexte issu de systèmes conçus à cet effet, comme la recherche, qui a compris depuis longtemps que le contenu seul ne suffit pas. Des signaux tels que l'usage, la popularité et les liens améliorent la pertinence, tandis que les structures en graphe aident à cartographier les relations entre les personnes, les projets et les équipes. Associé à une mémoire d'entreprise qui apprend comment les outils et les processus s'articulent, cela crée non seulement un accès à l'information, mais une véritable compréhension de la manière dont le travail s'accomplit.
Aujourd'hui, de plus en plus de travail bascule vers les agents IA. Les employés demandent à l'IA de déboguer des problèmes d'ingénierie, de générer des plans de compte éclairés, de préparer des réunions clients et de piloter des initiatives complexes de bout en bout. Au cœur de tout cela se trouve le contexte. Cette évolution — de la découverte à la compréhension, puis à l'action — est ce qui fait du contexte la colonne vertébrale de l'IA d'entreprise. Dans ce blog, nous allons passer en revue nos décisions de conception et les enseignements tirés de la construction du contexte d'entreprise.
Méthodes pour comprendre le contexte d'entreprise
L'adoption croissante du MCP a également introduit quelques idées reçues sur la maturité et la fiabilité des outils. Si de nombreux outils MCP offrent une interface simple vers des API existantes — ce qui constitue un point de départ précieux —, ils manquent souvent d'une compréhension intégrée de la sémantique des données sous-jacentes ou de la manière dont ces données doivent être utilisées en pratique. Par conséquent, un contexte et une interprétation supplémentaires restent nécessaires, et sans couche de plateforme de soutien, cette responsabilité peut retomber sur les ingénieurs.
Index
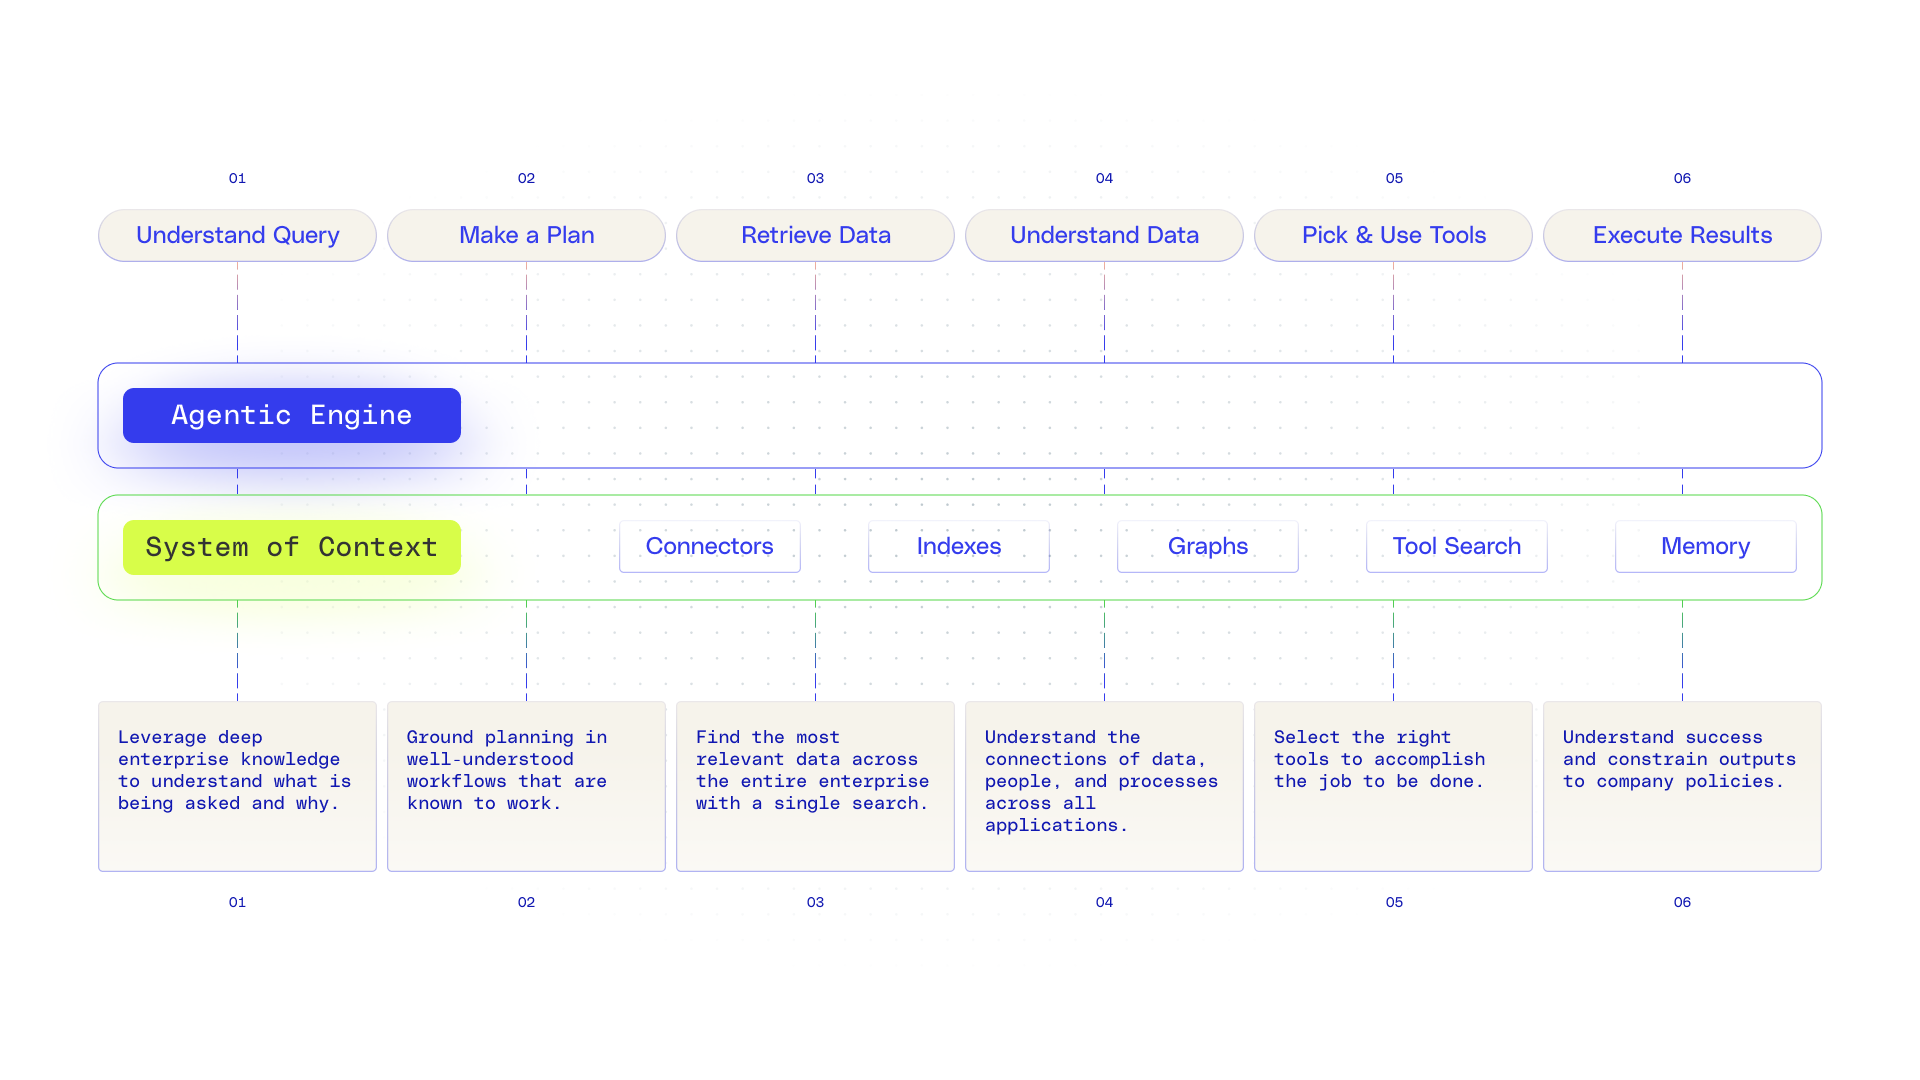
Pour réduire la charge cognitive, vous devez concevoir des outils de qualité suffisamment flexibles pour prendre en charge un large éventail de cas d'usage. Ce que nous avons observé chez Glean, c'est que les fondations de ces outils reposent souvent sur des index ; des index qui structurent et stockent les données de la meilleure façon pour répondre rapidement à une requête. Si vous souhaitez prendre en charge un large éventail de cas d'usage d'IA d'entreprise, vous aurez besoin de différents types d'index pour la récupération.
Par exemple, nous avons séparé les outils selon la tâche à accomplir : la recherche de calendrier indexe les événements par date et par personne (p. ex. after:now, before:DATE, « ma prochaine réunion avec John »), ce qui aide à répondre à des questions comme « quand ai-je rencontré Judy pour la dernière fois ? » ou « donne-moi mes prochaines réunions ». La recherche Glean, quant à elle, est plus adaptée pour trouver des documents non structurés, des tickets et des e-mails, surtout lorsque j'ai besoin d'un contexte transversal entre applications, comme « quelles sont les dernières nouvelles du projet falcon ? ». S'agissant de données structurées, si un utilisateur demande « Quel est notre ARR total ? », nous interrogeons un index des données de tableaux de bord Salesforce et utilisons des signaux tels que le créateur du tableau de bord et la popularité pour identifier la métrique canonique de l'organisation.
Connecteurs et modélisation des données
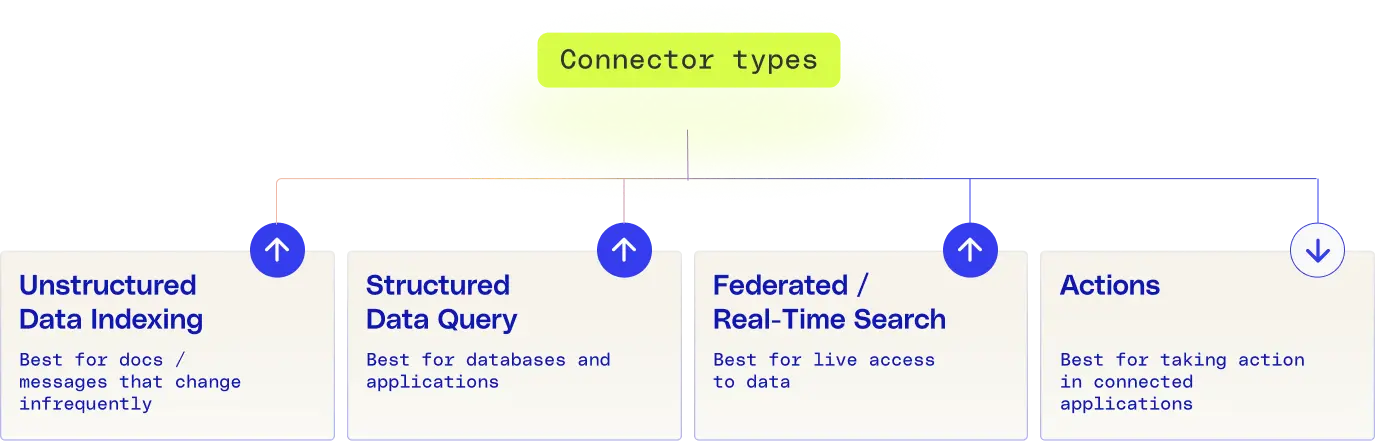
Construire des index centralisés était relativement facile pour les données issues d'Internet, de nature homogène — ce n'est pas le cas des données d'entreprise, hétérogènes. Chaque application possède sa propre structure et sa propre sémantique, et nécessite des modèles de données qui capturent cette diversité tout en la normalisant pour renvoyer des résultats pertinents à travers les sources. Par exemple, dans Jira, un ticket représente un problème spécifique, mais ce problème se rattache à une epic plus large — et les documents liés dans la description tendent à être plus faisant autorité et plus pérennes que ceux figurant dans les commentaires. Lorsque l'on prend du recul et que l'on conçoit en tenant compte de la richesse et de la compréhension des données d'entreprise, les connecteurs et la modélisation des données comptent énormément. C'est souvent le point de départ pour accéder au contexte, mais leur importance est fréquemment sous-estimée avec l'essor du MCP.
Des questions se posent quant à la valeur des outils de récupération comme la recherche d'entreprise face à la récupération basée sur le MCP. Chez Glean, nous considérons le MCP comme complémentaire, en le combinant à notre système d'indexation via des connecteurs hybrides afin d'obtenir à la fois une fraîcheur en temps réel et une compréhension unifiée de l'entreprise. Comme toute source de données, les outils MCP bénéficient encore de la modélisation des données, de l'extraction de signaux et de l'indexation pour délivrer de la valeur. C'est une ingénierie du contexte que la plateforme doit prendre en charge, et ce n'est pas une initiative ponctuelle — elle doit suivre le rythme des évolutions des applications d'entreprise (c.-à-d. : nouveaux types de données, nouvelles fonctionnalités, etc.).
Graphes de connaissances
Les connecteurs et les outils aident à faire remonter du contenu, mais ils ne résolvent pas la question des relations et des mappages canoniques entre différentes applications. C'est là qu'interviennent les graphes de connaissances. Même si le raisonnement des modèles s'améliore, les structures basées sur les graphes restent le socle fondamental du contexte d'entreprise. En encodant les entités — personnes, projets et processus — et leurs relations, les graphes ancrent les agents, permettant un raisonnement multi-sauts, la désambiguïsation du langage propre à l'entreprise et une compréhension de la façon dont le travail se déroule.
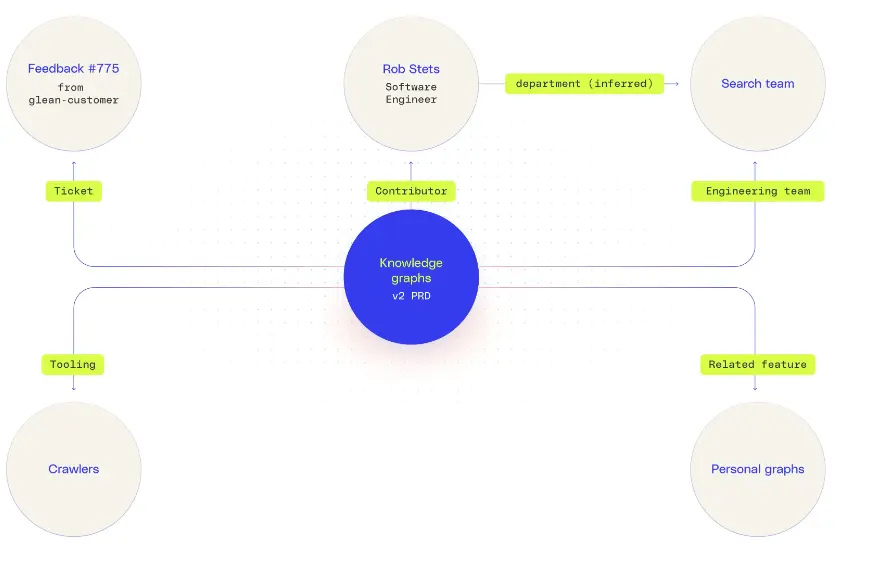
À sa base, un graphe de connaissances représente l'information sous forme de relations liées plutôt que de points de données isolés. Chaque relation connecte une entité à une autre via une relation définie — par exemple, un ingénieur se voyant attribuer un ticket Jira ou un document lié à un projet. Ces relations forment collectivement un graphe d'entités connectées que l'on peut parcourir pour répondre à des questions complexes, découvrir des connexions cachées et dégager des insights qui ne sont pas explicitement stockés dans une source unique.
Les modèles gèrent le rappel de faits simples lorsque les réponses sont explicites ou proches du contenu source, mais ils peinent avec les inférences complexes multi-sauts, en particulier sur de grandes fenêtres de contexte (« Affiche toutes les bases de code des projets dirigés par X qui ont été livrés au T1 2025 »). De plus en plus, les agents d'entreprise entrent dans cette seconde catégorie — nécessitant un raisonnement en plusieurs étapes à travers les entités. C'est pourquoi les graphes sont essentiels : ils donnent aux agents accès à des insights complexes pour traiter avec précision les questions nuancées de l'entreprise.
Utiliser le contexte pour passer à l'action
Nous voyons les modèles faire progresser leurs capacités de raisonnement, comprenant quand planifier de manière itérative et comment utiliser les outils, permettant à l'IA de prendre en charge davantage de travail. Ce n'est pas parce qu'ils savent appeler des outils qu'ils savent faire passer leur utilisation à l'échelle de l'entreprise. Il s'agit là d'un autre espace nouvellement élargi qui nécessite des optimisations et une mémoire d'entreprise.
Recherche d'outils
Lorsqu'il s'agit de passer à l'échelle de centaines d'outils dans l'entreprise, la tâche de découverte et de désambiguïsation des outils devient critique. Il s'agit là encore d'un problème de recherche — créer un index d'outils que l'on peut utiliser pour trouver le bon ou la bonne combinaison adaptée à la tâche. Glean apprend quels outils fonctionnent le mieux pour votre entreprise en observant comment vos agents les plus performants accomplissent leur travail. Au fil du temps, Glean associe les workflows courants aux bons outils et utilise des signaux comme la popularité et la source de données pour sélectionner le meilleur outil suivant — afin que les agents agissent plus vite sans surcharger la fenêtre de contexte avec des informations inutiles susceptibles d'entraîner des hallucinations.
Optimisations des outils
Comme beaucoup d'autres, nous avons constaté qu'avec les agents IA, minimiser les prompts système, offrir aux agents un menu clair d'outils priorisés et permettre une exploration précoce conduit à des résultats de meilleure qualité. Nous nous sommes également attachés à concevoir les outils de manière à ce qu'ils s'enchaînent facilement et évitent la désambiguïsation — en faisant remonter des opérateurs, en rationalisant les entrées et sorties, et en rendant les noms et descriptions clairs. Les noms et descriptions des outils évoluent au fil du temps, de sorte qu'à mesure que les outils sont évalués et que de nouveaux sont ajoutés, ils continuent de fonctionner de manière optimale. Nous avons également constaté que les agents font un usage efficace des opérateurs, les traitant comme des filtres qui orientent ce qu'il faut rechercher ensuite, quel chemin emprunter et où approfondir. Associés à de puissants outils de récupération, les opérateurs permettent une extraction et une compréhension plus riches du contexte d'entreprise.
Mémoire
Bien que nous ayons réalisé des gains incrémentaux grâce à une meilleure conception des outils et des gains plus importants grâce à la recherche d'outils, ces approches ne nous ont toujours pas permis d'optimiser la façon dont les actions fonctionnent ensemble. Il s'agit en fait d'une situation courante, en particulier pour les outils conçus pour des actions atomiques (des actions capables de faire une seule chose mais incapables d'accomplir une tâche de bout en bout), qui sont populaires avec MCP.
Prenons l'exemple de la planification d'une réunion. Il faut d'abord des connaissances de l'entreprise : qui fait partie de l'équipe, quelles sont les priorités de l'ordre du jour, quelle devrait être la durée de la réunion — comprendre comment les réunions se déroulent dans une entreprise. Ce sont des tâches de récupération qui reposent sur des outils de recherche. Il faut ensuite réellement planifier la réunion — ajouter des adresses e-mail, un lien de réunion, une salle et une heure à une invitation. Planifier n'est pas une action unique ; c'est la donnée et les actions qui fonctionnent de concert.
Pour atteindre l'objectif de manière fiable — faire en sorte qu'une réunion soit planifiée — l'agent doit apprendre quels outils utiliser et comment les paramétrer, en itérant souvent à travers plusieurs tentatives avant de trouver le bon chemin. Mais lorsqu'une session se termine, ces insights durement acquis — chemins réussis, tentatives échouées, modèles de paramètres d'outils — sont perdus au lieu d'être systématiquement réutilisés. Chez Glean, dans une version antérieure de notre moteur agentique, nous utilisions la « recherche de workflow » pour faire remonter des agents passés similaires, mais cela ne mettait pas à jour la politique de l'agent pour le choix ou le paramétrage des outils — c'était trop grossier. Nous l'avons remplacée par quelque chose de plus efficace : la mémoire d'entreprise.
Avec la mémoire d'entreprise dans Glean, nous stockons les traces des exécutions d'agents, notamment les outils utilisés, les paramètres transmis, les séquences tentées et les résultats. Hors ligne, et par entreprise, nous exécutons ensuite des permutations avec différents choix d'outils et arguments. Nous évaluons les résultats sur la justesse, l'exhaustivité et l'efficacité, puis réinjectons les apprentissages dans le système en langage naturel — le langage des LLM. Ces apprentissages fournissent des indications sur les outils à utiliser et pourquoi, sur la façon de structurer les entrées des outils et sur la façon de séquencer les actions. L'accent est entièrement mis sur les heuristiques d'utilisation des outils — et non sur les données de l'entreprise elles-mêmes, pour la protection de la sécurité des données.
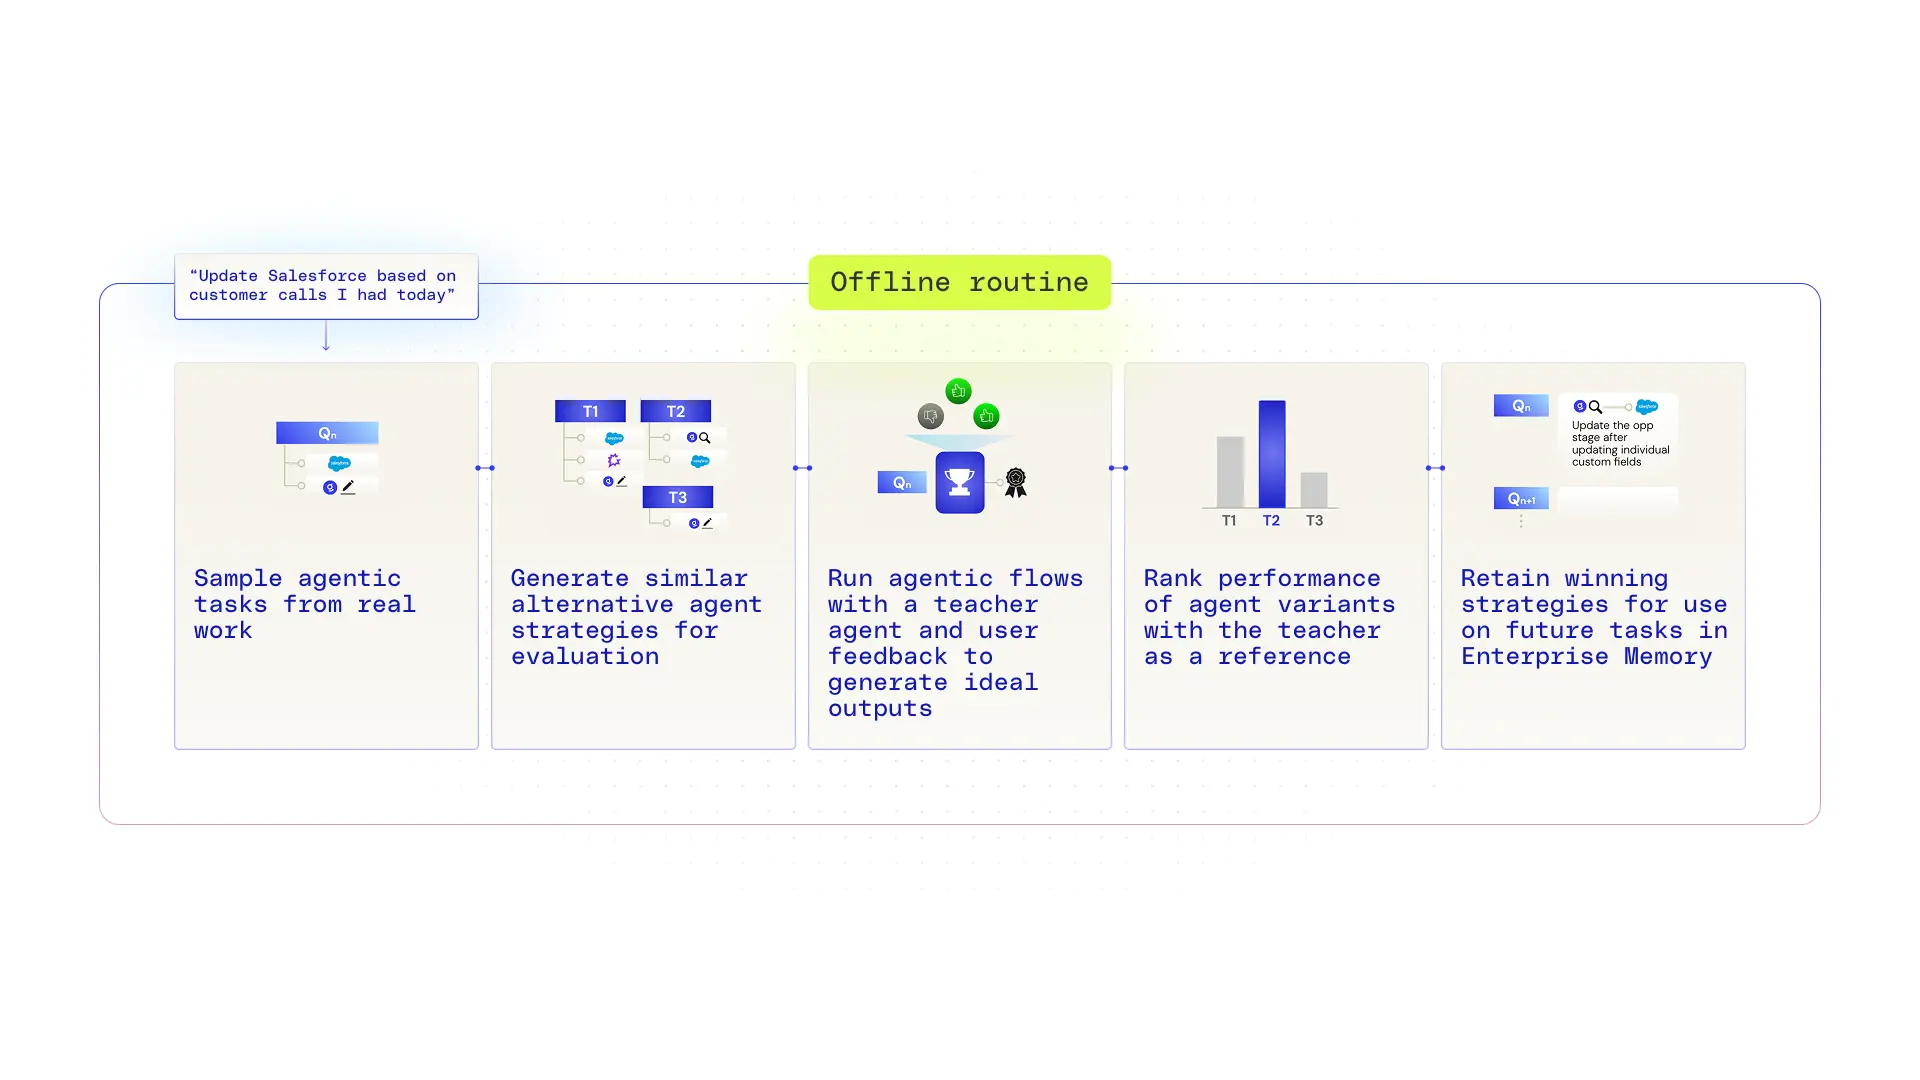
Lorsqu'une nouvelle tâche agentique similaire démarre, l'agent reçoit un indice ciblé tiré de cette mémoire, l'aidant à choisir de meilleures actions dès le départ. Au fil du temps, ces apprentissages, stockés au niveau de chaque entreprise, évoluent pour devenir la connaissance des processus agentiques de votre organisation. Le système se renforce lui-même : à mesure que davantage de tâches sont accomplies, l'agent devient de plus en plus compétent, atteignant finalement un niveau de performance d'expert.
La planification d'une réunion n'est qu'un exemple, mais nous avons également constaté que la mémoire contribue aux éléments suivants chez Glean :
- Rédaction des notes de version : chez Glean, les notes de version sont réparties sur plusieurs champs Jira et se résument généralement à quelques phrases. La mémoire a appris à commencer par le ticket Jira et ses liens — documents de conception, documents d'exigences produit, documents bêta — car c'est généralement là que se trouvent les détails faisant autorité, et elle utilise les bons outils de récupération pour rassembler ce contexte.
- Métriques de l'entreprise : elle peut aussi apprendre à trouver les métriques de l'entreprise — comme une tendance de chiffre d'affaires — qui sont propres à chaque activité. Grâce à la mémoire d'entreprise, Glean identifie la bonne métrique de l'entrepôt de données pour l'ARR au lieu d'essayer de reconstruire le calcul à partir de zéro.
- Recherche sur les comptes : prenons également les tâches de recherche ouvertes. Pour la recherche sur les comptes, elle détermine le format de référence du rapport final, aidant à stimuler des démarches commerciales reproductibles et évolutives. Ensuite, elle effectue des recherches, recueille des informations et vérifie les faits en cours de route en s'appuyant sur sa mémoire des endroits où votre entreprise conserve ses données les plus fiables.
Sécuriser le contexte dans l'entreprise
Lorsque vous centralisez le contexte d'entreprise, la sécurité doit être intégrée dès la conception. Une idée reçue veut que l'accès fédéré soit intrinsèquement plus sûr que l'indexation parce que les données ne sont pas copiées ailleurs. En pratique, la sécurité provient de plusieurs couches de protection, et non d'une seule décision de conception, incluant les autorisations, l'application du principe du moindre privilège, la détection des données sensibles et la surveillance continue. La fédération ou l'indexation est un choix architectural ; le véritable niveau de risque est défini par qui peut voir quoi, quand et pourquoi.
Une couche de contexte solide s'appuie sur plusieurs contrôles de sécurité qui se renforcent mutuellement. Cela signifie généralement s'exécuter dans le cloud propre au client, appliquer les autorisations à chaque requête, restreindre ou exclure les sources sensibles pendant l'indexation, respecter les étiquettes de sensibilité existantes et détecter automatiquement les contenus trop largement partagés ou à haut risque. Chaque récupération et chaque action doivent respecter les ACL des systèmes sources et les politiques d'entreprise.
À mesure que vous ajoutez des graphes et de la mémoire, vous introduisez également des données dérivées, qui nécessitent la même rigueur. Si l'accès à un document source est supprimé, les entités, relations et signaux qui en ont été déduits doivent être supprimés ou invalidés eux aussi. La même règle s'applique aux structures fondées sur les graphes : les utilisateurs ne devraient pas voir les vues dérivées sans avoir accès aux données sous-jacentes, avec une sémantique de droit à l'oubli intégrée.
Chez Glean, nous avons conçu la mémoire d'entreprise pour qu'elle soit sûre dès sa conception — cloisonnée par locataire, jamais partagée entre clients, et axée sur l'apprentissage de la façon dont le travail est accompli (utilisation des outils, séquences, schémas), plutôt que sur le stockage de contenus sensibles. Dans l'ensemble, c'est l'architecture qui crée le contexte qui permet à l'IA de bien fonctionner — mais c'est le modèle de sécurité qui l'entoure qui garde ce contexte en sécurité, où qu'il soit utilisé.
Le contexte est intelligent lui aussi
Il n'existe pas de solution miracle unique pour l'ingénierie du contexte. Elle requiert plusieurs technologies fonctionnant ensemble — intelligemment — pour organiser les informations et les outils afin que les agents puissent accomplir de façon fiable un véritable travail. Les connecteurs sont intelligents quant à ce qu'ils ingèrent, à la manière d'interpréter les signaux et au moment de réexplorer les données à mesure qu'elles changent. La recherche applique de l'intelligence dans sa façon de classer les résultats, en utilisant la pertinence pour faire remonter les bonnes informations au bon moment. Les graphes déduisent des relations, cartographiant par algorithme les connexions entre personnes, projets, documents et systèmes. Et la mémoire apprend au fil du temps, reconnaissant les schémas dans la façon dont le travail est accompli, les outils utilisés ensemble et les actions menant à des résultats fructueux. Ensemble, ces couches transforment les données brutes en un contexte vivant que les agents peuvent comprendre, analyser et sur lequel ils peuvent agir.
Lorsque nous avons créé Glean, des entreprises venaient nous voir pour trouver des informations comme « Trouvez notre politique de réseaux sociaux », qui pouvait résider dans n'importe laquelle des centaines d'applications présentes sur le site. Aujourd'hui, nous constatons que les entreprises ne nous demandent plus seulement de trouver la politique, mais de « rédiger une politique de réseaux sociaux pour notre entreprise conforme aux normes du secteur, ainsi qu'un processus pour la faire approuver par les bonnes parties prenantes internes ». Il s'agit d'une tâche agentique : elle doit non seulement savoir où rechercher vos données, mais aussi comprendre les normes de l'entreprise et les outils permettant de faire approuver la politique. Cela représente beaucoup plus de contexte lorsqu'il s'agit de travail agentique.
Si nous sommes ravis de l'interopérabilité des agents et de MCP, qui rend les outils largement accessibles, cela ne dégage pas pour autant une équipe d'ingénierie de la responsabilité d'ajuster manuellement le contexte. Pour véritablement libérer les ingénieurs de l'ingénierie du contexte, il vous faut une plateforme conçue pour le contexte.
Note de disponibilité : la mémoire d'entreprise et la recherche d'outils de Glean seront bientôt disponibles.
