






La promesse des collaborateurs IA est que les employés peuvent accomplir davantage lorsque l'IA est connectée à leurs sources de données externes, notamment Google Docs, Gmail, Google Calendar, Salesforce et Atlassian. Cette connexion permet l'analyse de données à grande échelle, une gestion plus intelligente de la boîte de réception et de l'agenda, une création de contenu plus rapide et une meilleure récupération d'informations. Toutefois, concrétiser cette promesse exige une IA dont l'employé peut reprendre et utiliser le résultat presque tel quel, pour un coût en tokens proportionné à la tâche.
Chez Glean, nous voulions comprendre comment la couche de contexte façonne l'efficacité et la performance des collaborateurs IA dans la production de ces résultats « prêts à l'emploi ». Il est bien établi que la qualité du contexte sous-jacent, des index et des graphes de connaissances détermine la précision des réponses. Ce qui est moins compris, c'est le compromis économique des index offrant une meilleure pertinence et un meilleur classement : les index échangent un faible coût initial de stockage de données contre une dépendance réduite aux coûts de calcul, qui grimpent rapidement en entreprise à mesure que la consommation de tokens des modèles de pointe augmente.
Pour prouver la valeur de la couche de contexte, nous avons comparé Glean aux outils MCP prêts à l'emploi, en isolant le contexte grâce à la standardisation du harnais sur Claude Cowork. Avec Claude Cowork comme constante, nous avons comparé le serveur MCP distant de Glean, qui inclut l'accès à des outils de recherche et d'écriture, aux serveurs MCP prêts à l'emploi disponibles dans Cowork sur environ 175 requêtes. Nous avons constaté que :
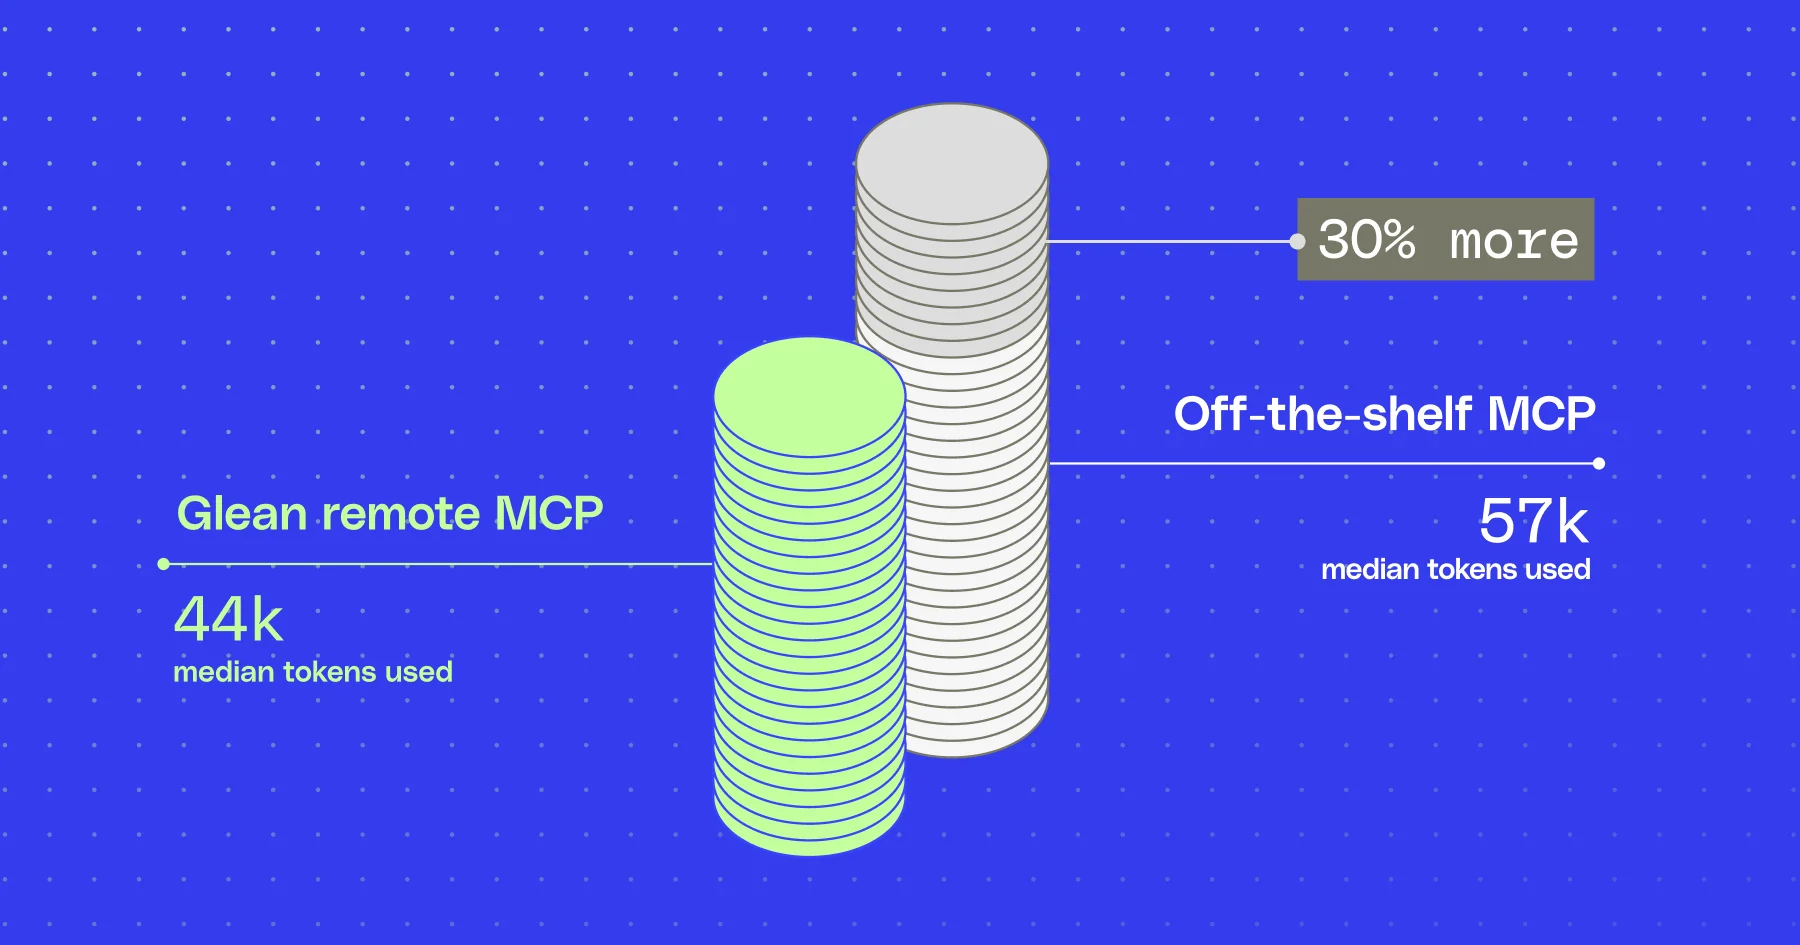
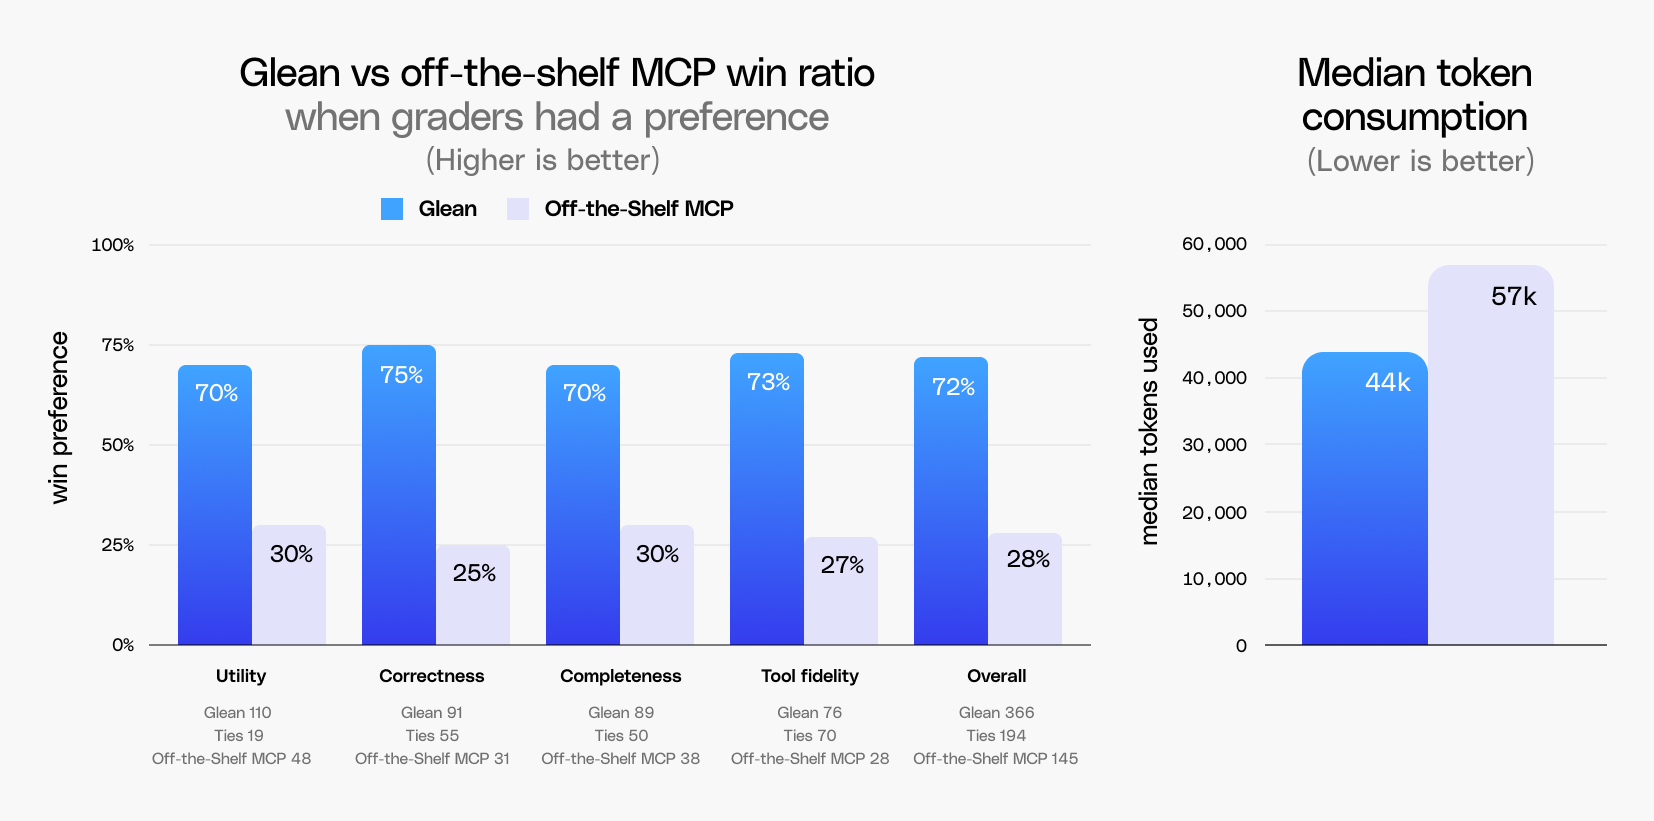
- Glean a été préféré environ 2,5 fois plus souvent que les outils MCP prêts à l'emploi
- Les outils MCP prêts à l'emploi ont consommé environ 30 % de tokens de plus que Glean
La taxe sur les tokens de la recherche fédérée
Le Model Context Protocol (MCP) est une norme ouverte qui permet aux modèles d'IA de se connecter à des outils externes pour accéder aux données et agir via une interface cohérente. Le MCP standardise la connectivité des outils, offrant aux modèles un moyen cohérent d'appeler des systèmes externes. Cependant, le MCP ne standardise pas la qualité des outils sous-jacents eux-mêmes. La conception d'un outil façonne la qualité de la réponse qu'il permet d'obtenir, ainsi que le nombre d'appels d'outils et de boucles de raisonnement nécessaires pour y parvenir.
Il existe traditionnellement deux approches pour résoudre la question du contexte d'entreprise : la fédération et l'indexation. La fédération s'appuie sur la recherche fournie par défaut par chaque connecteur individuel, en interrogeant chaque système indépendamment avec sa propre stratégie de récupération. L'indexation centralisée adopte une approche différente : les données issues de toutes les sources sont ingérées et normalisées au sein d'une couche unique, ce qui permet d'exploiter des signaux inter-applications et un classement cohérent, quelle que soit l'origine des données.
Plusieurs défis bien connus accompagnent l'adoption d'une approche exclusivement fédérée :
- La qualité de la recherche sous-jacente varie considérablement, certains outils ne prenant en charge que la récupération lexicale ou sémantique, mais pas les deux.
- Le nombre d'appels d'outils nécessaires pour collecter les données augmente, car chaque outil doit être appelé individuellement, puis le modèle doit se charger de normaliser et d'agréger ces données.
- L'accès aux données se limite à des signaux spécifiques à l'utilisateur, ce qui signifie que vous perdez la visibilité sur la manière dont ces données sont utilisées à l'échelle de l'entreprise : l'autorité de l'auteur, les liens entre documents et les autres éléments de classement inter-applications. Cela nuit à la précision des résultats.
- La latence s'accumule rapidement lorsque vous traitez plusieurs appels d'API vers différents outils. Chaque outil a sa propre latence, et vous êtes donc tributaire de l'appel d'outil le plus lent.
La recherche fédérée compense souvent en poussant l'IA à sur-collecter des données via de multiples appels d'outils et à s'appuyer sur de multiples boucles de raisonnement pour synthétiser les résultats. Ces deux approches sont coûteuses en termes de latence et de consommation de tokens, et elles tendent malgré tout à produire des réponses inexactes. Les modèles disposent d'une fenêtre de contexte fixe et d'une capacité d'attention limitée. La sur-collecte de données risque de diluer cette fenêtre et même d'agréger des informations contradictoires ou obsolètes, rendant plus difficile pour le modèle de déterminer quelles informations sont pertinentes.
À mesure que l'IA prend en charge des tâches plus longues et en plusieurs étapes, ces limites deviennent de plus en plus coûteuses. Chaque récupération manquée ou erronée peut se cumuler d'une étape à l'autre jusqu'à ce que l'artefact final ou l'action d'écriture reflète des données incorrectes. Pendant ce temps, les coûts des tokens augmentent, à mesure que la tarification des modèles de pointe s'accroît et que la consommation s'accélère, les équipes d'ingénierie d'entreprises comme Uber et ServiceNow ayant, semble-t-il, épuisé leur budget annuel d'outils de codage IA dès les premiers mois de l'année. C'est ce qui rend la bonne couche de contexte de plus en plus déterminante à l'ère de Cowork.
Conception de l'évaluation
Notre benchmark a été conçu pour isoler le contexte, en conservant Claude Cowork comme harnais avec Claude Sonnet 4.6 comme modèle par défaut, et en ne changeant que la couche de contexte : les serveurs MCP prêts à l'emploi face au serveur MCP distant de Glean, qui exploite des index centralisés et la technologie des graphes de connaissances. Nous avons évalué des serveurs MCP prêts à l'emploi courants comme Atlassian Rovo, GCP (pour les journaux), GitHub (MCP local), Gmail, Google Calendar, Google Drive, Salesforce (MCP local) et Slack.
Pour mesurer l'efficacité, nous avons gardé les modèles constants et examiné les différences de consommation de tokens entre le serveur MCP distant de Glean et les outils MCP prêts à l'emploi. Les évaluateurs ont exécuté les mêmes 175 requêtes de type Cowork sur les deux configurations et noté les réponses sur une échelle de préférence à 5 points, selon quatre critères :
- Utilité : quelle réponse utiliseriez-vous réellement dans votre travail ? Elle mesure le nombre de modifications nécessaires avant qu'une réponse soit prête à l'emploi.
- Exactitude : quelle réponse est la plus exacte sur le plan factuel ou logique ? Elle mesure si les affirmations reposent sur des sources vérifiées, citées et à jour.
- Exhaustivité : quelle production a mené la tâche à son terme de bout en bout ? Elle mesure si toutes les sous-requêtes ont été traitées, si l'analyse était exhaustive et si les réponses étaient exploitables.
- Fidélité des outils : le système a-t-il utilisé les bons appels d'outils pour répondre ? Ce critère mesure l'intégrité d'exécution : si les bons outils ont été invoqués, s'ils se sont exécutés avec succès et si des problèmes tels que des dépassements de délai, des re-demandes OAuth ou d'autres interruptions ont nécessité une intervention manuelle de l'utilisateur ou des tentatives supplémentaires pour produire une réponse.
Comment la qualité du contexte influence la consommation de tokens
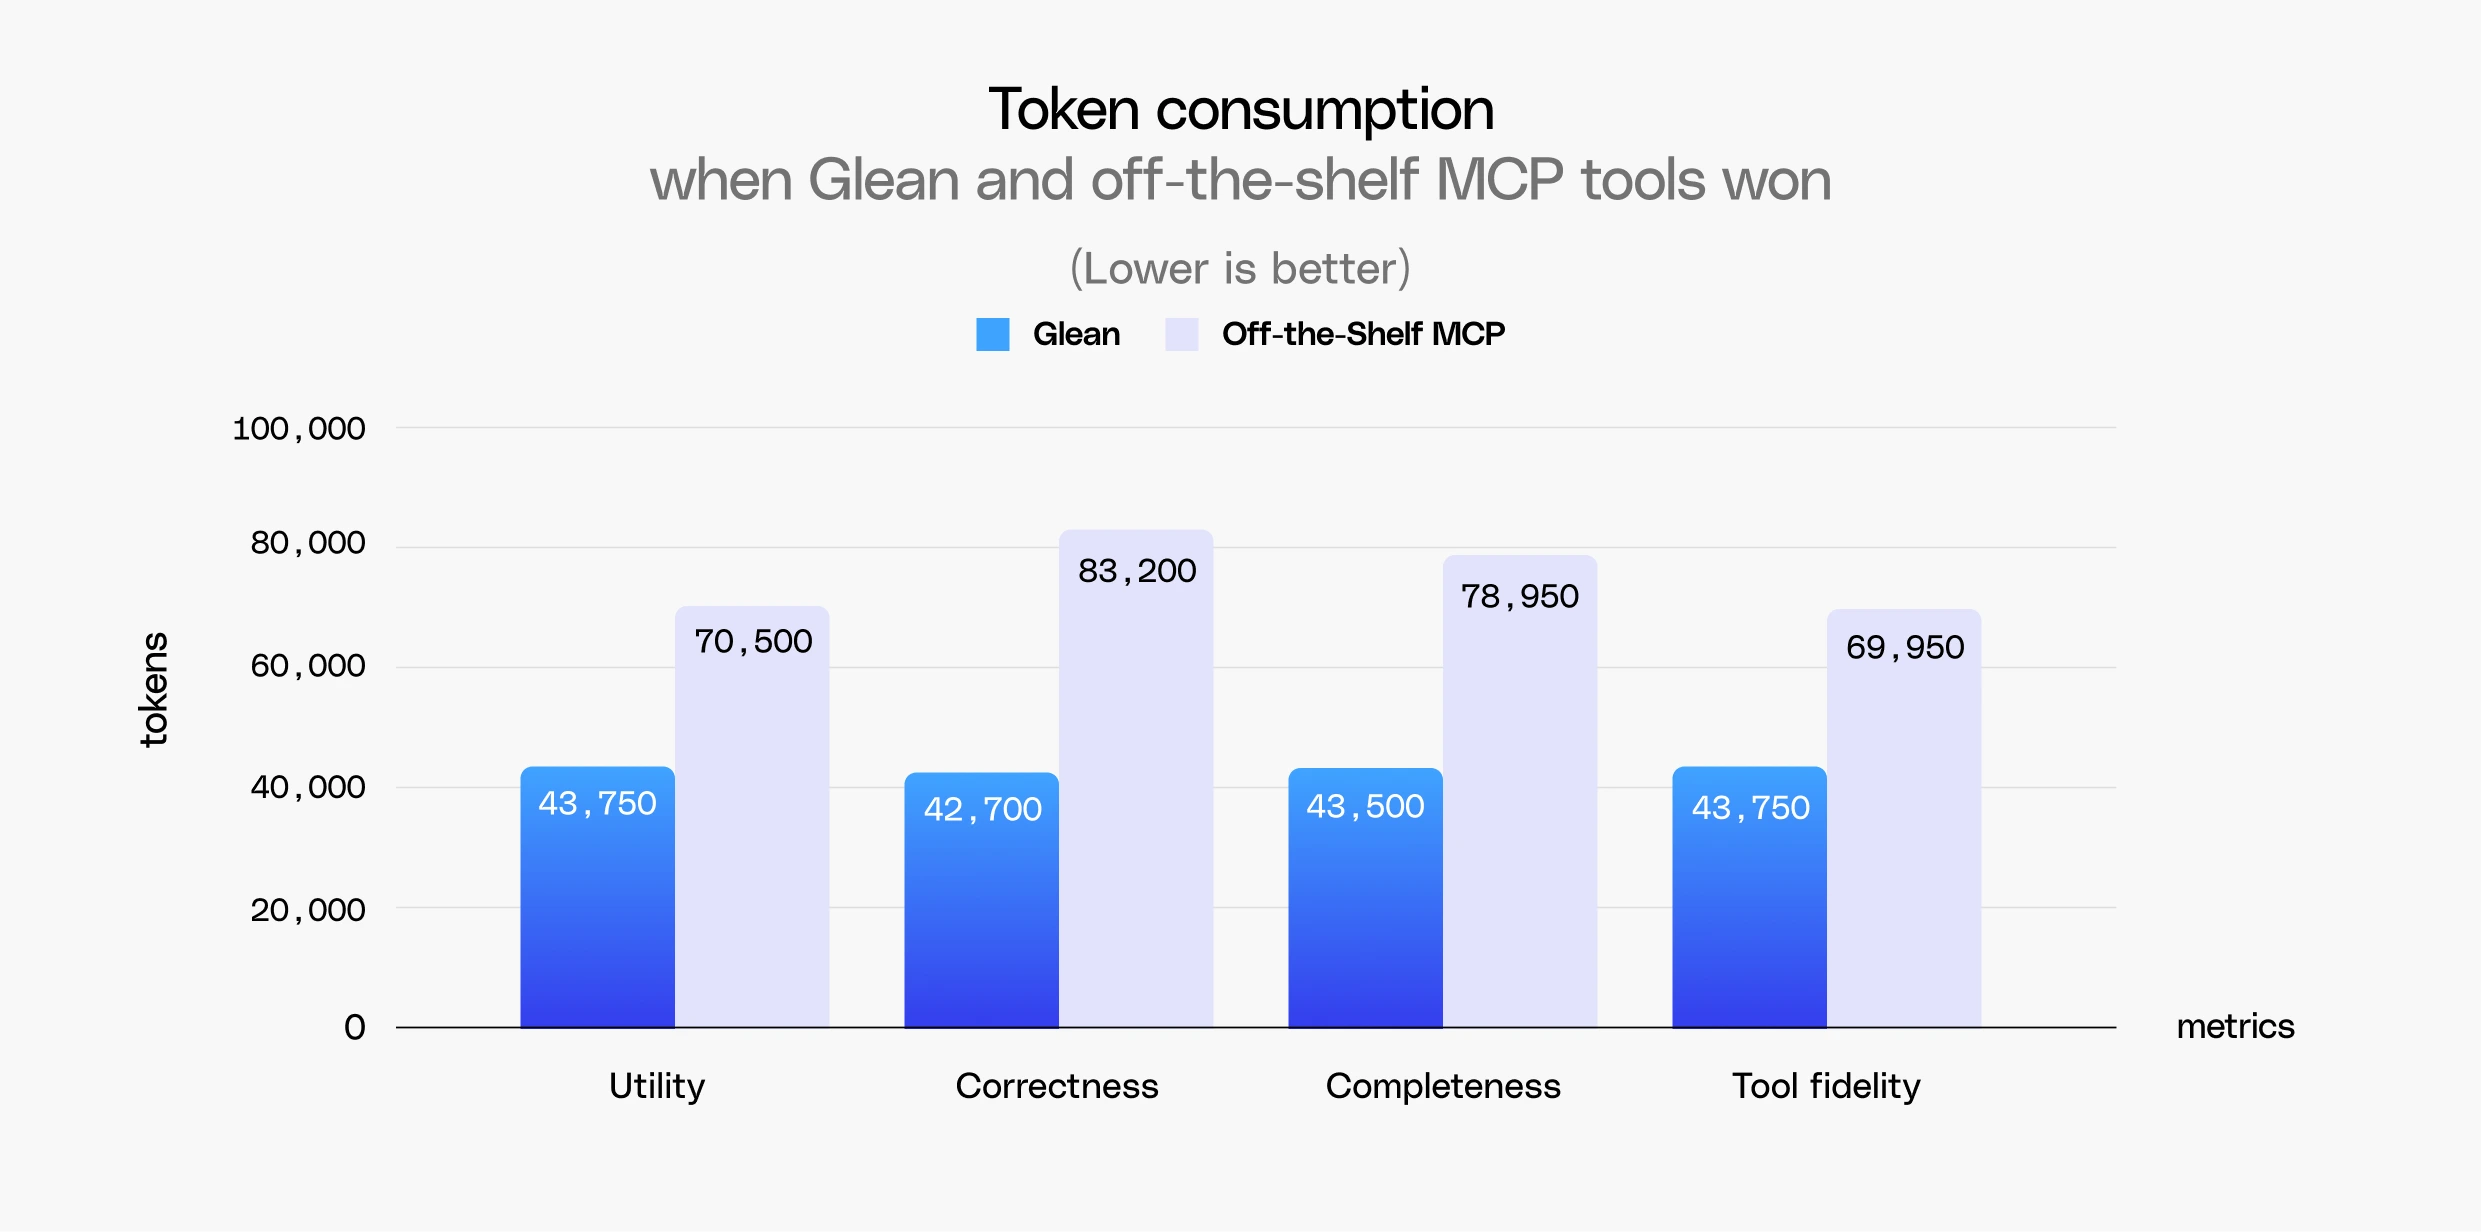
Les outils MCP prêts à l'emploi ont consommé 30 % de tokens de plus que Glean, mais le constat le plus révélateur est venu de l'analyse de la façon dont la consommation de tokens évoluait selon la qualité du résultat. Quel que soit le résultat, l'utilisation de tokens de Glean est restée stable, dans une fourchette d'environ 42 000 à 44 000 tokens, tandis que la consommation des outils MCP prêts à l'emploi augmentait pour parvenir à un bon résultat.
Lorsque Cowork a produit une réponse plus correcte avec les outils prêts à l'emploi, il a consommé environ 83 000 tokens contre 43 000 pour Glean, soit près du double des tokens utilisés par Glean pour y parvenir. Obtenir un bon résultat avec les outils prêts à l'emploi relevait de la recherche par force brute, de davantage d'appels d'outils et de davantage de boucles de raisonnement, plutôt que d'une récupération de contexte plus efficace. Ce schéma est cohérent avec les inconvénients connus des approches fédérées.
Le rôle du contexte dans la préparation opérationnelle
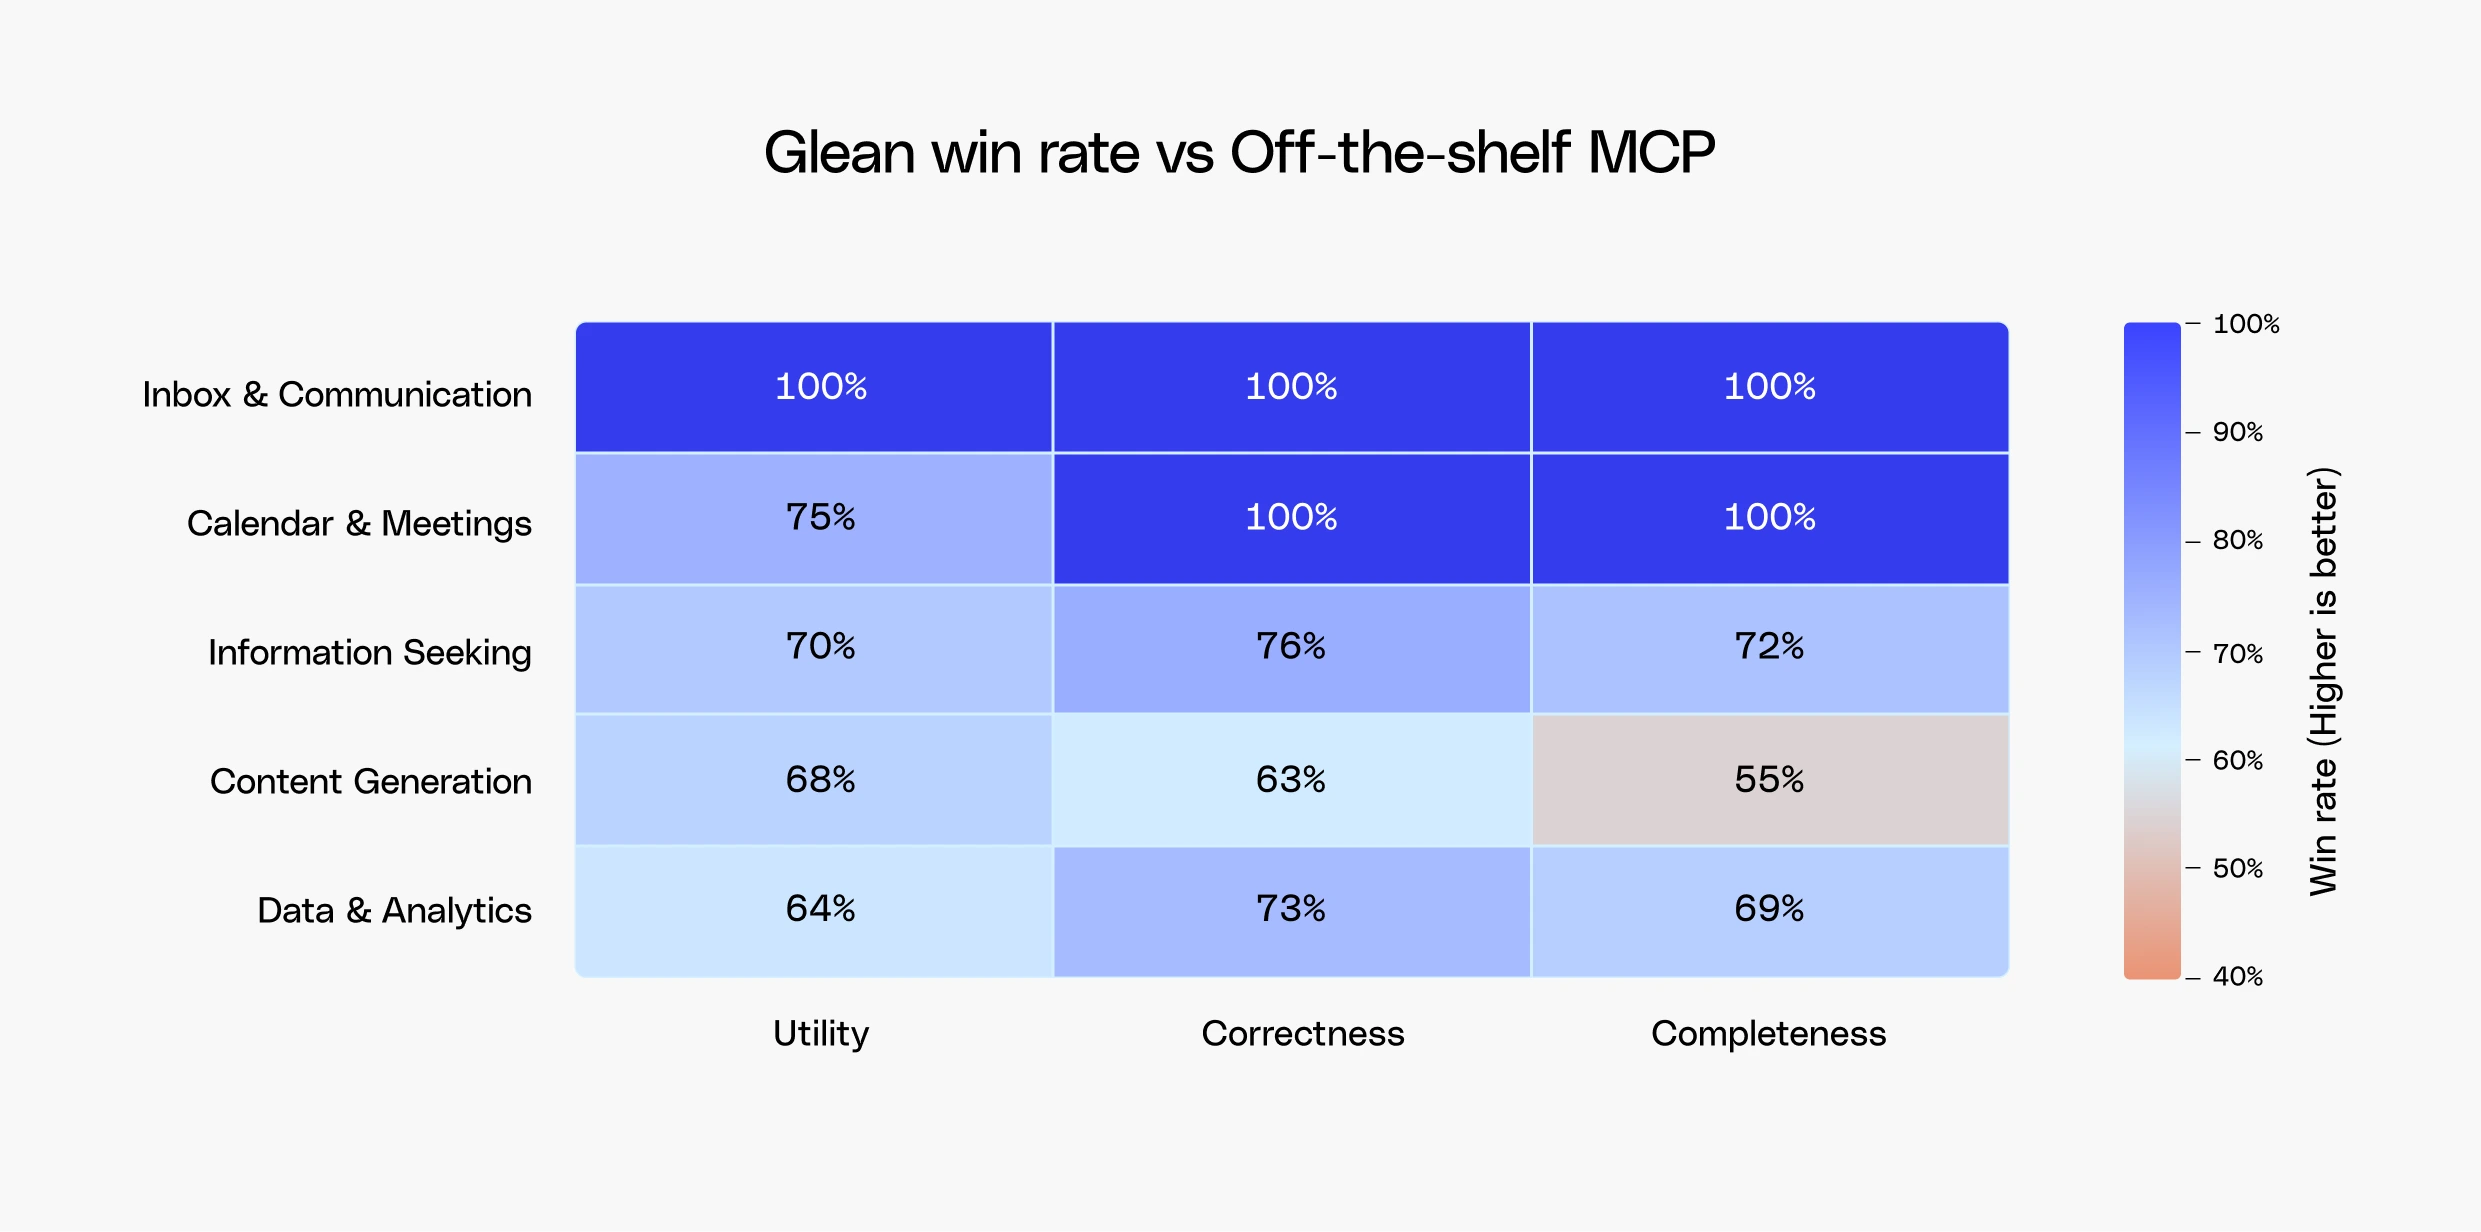
L'efficacité en matière de tokens ne raconte qu'une partie de l'histoire. Ce qui détermine si un collaborateur IA peut prendre en charge une tâche, c'est à quel point le résultat est prêt à l'emploi : combien un humain doit l'ajuster et combien d'invites de suivi sont nécessaires. Pour le déterminer, nous avons évalué Glean sur un large éventail de tâches de type Cowork qui reflètent la diversité du travail en entreprise :
- Génération de contenu : création de fichiers, notamment des documents, du HTML et des diapositives suffisamment précis pour être utilisés ou partagés avec un minimum de retouches.
- Préparation d'agenda et de réunions : gestion des agendas, préparation des réunions et prise en compte des bonnes parties prenantes et du bon contexte.
- Gestion de la boîte de réception et des communications : rédaction d'e-mails et de messages Slack qui reflètent le ton et l'audience appropriés, tout en synthétisant des listes de tâches à partir des communications récentes et des priorités stratégiques afin de faire ressortir ce qui doit être accompli.
- Analyse de données à grande échelle : analyse de données à grande échelle pour faire ressortir les tendances commerciales, prédire les résultats et soutenir la prise de décision à travers les fonctions.
- Recherche d'informations : résumer des informations, cartographier des processus, identifier qui est responsable d'un travail et faire ressortir le document canonique ou la définition de métrique de référence, une catégorie de requêtes qui reste très pertinente à l'ère des collaborateurs IA.
Glean a surpassé les serveurs MCP prêts à l'emploi dans chaque catégorie, démontrant la puissance du contexte pour permettre à l'IA de gérer avec précision l'ensemble des besoins de productivité personnelle et professionnelle en entreprise.
Le découpage par catégorie de requête offrait un angle d'analyse des résultats, mais nous voulions aussi comprendre comment l'importance du contexte évoluait à mesure que la complexité des tâches augmentait. Des caractéristiques telles que le nombre de tokens de réponse, le nombre de boucles de raisonnement et le nombre d'appels d'outils en lecture ou en écriture ont servi d'indicateurs de complexité, nous donnant un moyen de segmenter les tâches au-delà de la seule catégorie. Sur les tâches plus simples, Glean l'a emporté 66 % du temps, mais à mesure que la complexité augmentait, ce chiffre est monté à 73 %. Cela illustre à quel point un contexte bien conçu devient de plus en plus important lorsque le travail nécessite davantage d'étapes et de sources pour être mené à bien.
3 requêtes mettant en valeur la puissance du contexte
Recherche les publications récentes sur les lancements et les communications clients, résume les principales observations et enseignements, et donne-moi une newsletter HTML que je peux partager avec l'équipe de design.
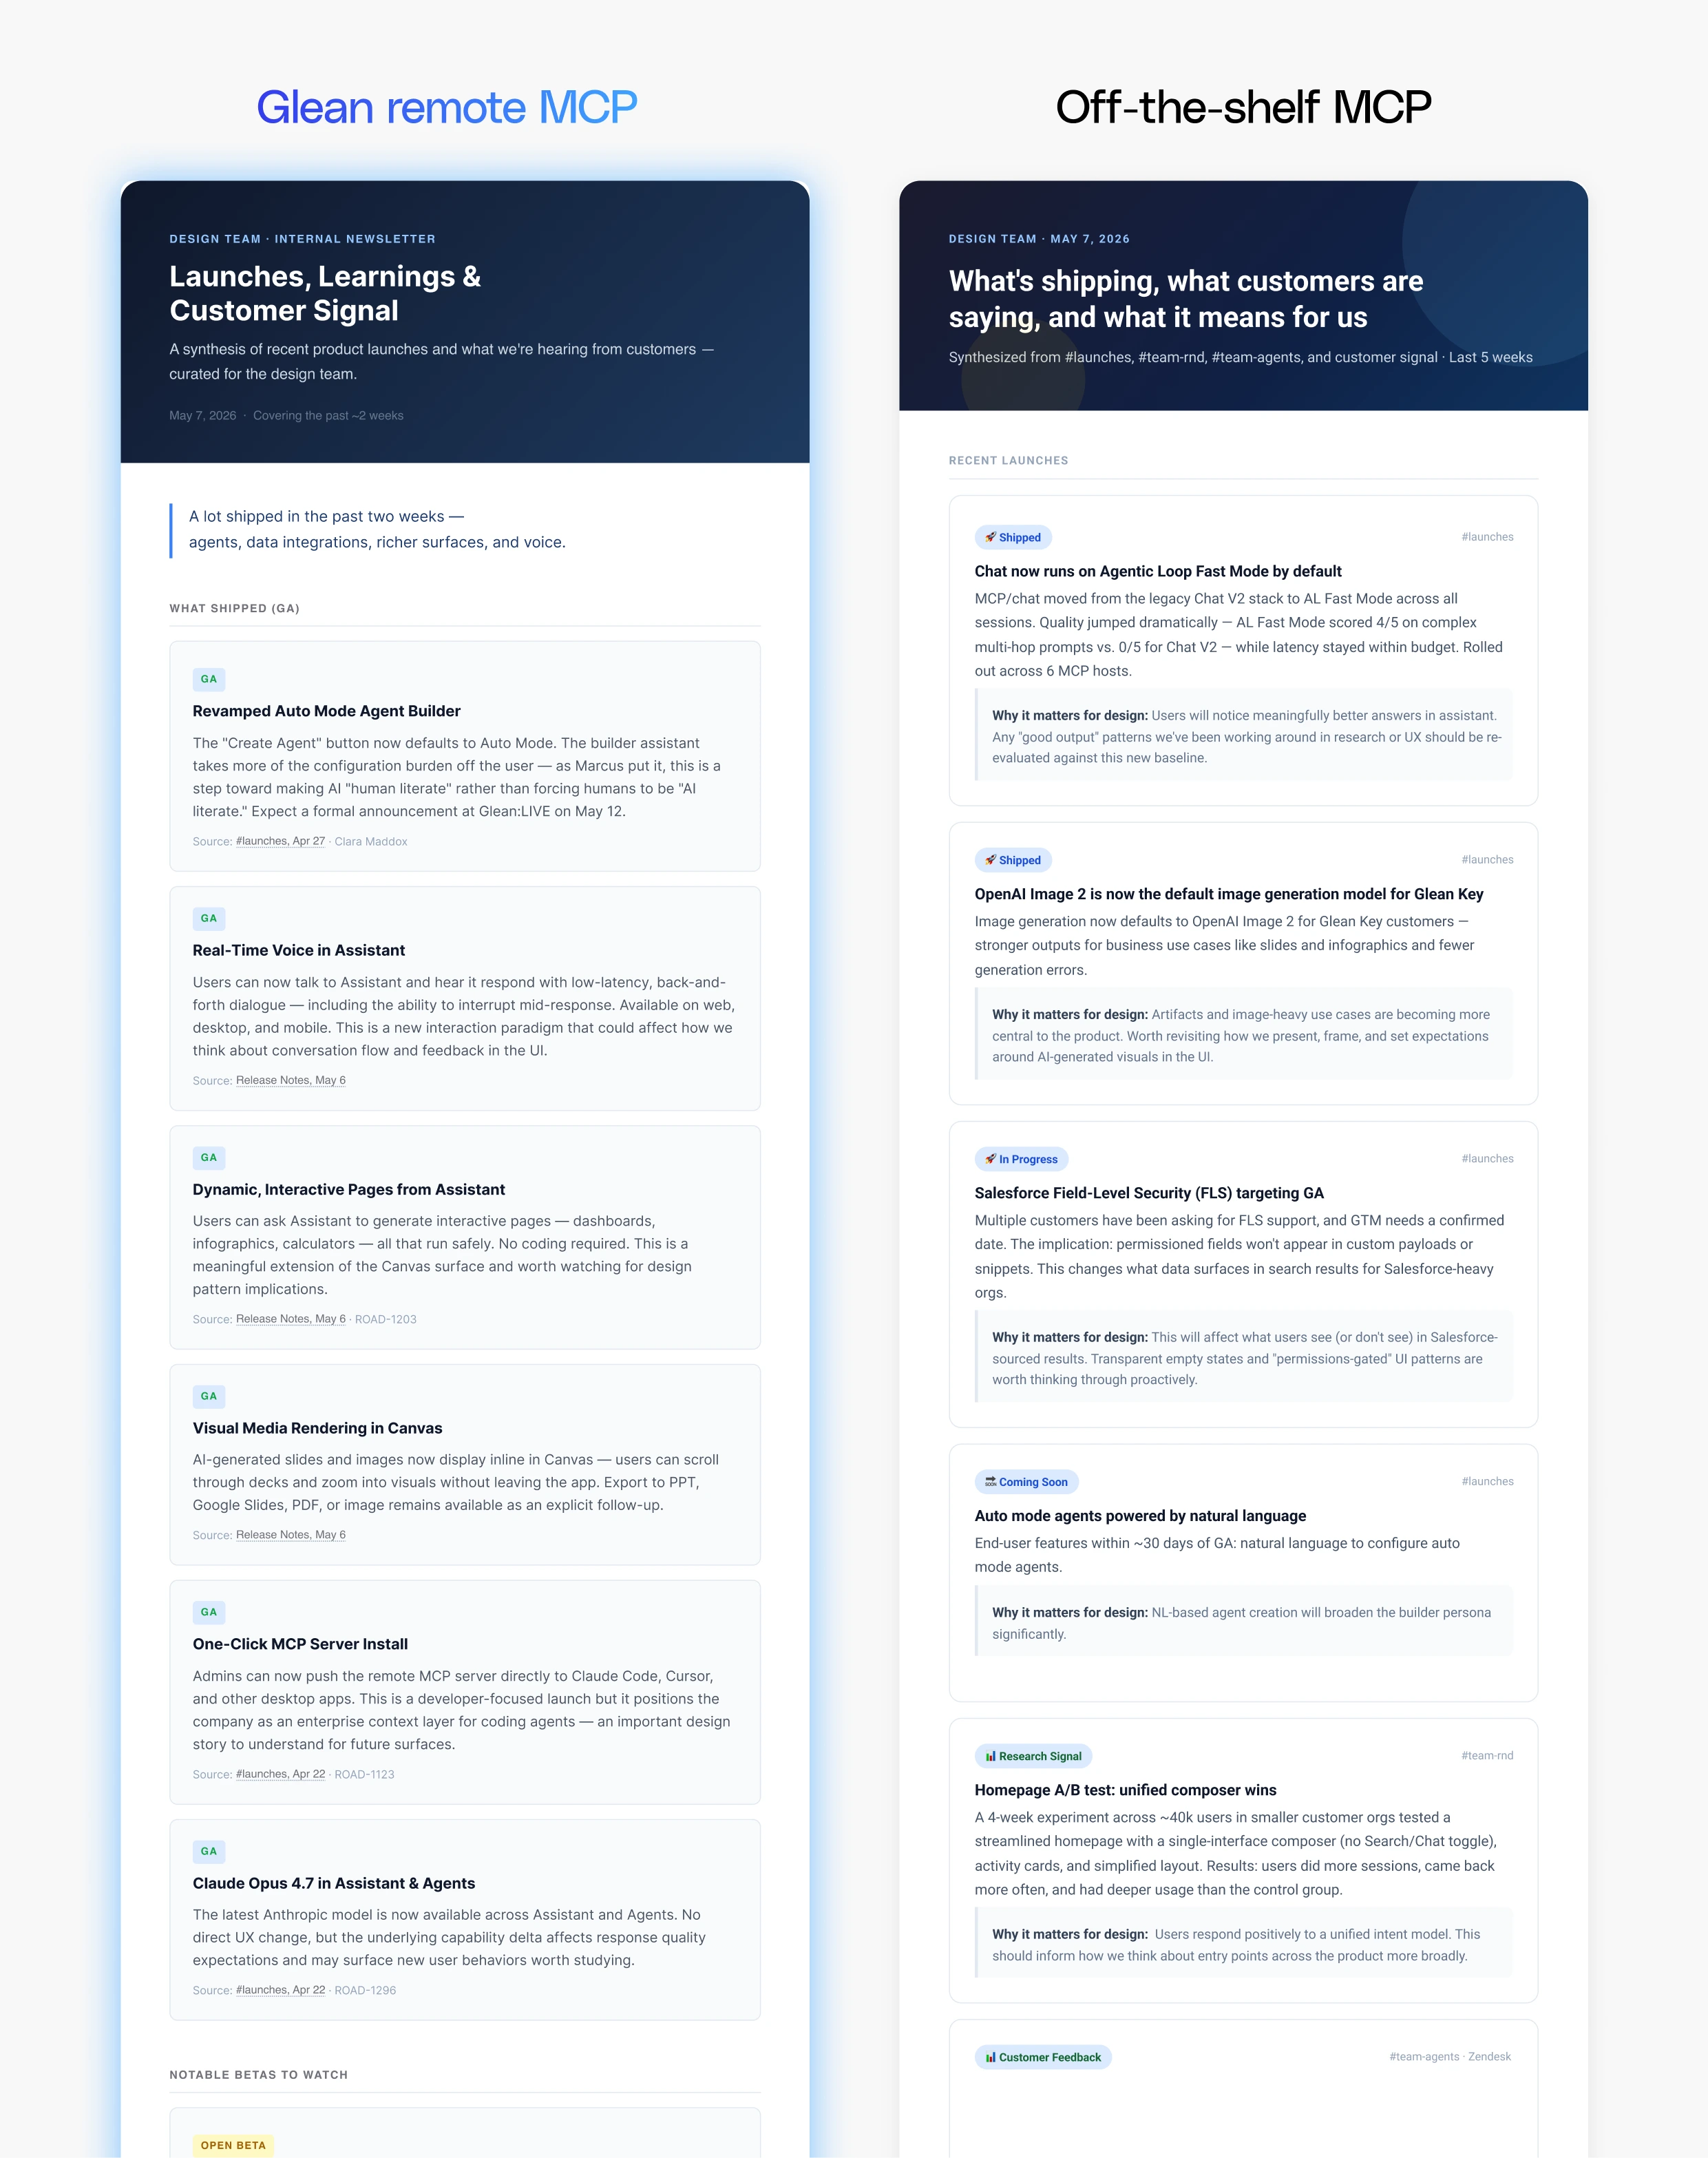
Lorsqu'il s'agit de créer des artefacts HTML interactifs, la qualité du contexte sous-jacent façonne directement la richesse du résultat. Dans une tâche nécessitant un résumé des publications récentes sur les lancements et des communications clients, Glean a fait ressortir six fonctionnalités livrées contre deux pour les serveurs MCP prêts à l'emploi, et a ancré son analyse dans des citations directes de clients qui faisaient émerger des thèmes significatifs sur l'expérience produit. Les outils MCP prêts à l'emploi manquaient du signal client, produisant un résultat plus superficiel qui nécessitait beaucoup plus de retouches pour être exploitable par une équipe de design produit, un écart qui découle directement de la capacité de Glean à synthétiser les signaux à travers les sources.
Trouve les thèmes de feedback client les plus récents sur la page d'accueil et crée un document résumant les 5 principaux thèmes avec des exemples de citations.
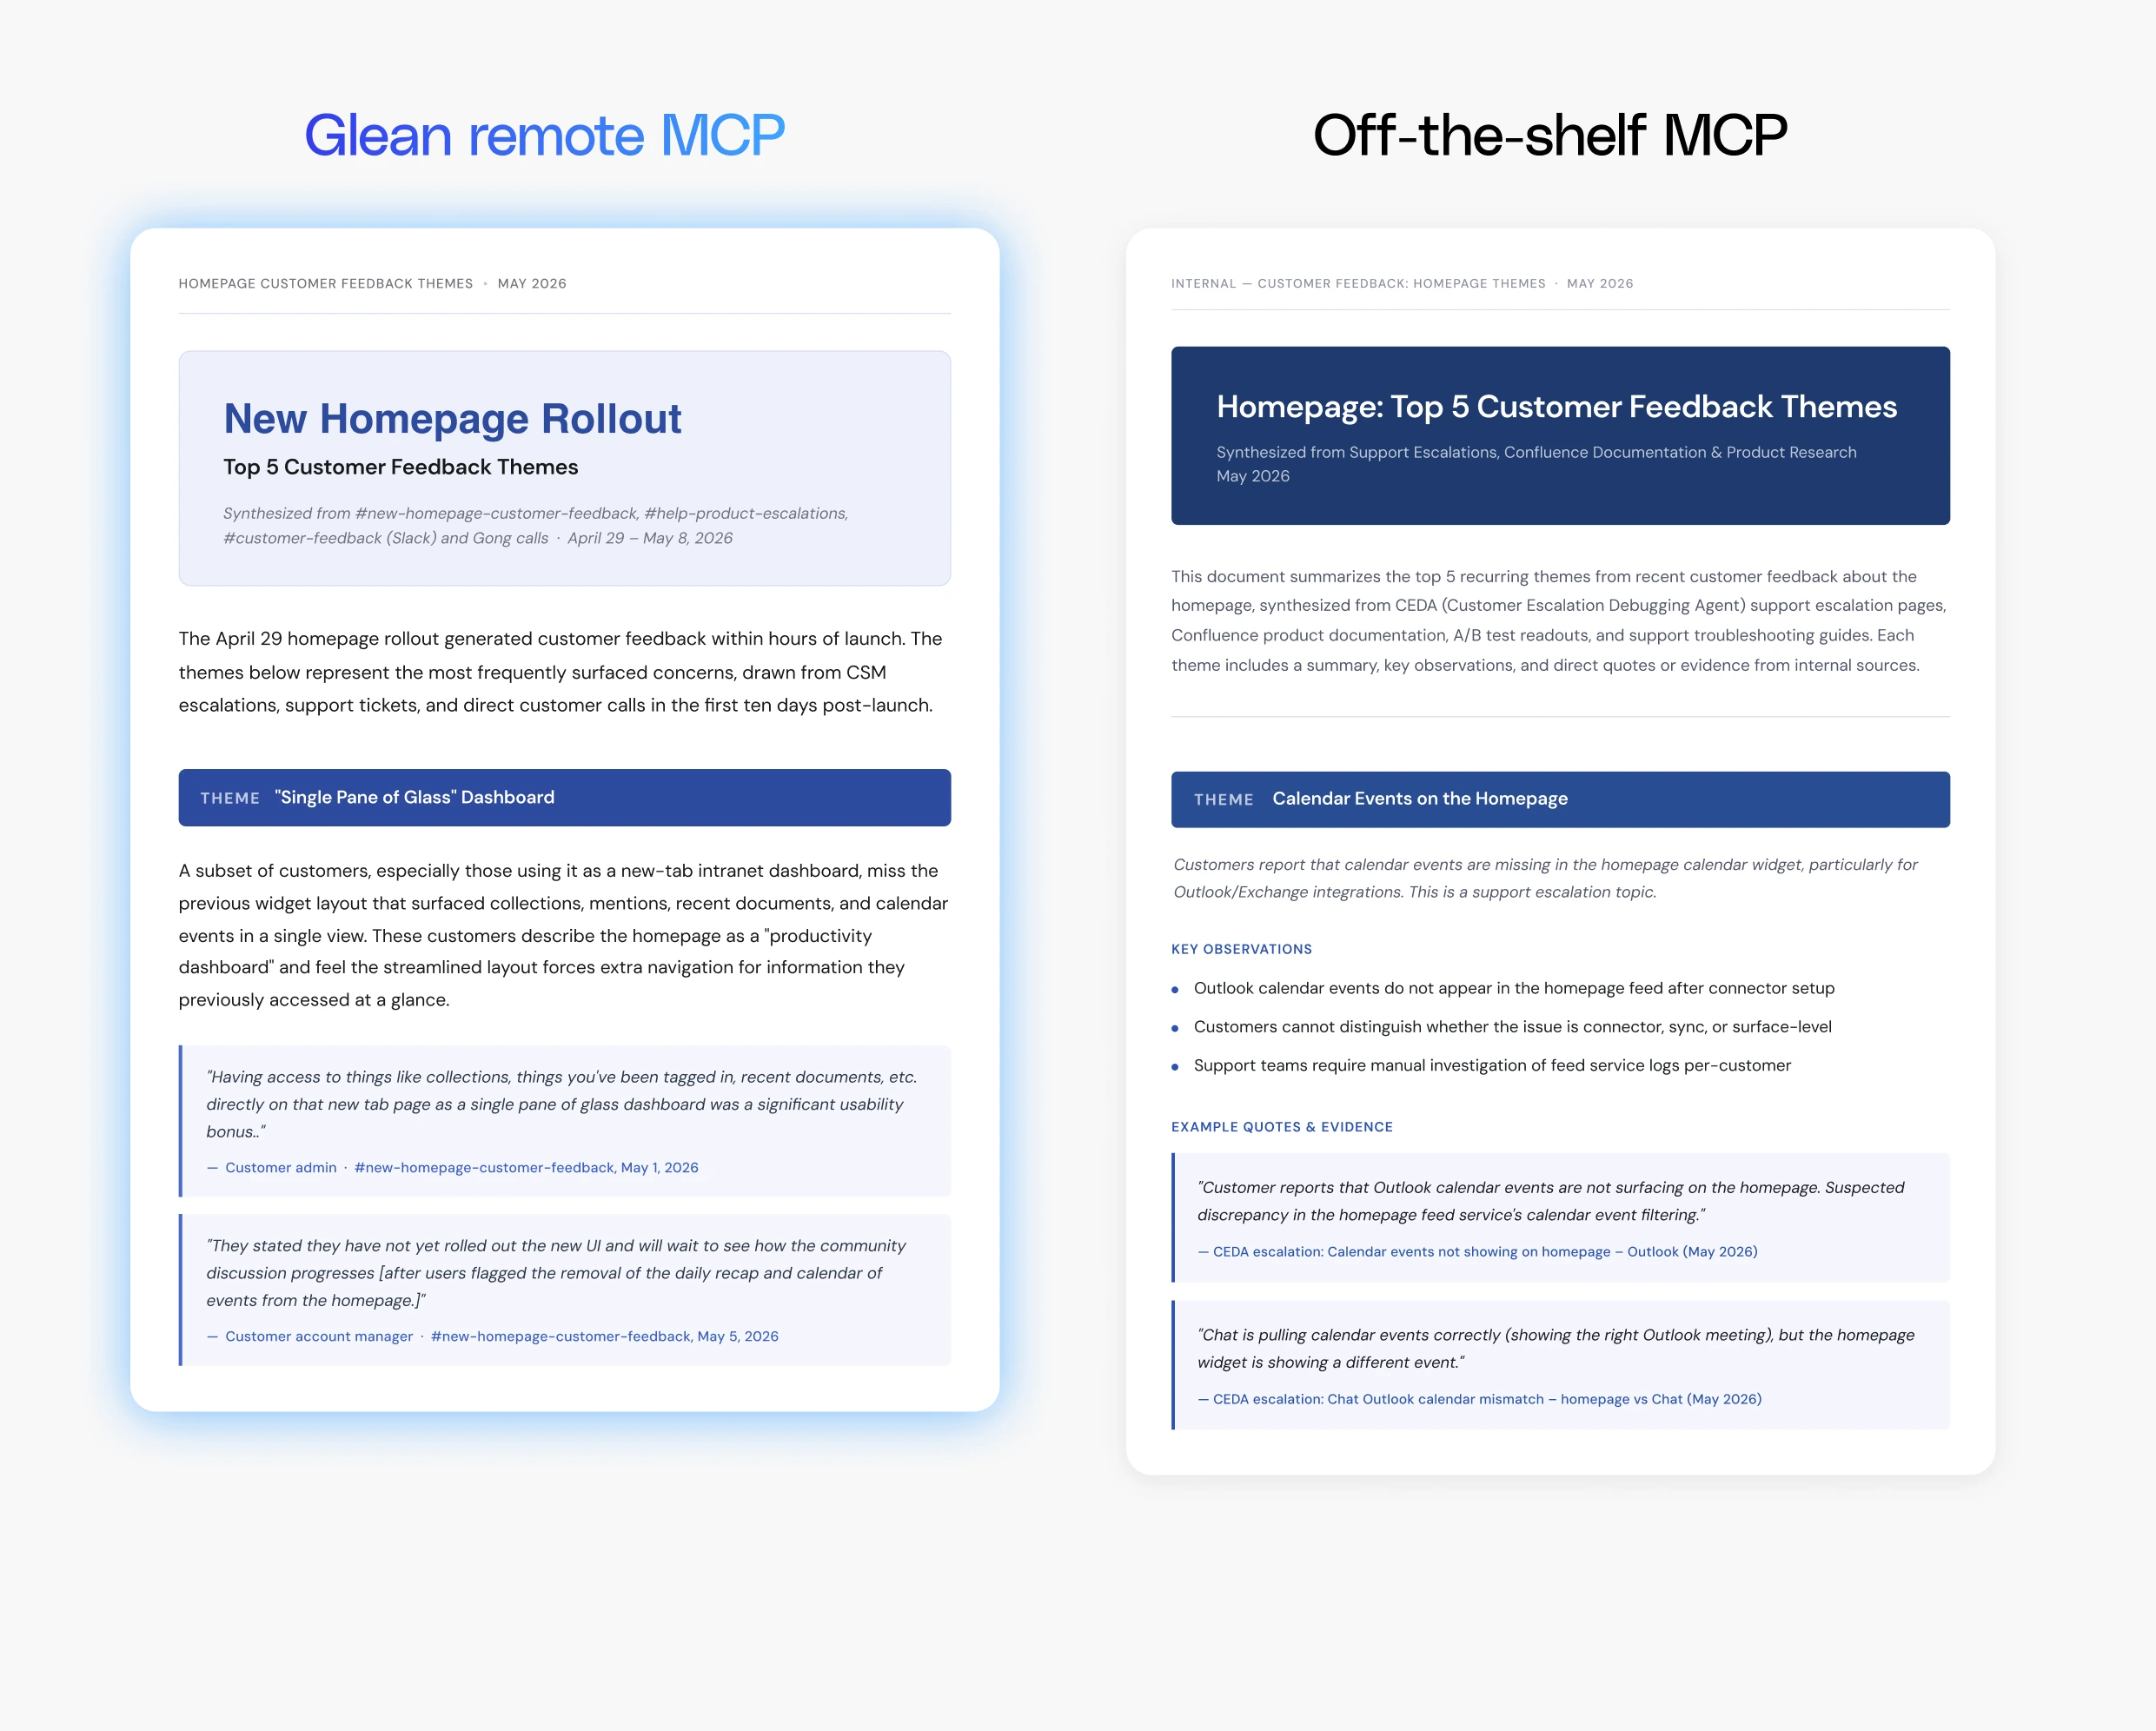
Lorsqu'on lui a demandé de faire ressortir les thèmes de feedback client les plus récents, Glean a synthétisé les données à travers les sources pour identifier les principales demandes des clients, notamment une interface unique et une plus grande facilité à trouver la fonction de recherche. Les outils MCP prêts à l'emploi, en revanche, ont fait ressortir des demandes produit sans rapport avec le déploiement de la nouvelle page d'accueil, mais plutôt des problèmes de connecteurs, comme des événements d'agenda qui ne s'affichaient pas et des contrôles d'indexation de données. Les outils prêts à l'emploi ont également échoué sur l'exhaustivité, ne fournissant pas d'exemples précis provenant de clients mais plutôt des extraits de tickets d'assistance. L'un des défis portait sur la qualité des outils, car les serveurs prêts à l'emploi ont rencontré des erreurs pendant l'exécution qui ont empêché l'appel réussi de tous les outils pertinents, limitant la couverture et la qualité.
D'après les résultats de recherche, voici ce que j'ai trouvé pour les alertes SSAT de la semaine dernière (semaine du 28/04 au 04/05, couverte par Alex Chen) :
- Maxium Corp — Les documents indexés sur Google Drive ont fortement augmenté, avec une hausse correspondante de leur présence dans le top 10 des résultats. Le suivi de la cause racine était lié dans le fil ssat-alerts.
- Ironbridge Health et Provo Systems — Les deux ont chuté pendant une journée mais se sont rétablis d'eux-mêmes. La note indique qu'ils approfondiront la question si cela persiste.
Cela provient d'un document de suivi d'astreinte/qualité de recherche hébergé sur Drive. Souhaitez-vous que j'approfondisse l'un de ces points, comme les fils Slack associés ?
Le canal #ssat-alerts a reçu des alertes presque tous les jours la semaine dernière. La publication du 29 avril comptait 13 réponses — laissez-moi explorer ce fil et les autres pour identifier quels déploiements spécifiques ont été signalés. Chaque alerte comporte un fichier CSV avec la liste des déploiements. Laissez-moi essayer de les télécharger pour obtenir les noms réels. Le contenu du CSV ne se charge pas directement. Laissez-moi essayer de récupérer les fichiers et de rechercher également toute mention directe de noms de déploiements dans le canal. Le contenu du CSV n'est pas accessible directement. Laissez-moi examiner le fil Maxium Corp qui était référencé, et essayer aussi de trouver d'autres mentions de clients/déploiements. D'après les fils que j'ai lus, voici ce que j'ai trouvé pour la semaine dernière (28 avr.–2 mai) :
- Maxium Corp prod était le déploiement signalé dans les alertes SSAT, apparaissant dans l'ensemble des 5 CSV d'alertes quotidiennes du bot Acme dans #ssat-alerts. L'alerte s'est déclenchée plusieurs jours consécutifs, ce qui a motivé l'escalade.
- La discussion dans le fil s'est concentrée sur la cause : une hausse du nombre de documents Google Drive indexés entraînant une surreprésentation des résultats Google Drive, nuisant à la qualité de recherche. Jordan Park a enquêté et a relayé l'information dans #internal-maxium-corp, où Marcus Reyes a confirmé qu'un support Google Drive supplémentaire avait récemment été activé pour le déploiement Maxium Corp — ce qui a élargi le périmètre d'exploration et modifié la répartition des résultats.
Une remarque : le CSV du 1er mai était nettement plus volumineux (~446 octets contre ~208 octets les autres jours), il se peut donc que des déploiements supplémentaires aient été signalés ce jour-là en particulier, mais ces noms n'apparaissent pas dans la discussion Slack — ils figureraient dans le CSV joint à ce message.
Cette réponse a été légèrement modifiée et des pseudonymes ont été utilisés afin de protéger les noms des clients et les données sensibles.
Si le MCP prêt à l'emploi a su explorer en profondeur une alerte spécifique pour un client, il n'a pas d'abord su prendre du recul pour identifier l'ensemble complet des clients affectés par l'alerte avant de commencer le dépannage. L'objectif principal de la requête étant une analyse exhaustive des données pour tous les clients concernés, la capacité de Glean à dresser le tableau complet avant d'entrer dans le détail en a fait la réponse la plus précise et la plus complète.
Le contexte à l'ère de la collaboration IA
Les index centralisés et le graphe de connaissances de Glean ont surpassé les serveurs MCP prêts à l'emploi en matière de qualité comme d'efficacité. Sur l'utilité, l'exactitude, l'exhaustivité et la qualité d'exécution, Glean a été préféré environ 2,5 fois plus souvent, avec un écart qui se creuse à mesure que la complexité des tâches augmente. Sur la consommation de tokens, les serveurs MCP prêts à l'emploi ont nécessité 30 % de tokens en plus en moyenne, tandis que Glean maintenait une utilisation de tokens constante quelle que soit la qualité du résultat. Le MCP prêt à l'emploi consommait près du double de tokens à mesure qu'il devait travailler plus dur pour produire une réponse correcte.
À mesure que les entreprises déploient l'IA à grande échelle sur des travaux plus longs et plus complexes, dans un contexte de hausse rapide des coûts des modèles de pointe, la conception de la couche de contexte devient un facteur déterminant à la fois pour la qualité et pour l'économie de l'IA au travail. Avec Glean, les entreprises indexent leurs données et construisent leurs graphes de connaissances une seule fois, puis utilisent le MCP pour relier ce contexte à toutes les surfaces où le travail se déroule, de Claude Cowork pour la productivité individuelle aux IDE basés sur l'IA pour l'ingénierie, démultipliant ainsi le retour sur cet investissement à l'échelle de l'entreprise.
