






Les harnais, la logique d'exécution qui entoure les modèles, génèrent des gains dans les performances des agents de longue durée à travers tout le secteur. LangChain a amélioré Terminal-Bench de +13,7 points grâce à des modifications du harnais uniquement, le modèle restant constant. Vercel a supprimé 80 % des outils de son agent et a constaté une fiabilité accrue avec une latence 3,5 fois inférieure. Dans ces cas, l'écart de performance provenait du harnais, et non du modèle.
Nous traversons une période d'itération rapide des harnais, impulsée par une évolution de ce que l'on attend des agents. Les équipes poussent les agents vers des tâches plus longues et multi-étapes, et constatent que les architectures de première génération se dégradent rapidement. Le schéma courant d'une invite système unique (souvent plus de 20 000 tokens d'instructions conditionnelles) accompagnée de 20 à 40 schémas d'outils injectés en amont ne tient pas. Chez Glean, nous avons réduit notre propre invite système de plus de 45 % en déplaçant les instructions vers des compétences qui se chargent progressivement. La différence se révèle rapidement sur des tâches comme le remplissage d'un appel d'offres de 200 questions, où chaque question exige une recherche multi-sources indépendante, et où les réponses compilées doivent être validées puis réécrites dans une feuille de calcul.
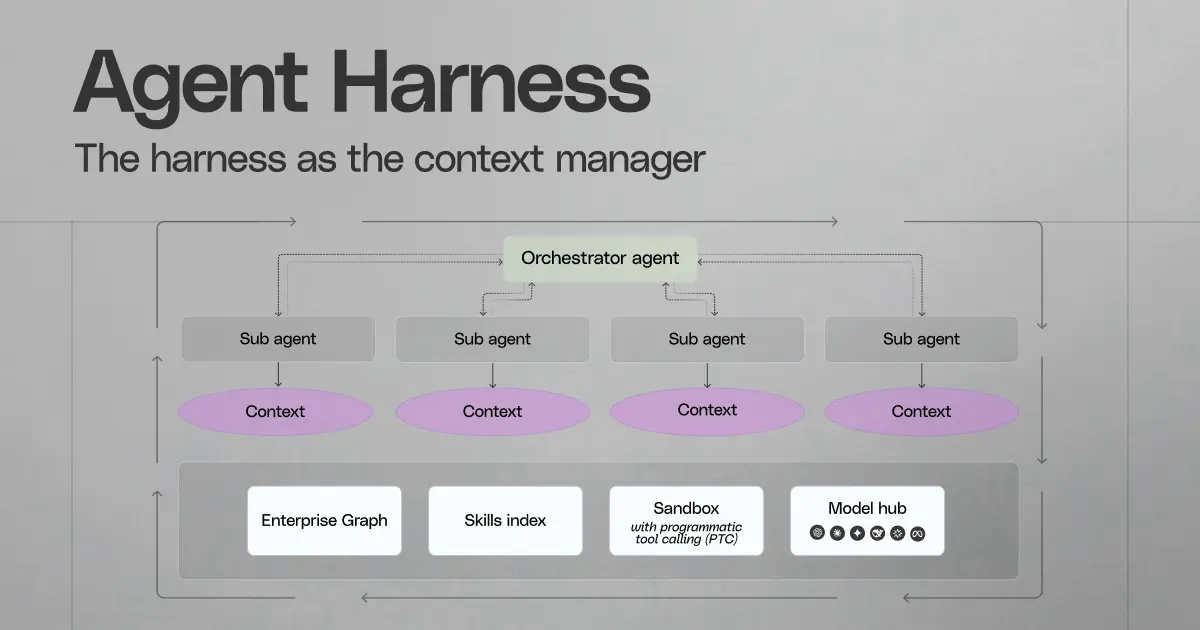
On a l'impression que les harnais évoluent à mesure que les modèles gagnent en capacités. Ce n'est pas le seul moteur. Les harnais sont reconstruits parce que nous confions davantage de travail aux agents, ce qui nécessite plus de contexte. Chaque appel d'outil supplémentaire, invocation de compétence, résultat de recherche et sortie d'exécution s'ajoute à la fenêtre de contexte. C'est un problème que nous connaissons bien chez Glean. Nos racines plongent dans la recherche d'entreprise, où le défi central a toujours été de restreindre un vaste espace informationnel au contexte précis nécessaire pour accomplir la tâche avec exactitude. De même, à mesure que le volume et la variété du travail transitant par un agent augmentent, la gestion du contexte devient le problème d'ingénierie central. Le harnais est, en son cœur, un système distribué de gestion du contexte.
Chez Glean, perfectionner notre harnais est une quête permanente. Nous en sommes désormais à notre troisième itération, chaque reconstruction reflétant de nouvelles évolutions des capacités des modèles, de la technologie et de la manière dont l'IA est utilisée à l'échelle de l'entreprise. Cet article aborde quatre changements dans la conception des harnais :
- L'appel d'outils programmatique (PTC) dans des sandboxes déplace la logique de workflow vers du code en sandbox, conservant l'état intermédiaire dans des variables et des fichiers plutôt que dans l'invite.
- Les sous-agents décomposent une boucle d'agent unique en contextes d'exécution isolés, chacun disposant de sa propre fenêtre de contexte.
- La compaction préserve l'état porteur de la conversation tout en déplaçant les sorties intermédiaires brutes vers des systèmes de fichiers.
- La découverte des compétences axée sur la recherche dissocie la découverte des outils et des compétences de l'hydratation des schémas, en ne récupérant les définitions complètes qu'au moment de l'exécution.
Dans ce blog, nous allons passer en revue chacun de ces changements et la manière dont notre harnais a évolué au fil du temps pour mieux faire évoluer le contexte.
Le code comme primitive d'exécution principale
Le code devient la primitive d'exécution principale des agents. À mesure que le travail se complexifie, les agents doivent parcourir des ensembles de résultats, se ramifier selon des conditions, filtrer et joindre des données, hiérarchiser des preuves, regrouper des opérations et paralléliser des étapes indépendantes. Le code exprime cette logique plus naturellement qu'une série d'appels d'outils conversationnels où le modèle redérive son plan à partir de l'historique de la conversation à chaque tour.
Glean utilise le PTC pour déplacer cette logique de workflow vers un environnement d'exécution en sandbox. Les outils sont exposés sous forme de fonctions appelables en Python, de sorte que le modèle écrit un petit programme qui récupère, filtre, se ramifie, boucle, écrit sur le disque et agit en une seule exécution plutôt qu'à travers des dizaines de tours conversationnels. 20 appels d'outils peuvent se produire au sein d'une seule exécution en sandbox, et l'orchestrateur ne voit que le résumé et les métadonnées structurées qui en reviennent. Les données intermédiaires restent dans des variables et des fichiers Python.
En intégrant le PTC dans le bon harnais, nous avons pu réaliser les gains suivants :
- Latence. Les opérations indépendantes peuvent être regroupées et parallélisées au sein d'une seule exécution de code plutôt que sérialisées sur des allers-retours avec le LLM.
- Fiabilité. Les boucles, les filtres, les jointures et les ramifications conditionnelles sont plus robustes en code que dans une chaîne fragile de tours de conversation où le modèle reconstruit son plan à partir de l'historique à chaque étape. Cela permet aussi à l'agent de se remettre plus facilement des erreurs, car il dispose de traces de pile qu'il peut inspecter.
- Cohérence. Les scripts peuvent être enregistrés comme compétences, ce qui facilite la réalisation de la même séquence d'appels d'outils pour des tâches courantes, tant au niveau de l'entreprise que personnel.
- Efficacité du contexte à grande échelle. Seuls le résumé ou les sorties finales reviennent à l'orchestrateur, et non chaque artefact intermédiaire. Cela signifie que des analyses plus vastes, des opérations en masse et des tâches de longue durée nécessitant de paginer, stocker, calculer et revisiter l'état deviennent réalisables, car l'agent dispose d'une portée de programme et d'un système de fichiers en dehors de la fenêtre de contexte.
Les sous-agents comme frontières d'isolation du contexte
Les sous-agents ne sont pas nouveaux dans le harnais de Glean, mais le PTC a élargi leur échelle et leur fiabilité. L'agent orchestrateur peut écrire du code pour lancer de manière programmatique des sous-agents en parallèle.
Les sous-agents deviennent particulièrement puissants lorsque l'agent orchestrateur doit appliquer le même niveau d'analyse à une large collection d'éléments indépendants, comme la recherche sur des centaines de clients ou l'analyse de milliers de tickets d'assistance. Dans ces cas, chaque sous-agent peut s'exécuter de manière indépendante sur sa propre tâche avec sa propre fenêtre de contexte et son propre budget de tokens, tandis que l'agent orchestrateur fournit les instructions partagées sur la manière d'effectuer le travail via un modèle d'invite ou une définition de tâche programmatique. Avec les sous-agents, la profondeur de l'analyse s'améliore, car chacun peut concentrer son attention sur le contexte et la tâche à accomplir sans distraction.
Ce schéma permet au système de déployer un raisonnement répétable à grande échelle sans surcharger une seule fenêtre de contexte, et il fait écho aux idées des Recursive Language Models où des agents de haut niveau décomposent le travail et délèguent des tâches délimitées à des travailleurs de niveau inférieur.

Stratégies de compaction pour préserver l'état de travail
Si les sous-agents aident à répartir le travail sur de nombreuses tâches indépendantes, en maintenant les lignes de raisonnement parallèles isolées et gérables, ils ne résolvent pas la question de l'accumulation du contexte au fil du temps au sein d'un seul agent. Dans Glean, nous avons constaté qu'environ 5 % des requêtes atteignaient les limites de la fenêtre de contexte.
Pour résoudre ce problème, nous avons conçu une approche de compaction qui préserve les parties de l'état de la conversation essentielles à la poursuite de l'exécution : l'intention de l'utilisateur, les décisions prises jusqu'à présent, les approches qui ont échoué, les prochaines étapes planifiées et les sorties d'outils récentes à forte valeur. Tout le reste est soit résumé, soit déplacé hors de la fenêtre de contexte vers le système de fichiers. L'objectif est d'obtenir une représentation compressée mais sémantiquement complète de l'état de la tâche, qui permet à l'agent de reprendre là où il s'était arrêté après de nombreux tours.
Il existe deux couches techniques expliquant le fonctionnement concret de ce mécanisme :
- La première est la compaction de la conversation. Nous condensons les échanges bruts des tours précédents avec ce que l'utilisateur a demandé, ce que l'agent a tenté, ce qui a fonctionné, ce qui n'a pas fonctionné et ce qu'il prévoit de faire ensuite.
- La seconde est la compaction des sorties d'outils. Les sorties d'outils volumineuses sont écrites dans des fichiers au sein du système de fichiers du sandbox et réduites à des résumés accompagnés de chemins de fichiers.
La compaction et les sous-agents se renforcent mutuellement. Les sous-agents réduisent la quantité de détails non pertinents que l'orchestrateur voit, en gardant le travail intermédiaire dans des contextes isolés. La compaction gère ce qui reste dans le propre historique de l'orchestrateur, préservant la cohérence de la tâche dans le temps. L'une gère le contexte spatialement, l'autre temporellement.
Découverte axée sur la recherche pour les compétences
Les compétences émergent comme un standard ouvert pour conditionner une expertise réutilisable. Cette approche présente des avantages, notamment la divulgation progressive où l'agent précharge le nom et la description de la compétence, puis ne récupère la charge utile complète que lorsque la tâche le requiert réellement.
Nous avons toutefois constaté que la divulgation progressive à elle seule ne va pas assez loin à l'échelle de l'entreprise. Il n'est pas réaliste pour un agent de parcourir des centaines d'outils ou de compétences, car même des descriptions d'une ligne par élément s'accumulent et créent du bruit que l'agent doit traiter dans son raisonnement, pour des requêtes où la plupart de ces capacités sont non pertinentes. C'est pourquoi nous introduisons un index couvrant toutes les compétences et ne chargeons dans le contexte que celles qui sont pertinentes.
La découverte dans Glean repose sur une approche en trois phases :
- Rechercher dans l'index. Le modèle reconnaît qu'il a besoin d'une capacité et interroge l'index. Notre recherche de compétences est plus puissante qu'une simple recherche sémantique, car nous exploitons les signaux du graphe d'entreprise pour établir un classement basé sur le créateur, l'utilisation et bien plus encore. L'objectif est de trouver la bonne compétence même dans les scénarios où plusieurs personnes créent et partagent des compétences similaires.
- Consulter la liste restreinte et les descriptions légères. L'index renvoie une liste restreinte de candidats avec leurs noms, descriptions et indications d'exécution. C'est la première fois que le modèle voit un détail concernant ces capacités. Il peut alors sélectionner dans cette liste ciblée pour accomplir sa tâche.
- Hydrater le schéma complet au moment de l'exécution. Ce n'est que lorsque le modèle s'engage à exécuter une compétence spécifique que le schéma complet ou le fichier skill.md entre dans le contexte.
Avec Glean, l'agent ne paie jamais la taxe de contexte liée au parcours de l'ensemble des capacités disponibles. Les descriptions n'apparaissent que pour les capacités que le modèle a activement recherchées. Les schémas complets n'apparaissent que pour celle qu'il est sur le point d'exécuter. Chaque couche de détail est divulguée au moment où l'agent en a besoin. L'agent fait de meilleures sélections parce qu'il raisonne sur une liste restreinte ciblée plutôt que de parcourir des centaines d'entrées, ce qui permet à l'Agent Harness de passer à une surface de capacités étendue.
Les Agent Harness distribuent la gestion du contexte
L'Agent Harness de Glean devient de plus en plus performant pour mettre à l'échelle et gérer le contexte, car il est plus distribué : l'appel d'outils programmatique permet une logique d'exécution complexe, les sous-agents isolent le contexte, la compaction préserve l'état de la tâche tout en déchargeant le contexte, et la découverte de compétences maintient les agents concentrés sur la tâche en cours.
L'Agent Harness ne cesse d'évoluer. Chaque nouvelle génération d'IA au travail révèle les limites de ce qui l'a précédée, et notre Agent Harness évolue avec elle, s'élargissant pour répondre aux exigences croissantes des agents et au contexte nécessaire à l'obtention de résultats fiables à l'échelle de l'entreprise. Vous souhaitez doter vos agents d'un système fiable de gestion du contexte ? Réservez une démo Glean dès aujourd'hui.
Auteurs : Nikhil Mandava, Ayushi Mrigen, Chau Tran, Abhi Samantapudi, Julie Mills, Matt Ding
