






Les graphes de contexte suscitent beaucoup d'attention en ce moment, les investisseurs les qualifiant d'« opportunité à mille milliards de dollars ».
En effet, si les modèles d'IA peuvent désormais utiliser des outils, ils manquent encore de la connaissance des processus nécessaire pour réellement automatiser le travail. Les systèmes d'enregistrement capturent les décisions, mais le vrai travail se déroule dans les réunions, les discussions, les e-mails et les documents. Sans une vision structurée de la manière dont le travail s'effectue réellement, l'IA ne peut pas l'automatiser de façon fiable.
Avec tout ce battage médiatique, les publications sur les réseaux sociaux tournent sans cesse autour des deux mêmes questions : qu'est-ce qu'un graphe de contexte, exactement, et comment en construire un ? Dans ce blog, nous exposerons l'approche de Glean pour construire des graphes de contexte et expliquerons pourquoi nous avons choisi cette voie.
Qu'est-ce qu'un graphe de contexte ?
Un graphe de contexte est un modèle qui relie les entités de votre entreprise (personnes, documents, tickets, systèmes) aux traces temporelles des actions et des événements entre elles. Il fait ensuite émerger des insights exploitables à partir de ces traces, afin que l'IA comprenne comment le travail s'effectue réellement.
Les graphes de contexte aident l'IA à répondre à des questions telles que :
- « Comment les incidents P1 sont-ils généralement résolus ici ? »
- « Quelles sont les escalades les plus fréquentes concernant le produit X ? »
- « Que se passe-t-il généralement entre la “création d'un pilote” et la “conclusion d'un contrat” ? »
- « Que signifie réellement “onboarding terminé” pour cette équipe ? »
- « Combien de temps prend un déploiement typique et pourquoi ? »
Les agents actuels ont du mal avec les processus de bout en bout ou les tâches de longue haleine (celles qui s'étalent sur des semaines ou des mois) qui nécessitent de synthétiser des connaissances provenant de systèmes multiples et disparates.
Lorsque vous reliez plusieurs tâches qui s'étendent sur différents événements, vous devez rassembler des informations issues de diverses sources et de nombreuses personnes, qui exécutent chacune le travail un peu différemment, avec des exceptions locales et des cas particuliers ponctuels intégrés à leur processus. Mais les systèmes d'enregistrement ne montrent généralement que l'état actuel et capturent rarement cette variabilité d'exécution ou le contexte historique complet ; s'appuyer sur cette vision incomplète peut donc entraîner des angles morts et des résultats sous-optimaux.
À la place, disposer d'un modèle interne des processus réels de votre organisation — un graphe de contexte construit à partir des traces réelles des actions — devient le meilleur substitut pour apprendre à la fois la structure à suivre et l'intention derrière le travail.
Du « quoi » au « comment »
Un graphe de contexte décrit le flux de travail en passant de la description du « quoi » qui existe à la description du « comment » le changement se produit :
- « Quoi » : les systèmes traditionnels de données et de connaissances modélisent des choses : clients, tickets, documents, personnes, systèmes.
- « Comment » : un graphe de contexte modélise des comportements : qui a fait quoi, dans quelles applications, dans quel ordre et avec quel effet.
Le « comment » est décrit en transformant les actions en une entité de premier plan dans le graphe :
- Nœuds : (c'est-à-dire les actions des utilisateurs et des agents avec de riches traces de données) « créé », « consulté », « approuvé », « escaladé », « commenté », « résolu », chacun assorti d'horodatages et de riches métadonnées sur les changements.
- Arêtes : les arêtes représentent la causalité et la corrélation. Le « message A » a déclenché la « mise à jour B » avec une probabilité P.
Nous avons choisi de faire modéliser Glean de cette façon afin d'attacher un pouvoir prédictif à une séquence d'activités, de sorte que nous puissions suggérer l'étape la plus susceptible de se produire ensuite sans coder en dur un flux. Ce que nous obtenons au final est une distribution de chemins probables, donnant à l'agent l'autonomie de choisir le plus probable pour le scénario.
Désormais, superposés à ces chemins de processus, se trouvent des insights dérivés — un raisonnement expliquant pourquoi le « chemin A » différait du « chemin B ». Cela nous permet d'encoder non seulement le « comment », mais aussi un « pourquoi » probable, qui peut être transmis à l'agent au moment de l'exécution.
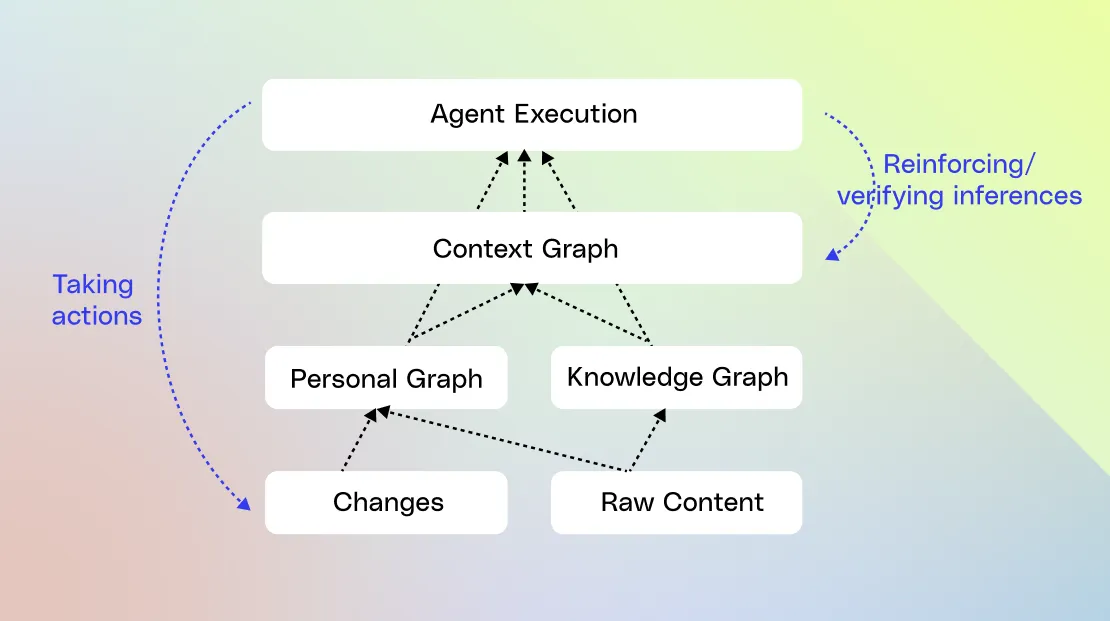
Une fois l'agent exécuté, ses actions deviennent de nouvelles traces pour le graphe de contexte. L'apprentissage par renforcement sur ces traces évalue ensuite si le chemin choisi était optimal et identifie d'autres chemins que l'agent pourra emprunter à l'avenir.
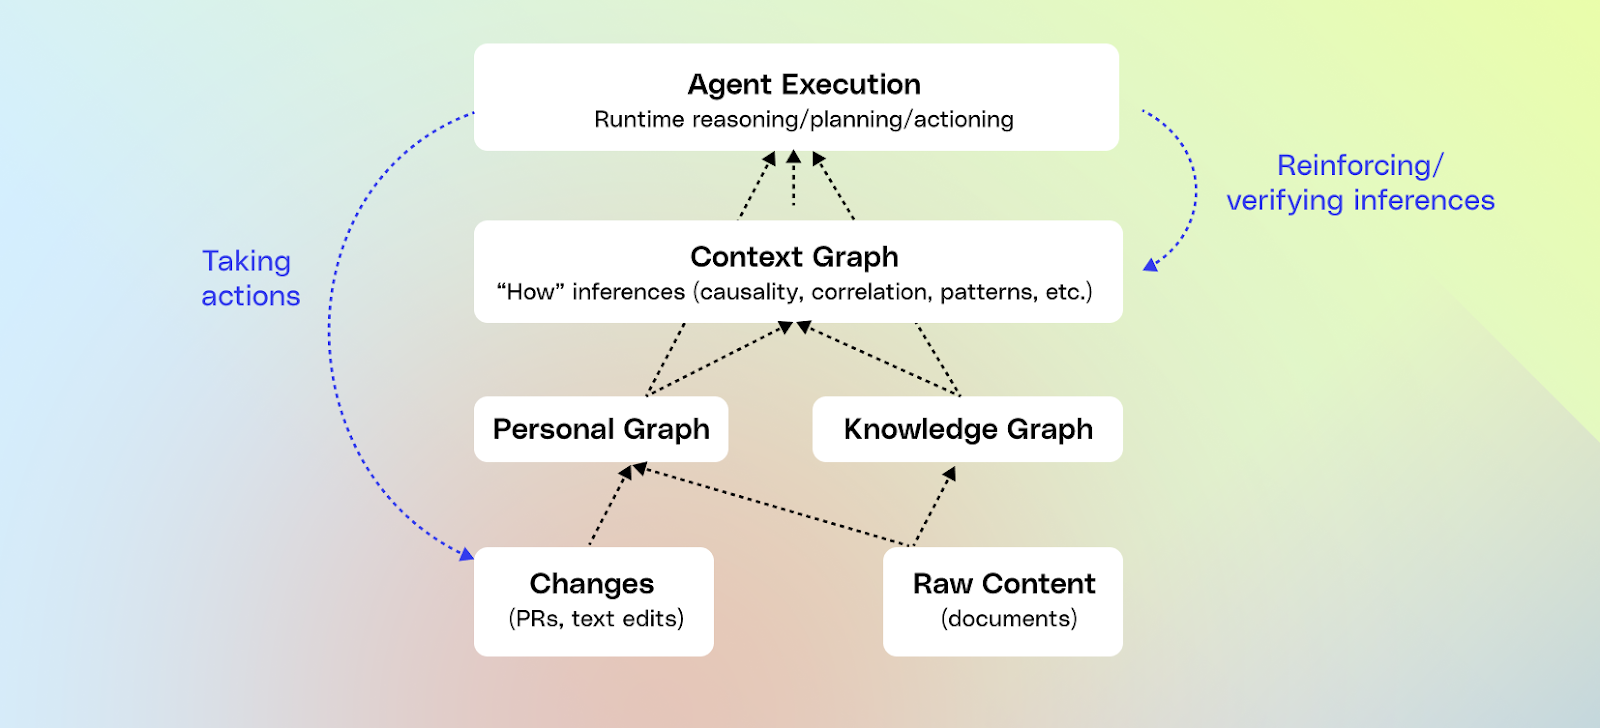
Comment construisons-nous un graphe de contexte ?
Investir dans des connecteurs approfondis et l'observabilité
Les graphes de contexte nécessitent un socle de connecteurs approfondis et d'observabilité. Si nous ne pouvons pas voir comment le travail s'effectue, nous ne pouvons pas le modéliser. Cela signifie s'intégrer au niveau des documents avec les applications où le travail a réellement lieu, ainsi qu'avec les données structurées : CRM et systèmes de ticketing, chat, documents, e-mails, agendas, code, tableaux de bord et applications internes.
Nous comprenons comment chaque application est réellement utilisée — par exemple, les commentaires Jira se périment rapidement, tandis que les liens dans une description Jira sont généralement canoniques (c'est-à-dire : documents, maquettes, etc.). Nous capturons ces schémas dans un modèle de données centralisé, que nous plaçons ensuite dans notre index de recherche.
À partir de là, le plus difficile est de maintenir ce modèle en bonne santé au fil du temps : traquer les API incohérentes, réconcilier les identités qui diffèrent d'un outil à l'autre, et faire respecter en permanence les autorisations de contenu afin que chaque résultat soit à la fois pertinent et correctement sécurisé.
Il y a quelques années, nous avons évolué pour capturer non seulement les données des documents, mais aussi tous les événements de changement dans une application. Nous les normalisons ensuite et les exposons sous forme de traces, dans le but de construire un graphe de contexte.
Construire un graphe de connaissances unifié
Après avoir exploré et indexé les données, nous construisons un graphe de connaissances en exécutant un pipeline d'apprentissage automatique pour déduire des entités de plus haut niveau comme les projets, les clients, les produits, les équipes et les personnes. Nous identifions également les relations entre elles — en déterminant quels documents, tickets, appels et tableaux de bord appartiennent à un produit ou un compte donné.
Nous alimentons en continu des signaux d'activité (consultations, modifications, commentaires, etc.) pour comprendre comment l'information est réellement utilisée et comment les gens collaborent. C'est ainsi que Glean comprend que « ACME Inc » dans le CRM et « ACME » dans les tickets d'assistance désignent le même client.
Cela nous permet de regrouper les activités dans le même projet ou client canonique, offrant un haut degré de confiance quant à ce qui se passe réellement.
C'est pourquoi les graphes de connaissances constituent un socle essentiel des graphes de contexte : car les signaux d'activité sont bruités à eux seuls, vous avez besoin de graphes de connaissances en dessous pour rendre cette activité pertinente.
Créer un graphe personnel
En parallèle du graphe de connaissances, nous construisons un graphe personnel qui comprend vos tâches et vos projets afin d'offrir une aide proactive et personnalisée. Pour construire le graphe personnel, nous collectons et synthétisons les flux d'activités et les traces, assemblons ces signaux bruts en chronologies, et les enrichissons avec des entités provenant du graphe de connaissances :
- Pour chaque personne, une séquence chronologique d'actions à travers les outils, accompagnée de métadonnées plus riches.
- À partir de là, nous commençons à regrouper les événements de bas niveau en tâches sémantiques.
C'est là que ça se complique. Le travail réel est désordonné : les gens changent constamment de contexte, réutilisent le même document pour différents efforts, abandonnent des fils de discussion puis les reprennent plusieurs jours après. Un simple événement « modifier un document » peut appartenir à plusieurs flux de travail parallèles.
Pour donner du sens à tout cela, nous combinons :
- Des signaux simples comme les titres partagés, les liens entre tickets et documents, les invitations à des réunions, les noms de canaux et les fenêtres temporelles.
- Des LLM qui examinent des séquences d'événements et en déduisent : « ce groupe ressemble à l'investigation d'une alerte » ou « ces actions réunies ressemblent à la rédaction et à la diffusion d'une spécification ».
L'objectif est de découper le flux en unités de travail cohérentes — tâches et projets de plus haut niveau — sur lesquelles le système peut raisonner.
À ce stade, nous n'avons observé qu'un seul individu au travail. Et, parce que nous préservons la confidentialité des utilisateurs, ces données ne sont visibles que par eux. Mais lorsque nous commençons à les analyser de manière agrégée, nous pouvons distinguer des thèmes.
Créer un graphe de contexte
Lorsque nous analysons les processus de manière agrégée, nous prenons chaque graphe personnel et le normalisons en une séquence d'« étapes » anonymisées avec des libellés grossiers :
- type d'action (consulter, modifier, commenter, escalader)
- famille d'outils (documents, chat, tickets, code)
- entités du graphe de connaissances impliquées (type d'incident, produit, service, segment client)
- balises de processus dérivées des LLM ou d'heuristiques (p. ex. « investigate_alert », « draft_spec », « negotiate_contract », « onboard_customer »)
- caractéristiques temporelles légères et résultats (p. ex. « P1 résolu, MTTR < 30 minutes » ou « affaire conclue‑gagnée »)
Ce que nous ne transférons pas dans les traces abstraites, c'est le texte brut (corps de documents, texte de messages), les identifiants d'utilisateurs ou les secrets spécifiques aux clients. Nous calculons ensuite la similarité entre les traces abstraites pour déterminer lesquelles sont susceptibles d'impliquer le même processus.
En plus de cela, nous ne considérons un modèle comme viable que s'il apparaît chez au moins k utilisateurs distincts et n traces indépendantes, tout ce qui est trop rare étant écarté pour préserver l'anonymat.
Ce faisant, nous construisons une vision probabiliste de « ce qui tend à se produire », « dans quel ordre » et « pourquoi ce chemin dévie d'autres chemins similaires ». Nous utilisons ensuite le temps pour déterminer la valeur du processus. Si un processus prend beaucoup de temps à des groupes d'utilisateurs similaires, il s'agit très probablement d'un processus à forte valeur. Cela devient le graphe de contexte du système — les playbooks sur lesquels les agents peuvent s'appuyer lorsqu'ils rencontrent une situation similaire.
Au fur et à mesure que nous avons construit ce graphe, nous avons évalué différentes façons de stocker les données d'événements pour la traversée. Les structures de graphe pures sont rigides ; le texte brut est flexible mais difficile à parcourir. Nous utilisons donc un modèle hybride : prendre du texte libre, le découper en petits fragments et intégrer des identifiants d'entités.
Un incident, par exemple, devient de courts segments qui marquent des transitions — « investigation » vers « atténuation » — en les étiquetant avec des identifiants comme incident_id=INC-123, channel_id=#p1-incidents ou action_type=escalated. Cela permet à l'agent de parcourir le processus étape par étape avec des repères clairs, le compromis étant qu'il n'est pas optimisé pour raisonner sur des milliers d'incidents à la fois.
Apprendre à partir des traces agentiques
La dernière grande étape consiste à boucler la boucle avec l'exécution des agents. Si les agents s'exécutent en dehors de ce système, le graphe n'apprend jamais d'eux. S'ils s'exécutent à l'intérieur, chaque exécution d'agent devient une trace supplémentaire :
- Quels outils il a appelés, dans quel ordre, avec quelles entrées et sorties.
- Si l'exécution s'est terminée avec succès, son efficacité, et si l'utilisateur a voté pour ou contre la réponse
Tous ces enseignements sont cantonnés à chaque entreprise et se concentrent sur la façon dont l'agent utilise les outils, plutôt que sur le stockage du contenu sous-jacent.
Hors ligne, nous rejouons ensuite et testons des itinéraires alternatifs. Nous notons les alternatives sur l'exactitude, l'exhaustivité, le respect des instructions et l'efficacité. Nous traitons ces traces d'agents de la même manière que les traces humaines :
- Les exécutions réussies renforcent les modèles que vous voulez que le système privilégie, devenant des playbooks en langage naturel.
- Les exécutions nécessitant une intervention mettent en évidence les anti-modèles où davantage de contexte ou une meilleure utilisation des outils est nécessaire
Au fil du temps, le graphe de contexte devient un modèle conjoint du comportement humain et des agents. Il ne se contente pas de décrire comment le travail se déroulait ; il reflète la façon dont le travail se déroule aujourd'hui, à mesure que les humains et les agents en partagent une plus grande part.
C'est pourquoi le graphe de contexte doit être détenu conjointement par la couche de données et la couche d'orchestration. Pour les flux à forte valeur — réponse aux incidents, affaires commerciales, développement produit — vous avez besoin des deux : une couche de contexte qui capture un modèle structuré et conscient des processus de l'entreprise, et une couche d'exécution capable de planifier, d'itérer et de générer des traces. Les séparer crée une dérive : le graphe évolue d'un côté, l'exécution des agents de l'autre, et vous vous retrouvez avec deux versions divergentes de la réalité.
Maintenir le graphe et l'orchestration dans un seul système garantit que les agents restent ancrés dans un modèle vivant et évolutif de la façon dont votre entreprise fonctionne réellement.

Construire des graphes de contexte chez Glean
Construire des graphes de contexte représente un investissement important, et nous avons en réalité testé le concept en interne avant de le construire. Nous avons créé manuellement un graphe de contexte pour Glean en nous appuyant sur une technologie que nous avions déjà développée : le graphe personnel.
Nous avons demandé aux employés de Glean d'accepter de partager les données de leur graphe personnel, qui capturaient les projets sur lesquels ils travaillaient, la séquence d'étapes qu'ils suivaient et le temps qu'ils y consacraient. Avec l'élément du temps, nous avons pu distinguer les processus à faible valeur de ceux à forte valeur. Nous avons ensuite examiné quelles équipes avaient les mêmes processus répétés à forte valeur, comme le « cycle d'affaires AE mid‑market », la « preuve de concept SE », la « réponse aux incidents d'astreinte », le « lancement de fonctionnalité PM », etc.
Nous avons pris les séquences d'événements de ce travail et validé avec des experts métier le A-path par rapport au D-path pour accomplir le travail, l'existence de déviations et leurs raisons. Nous avons également identifié nos angles morts, ou les étapes qui nous manquaient parce que nous n'avions pas exploré les bonnes données ou que nous manquions des actions nécessaires pour prendre en charge une étape donnée. Ensuite, nous avons consacré des ressources à transformer ces processus à forte valeur (validés à la fois pour Glean et pour la demande client) en agents qui fonctionnent réellement dans Glean.
Si ces agents deviennent une représentation statique de l'état actuel, ce n'était pas notre objectif final. Nous voulions des graphes de contexte. En effet, les chemins optimaux évoluent, les responsabilités changent, de nouveaux outils apparaissent, et bien plus encore. Notre objectif avec le graphe de contexte n'est pas seulement de créer un ensemble statique d'agents, mais de continuer à alimenter les agents avec de nouvelles informations de processus issues du graphe et de déplacer davantage de logique dans cette couche apprise plutôt que de dépendre constamment d'instructions manuelles. C'est ainsi que nous pensons obtenir des agents durables fonctionnant de manière autonome. Et chez Glean, nous sommes sur le point de concrétiser cette réalité.
Vous souhaitez en savoir plus sur les graphes de contexte ? Consultez notre précédent article de blog ici—ou inscrivez-vous dès aujourd'hui pour une démo gratuite de Glean.
