






Nous sommes ravis de prendre en charge GPT-5 dès le premier jour de sa disponibilité. Cela témoigne de notre engagement continu à prendre rapidement en charge les derniers modèles d'IA, afin que les entreprises puissent les évaluer et les déployer dans des agents qui comprennent pleinement leur contexte d'entreprise.
Chaque client Glean peut essayer GPT-5 avec Agents et le comparer directement à d'autres modèles pris en charge, notamment OpenAI o3, OpenAI GPT-4.1, Claude Sonnet 4, Meta Llama 4, Google Gemini 2.5 Pro, Google Gemini 2.5 Flash, et bien d'autres. Les utilisateurs peuvent l'exploiter avec l'intégralité du contexte de leurs données d'entreprise et des Agents qu'ils ont déjà créés sur Glean.
Dans le cadre de notre collaboration continue avec OpenAI, Glean a bénéficié d'un accès anticipé à GPT-5 et l'a évalué pour des cas d'usage d'IA agentique en entreprise. Dans cet article, nous partagerons nos enseignements sur les domaines et les façons dont GPT-5 excelle, afin de vous aider à l'évaluer pour vos propres agents d'entreprise.
GPT-5 surpasse o3 sur toute la ligne, en matière d'exactitude, d'exhaustivité et d'alignement avec les retours humains
GPT-5 est le premier modèle à fusionner des capacités polyvalentes et de raisonnement au sein d'un seul modèle. Lorsque nous avons réfléchi aux modèles à comparer à GPT-5, nous nous sommes tournés vers la génération précédente de modèles OpenAI ; GPT-4.1 était conçu pour les tâches polyvalentes, tandis que o3 était spécialisé dans le raisonnement.
Chez Glean, nous concevons des Agents et des Assistants qui planifient de manière adaptative, en itérant à partir des échecs ou des découvertes passés. o3 excelle dans le raisonnement, étant plus enclin à lancer des recherches complémentaires, à essayer des plans alternatifs et à rassembler davantage de contexte si nécessaire. C'est précisément l'ensemble de compétences qui aide Glean à prendre en charge des tâches plus complexes. C'est pourquoi nous avons choisi de comparer GPT-5 à o3 dans notre évaluation.
Chez Glean, nous disposons de plus de 25 juges LLM qui évaluent en continu nos produits Search, Assistant et Agents sur un large éventail de tâches d'entreprise (recherche d'informations, rédaction, analyse de données, codage, etc.). Nous évaluons également les LLM sur ces mêmes indicateurs, ce qui nous aide à déterminer quels modèles nous prenons en charge et comment les clients peuvent combiner différents modèles.
Avec autant de juges à notre disposition, nous avons utilisé plusieurs indicateurs pour comparer o3 à GPT-5 sur le déploiement en production de Glean. Bien que nous nous en soyons tenus ici à notre propre cas d'usage d'entreprise par manque de temps, nous le faisons habituellement sur un ensemble d'évaluation bien plus vaste, composé de requêtes réelles de clients, de requêtes synthétiques et de requêtes ajustées manuellement.
Ces indicateurs se concentrent sur ce qui compte vraiment pour les entreprises en matière d'IA :
- Exactitude : le résultat est-il précis ou passe-t-il à côté de l'essentiel ? Que ce soit à cause d'hallucinations ou simplement parce qu'il a suivi le mauvais chemin vers la réponse.
- Exhaustivité : l'agent a-t-il pleinement accompli ce que l'utilisateur a demandé ? Il peut s'agir de rédiger un e-mail, de créer un ticket Jira, ou simplement de répondre à tous les aspects spécifiés dans la question de l'utilisateur.
- Alignement avec les retours humains : les nouvelles réponses s'alignent-elles mieux avec les retours humains que nous avons reçus sur nos requêtes précédentes ?
Nous avons constaté que GPT-5 surpasse o3 sur ces indicateurs clés :
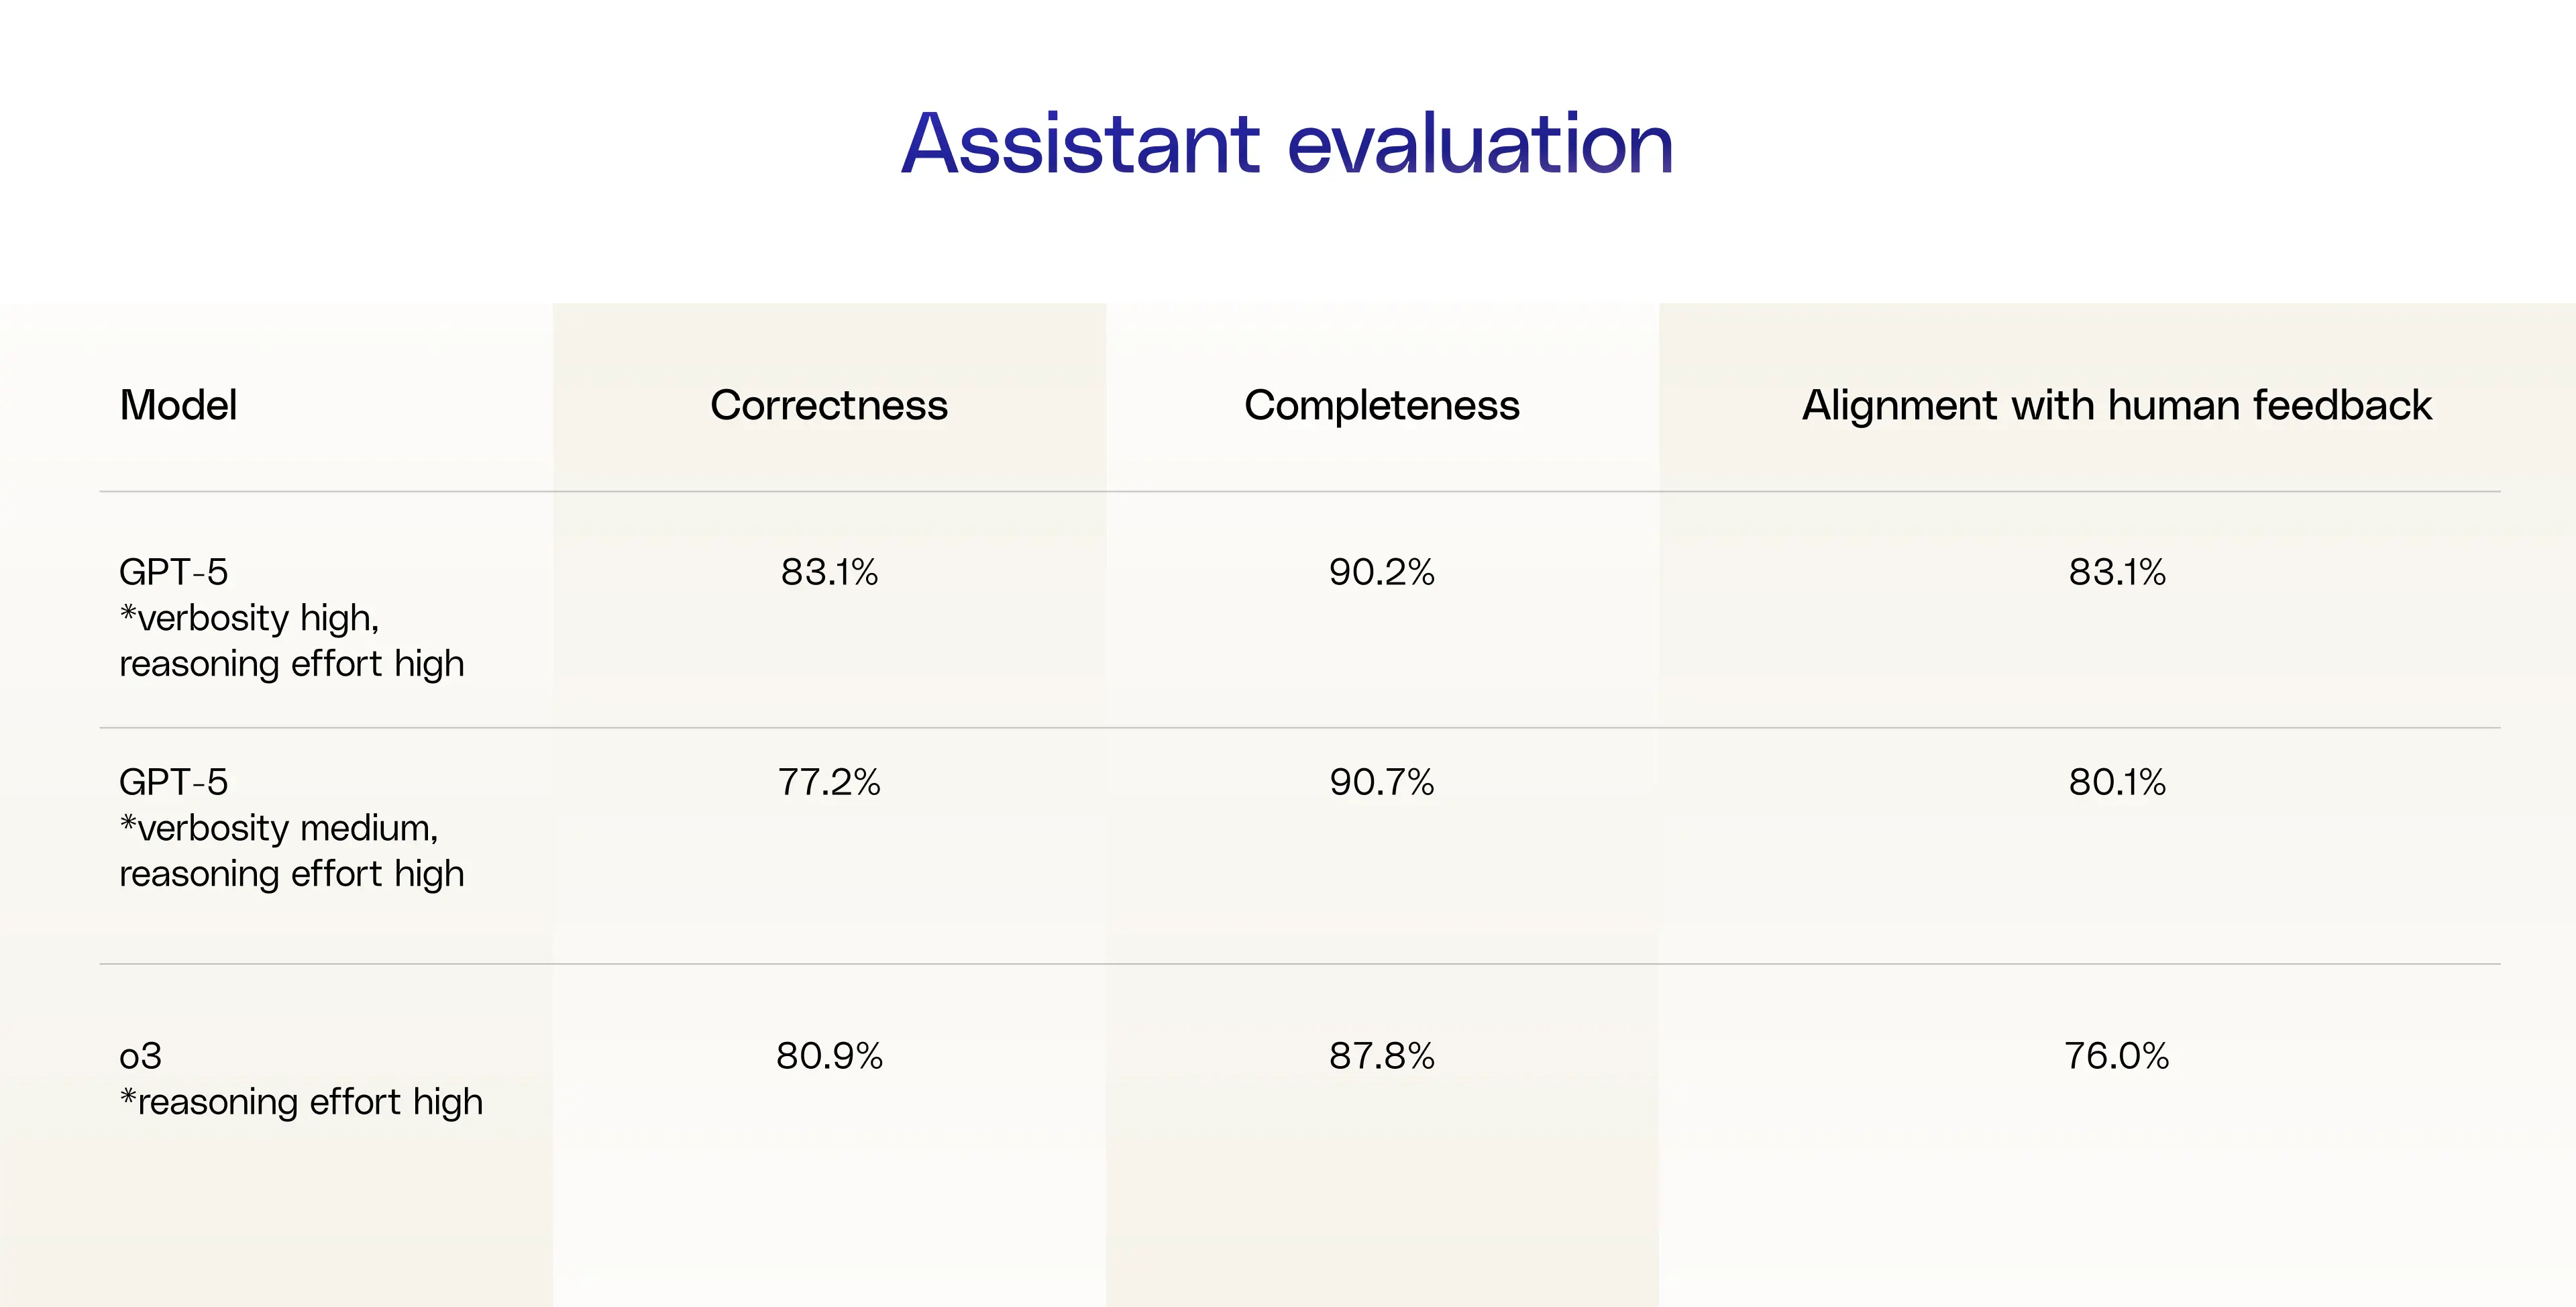
Remarque : o3 ne dispose pas de réglage de verbosité, mais nous avons observé un niveau de verbosité moyen dans nos évaluations.
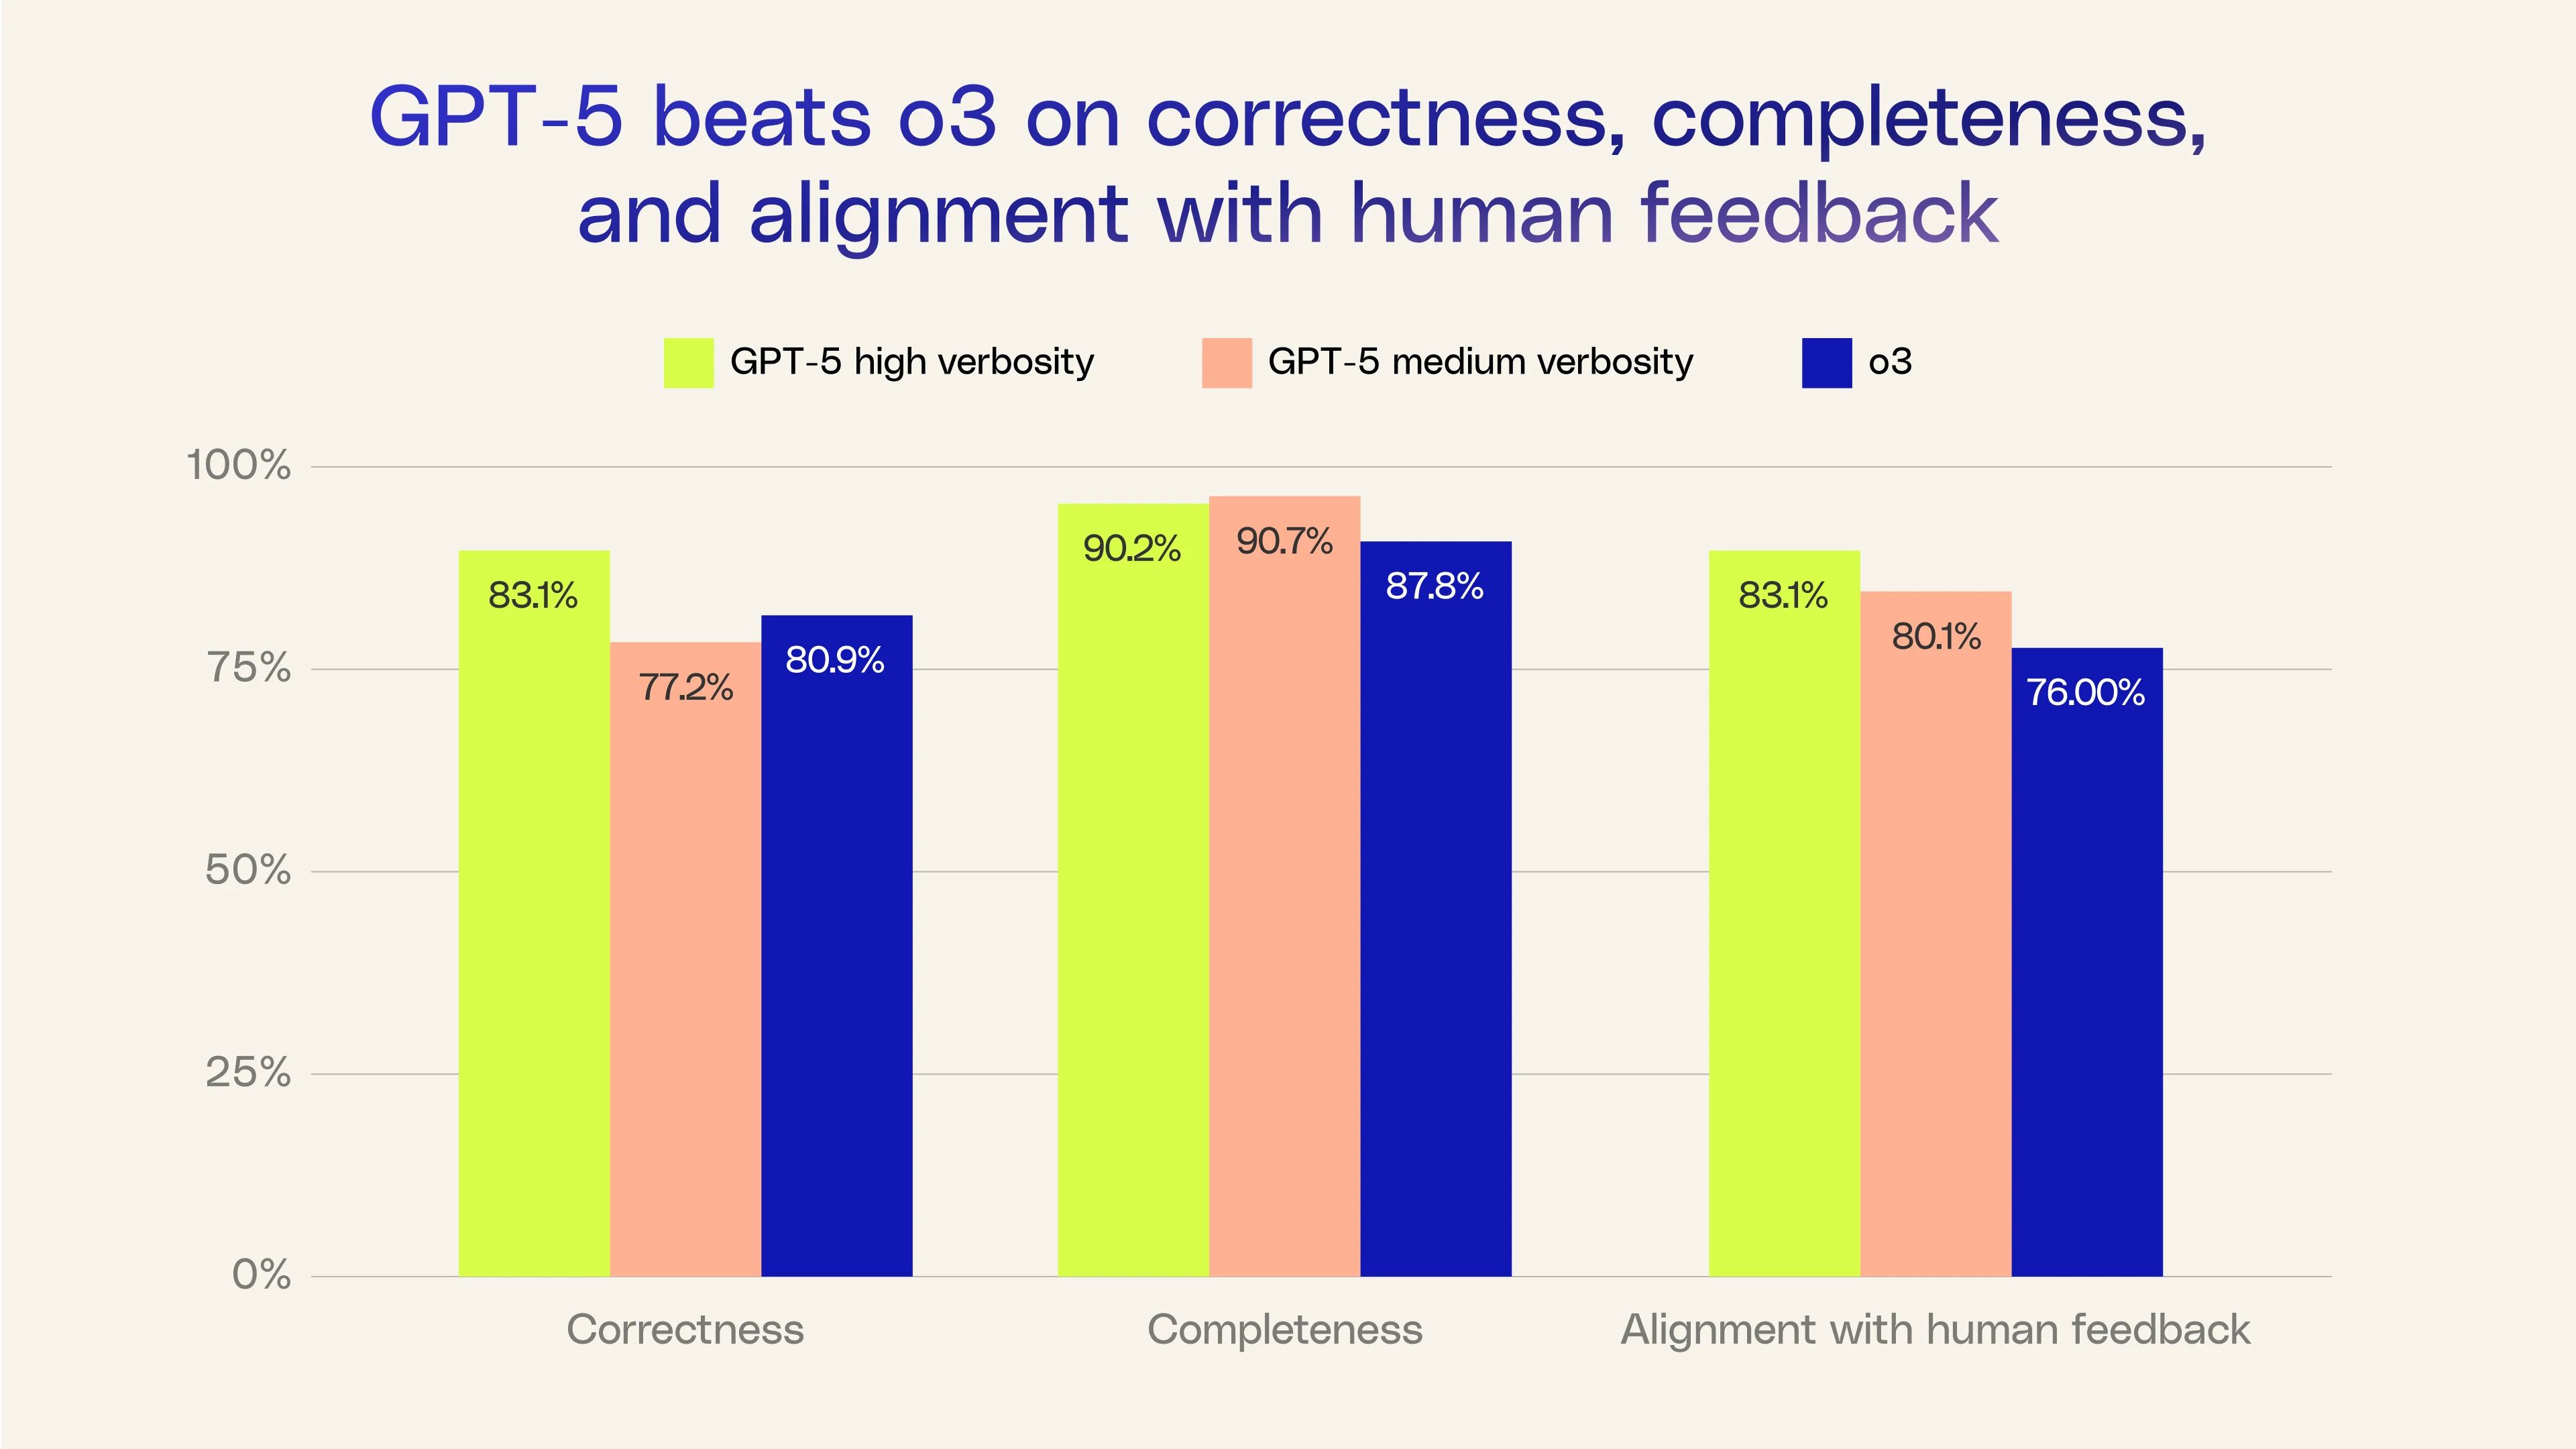
Dans la prochaine section de cet article, nous détaillerons pourquoi nous avons constaté l'amélioration de ces indicateurs avec GPT-5.
L'usage étendu des outils de GPT-5 l'emporte sur la planification approfondie d'o3
Pour mieux comprendre les différences entre o3 et GPT-5, nous avons examiné quelques indicateurs d'investigation : le nombre d'étapes de planification et le nombre de recherches effectuées.
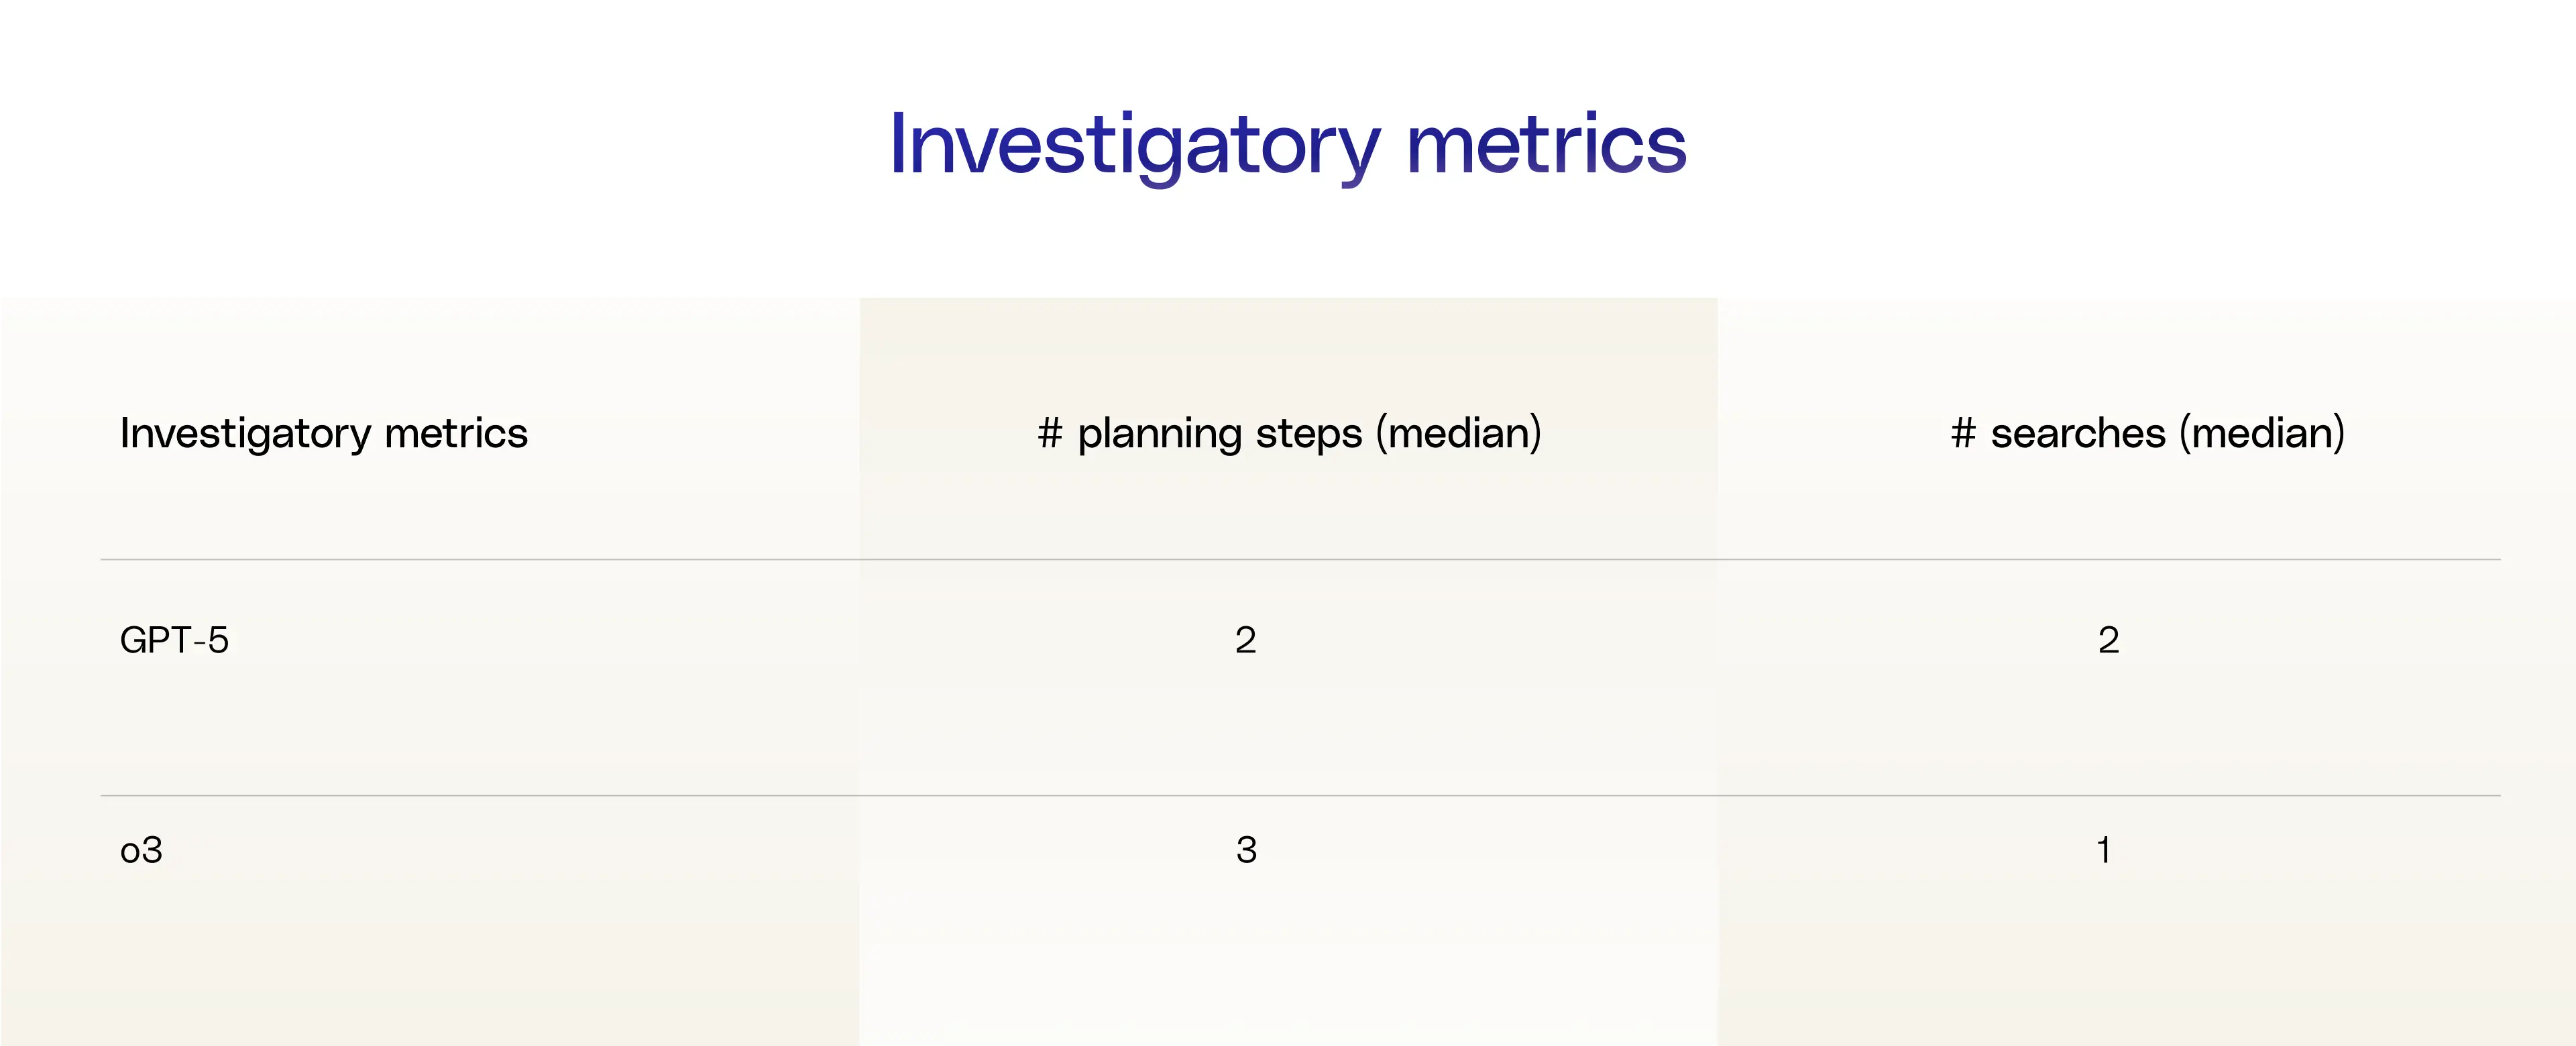
Ce que nous observons dans ces indicateurs, ainsi qu'en examinant les plans des agents, c'est que GPT-5 a tendance à ratisser large. Lorsqu'il reçoit une requête, il rassemble rapidement des informations à partir de plusieurs outils ou essaie plusieurs stratégies en parallèle. L'appel d'outils en parallèle est l'une des nouvelles fonctionnalités de GPT-5, et il sait l'utiliser.
Cela signifie que GPT-5 trouve souvent ce dont il a besoin sans avoir à passer par une longue chaîne d'étapes intermédiaires. Par conséquent, le « plan » que suit l'agent (la séquence d'actions qu'il entreprend) est plus court, avec moins d'étapes du début à la fin.
En revanche, o3 a tendance à aller en profondeur. Il peut commencer par une approche ciblée, puis suivre une chaîne de raisonnement ou d'actions, comme rechercher dans une source, puis approfondir un document spécifique, puis poser une question de clarification, et ainsi de suite. Cela se traduit par davantage d'étapes de planification, l'agent adoptant une approche plus progressive et investigatrice.
Si nous examinons les résultats de performance, nous pouvons constater que l'approche d'usage étendu des outils adoptée par GPT-5 l'emporte. Cela suggère qu'une utilisation efficace des outils devient un moteur de la performance des agents en entreprise, réduisant souvent le besoin d'étapes de planification supplémentaires. En fin de compte, cela souligne que l'utilisation des outils pour établir le contexte est primordiale ; le contexte donne aux modèles d'IA l'avantage décisif dont ils ont besoin pour accomplir leurs tâches.
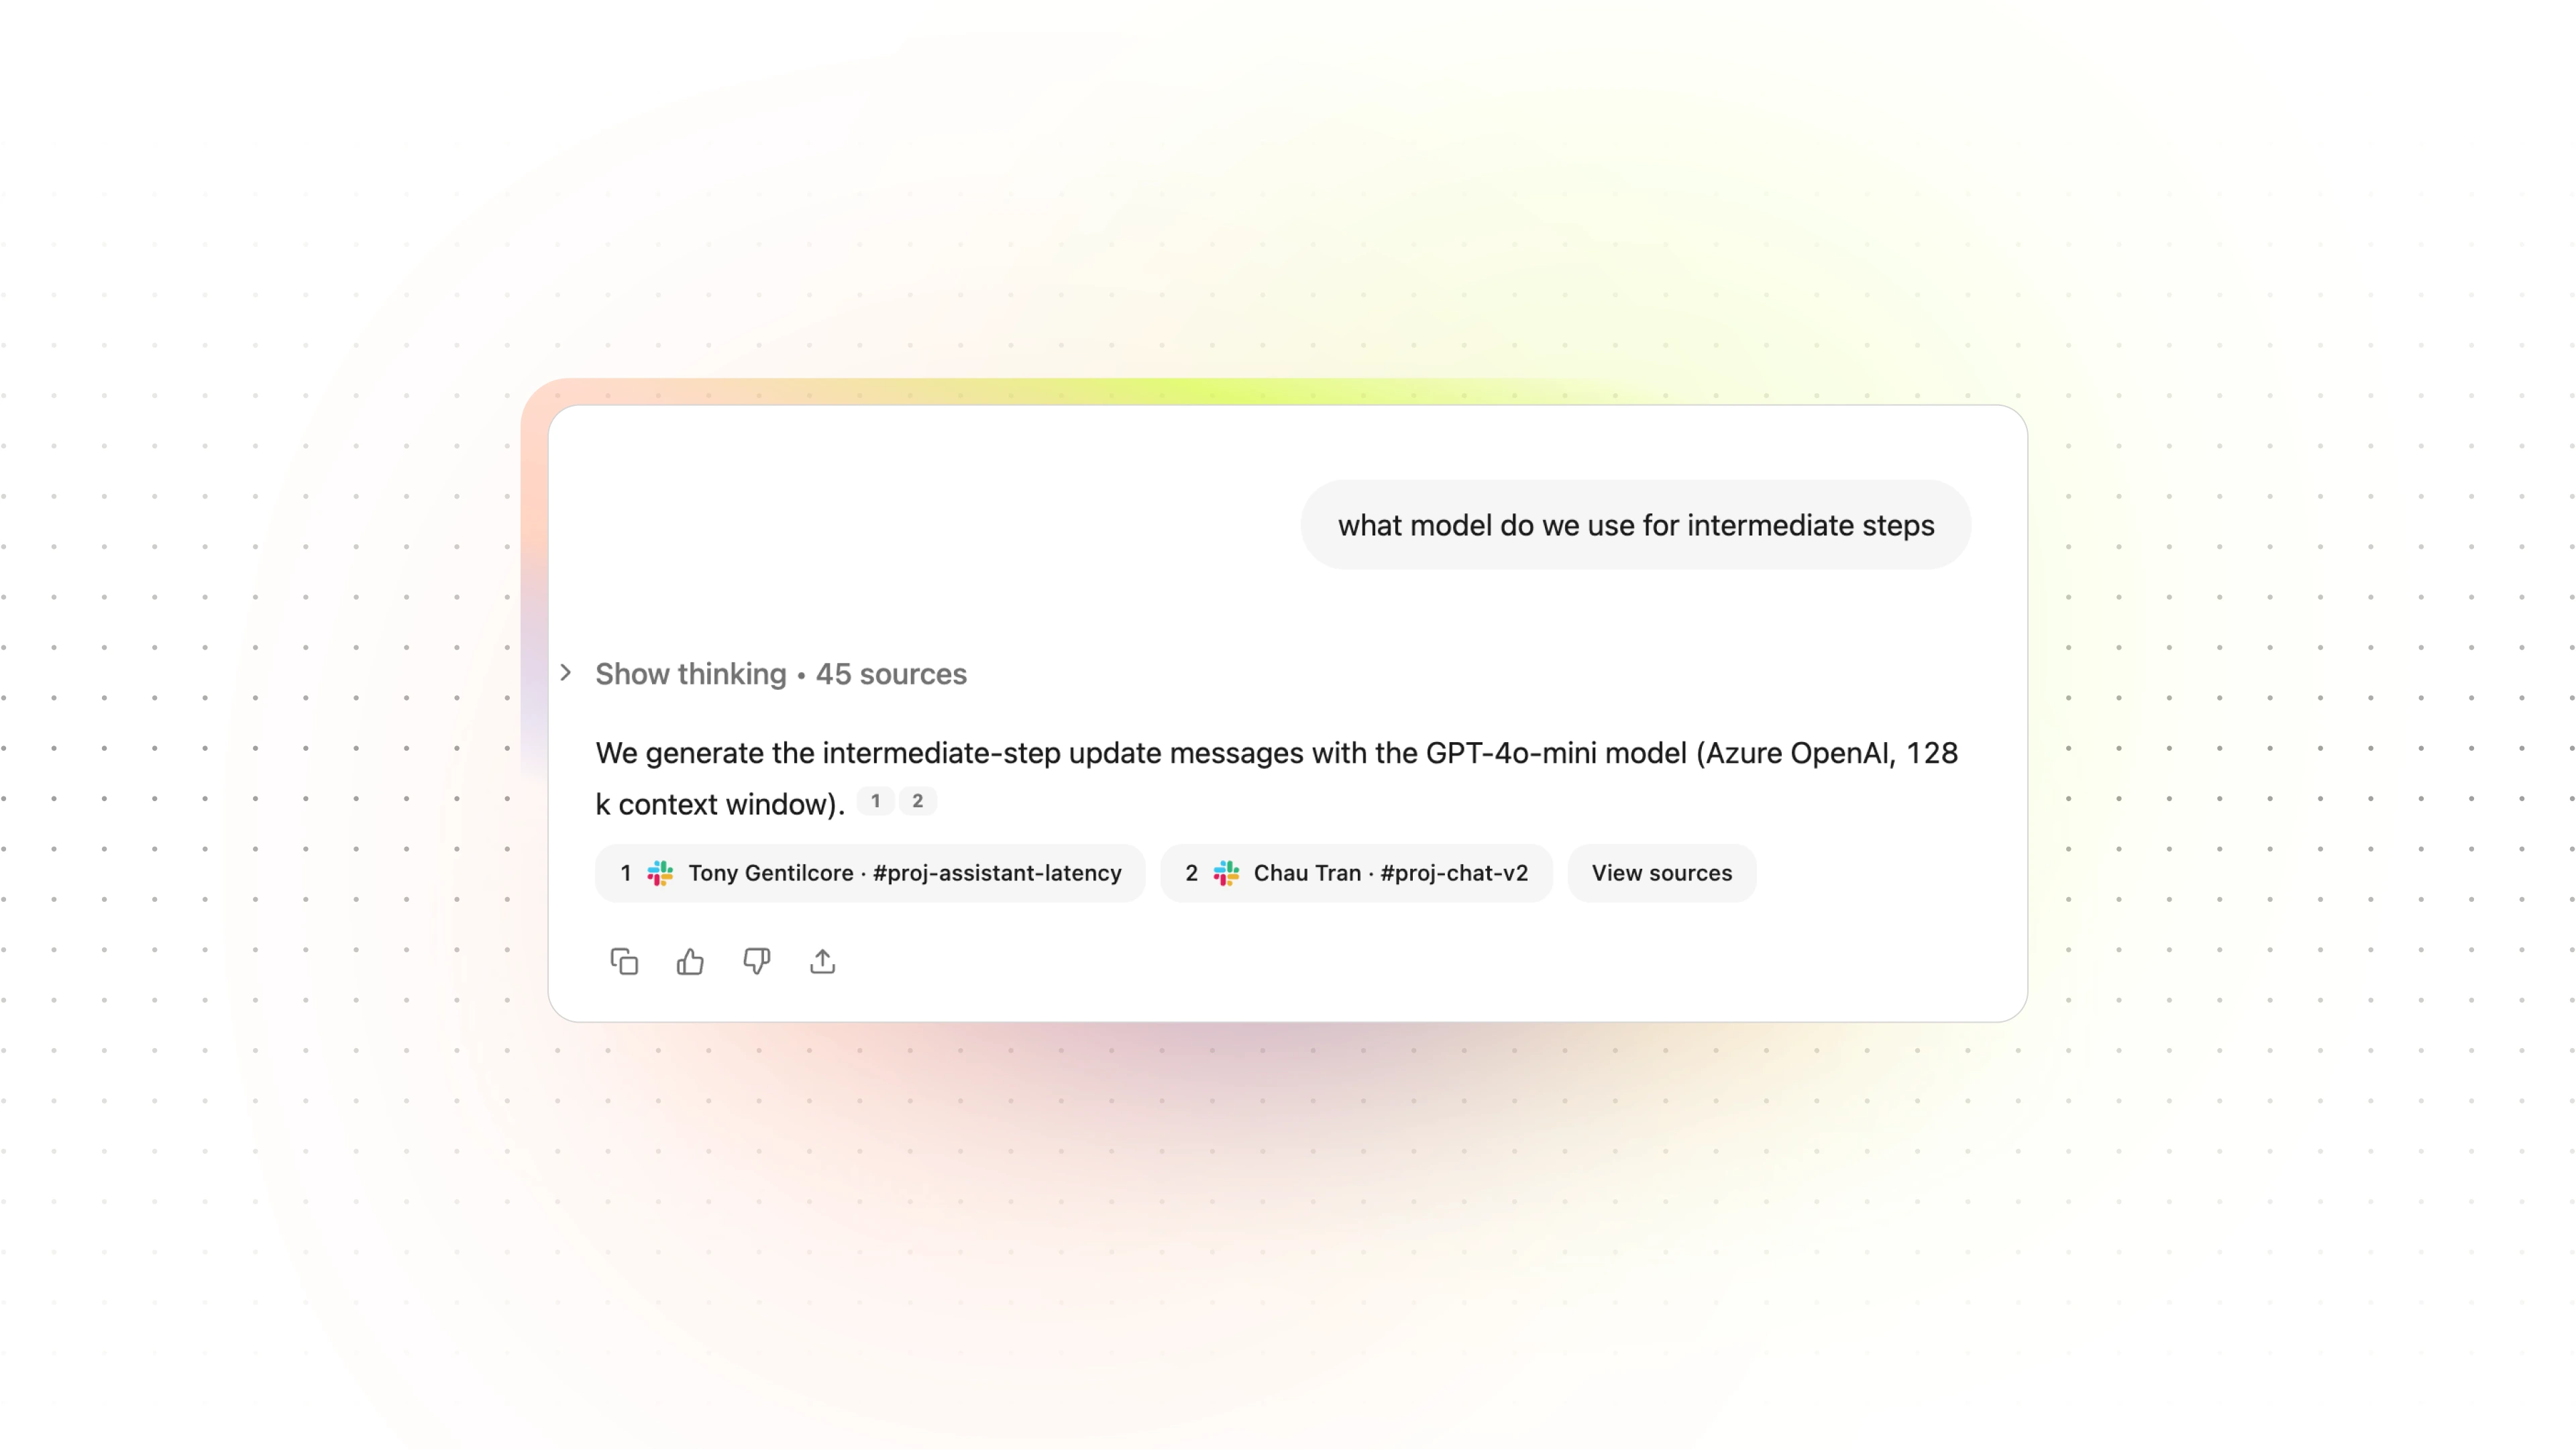
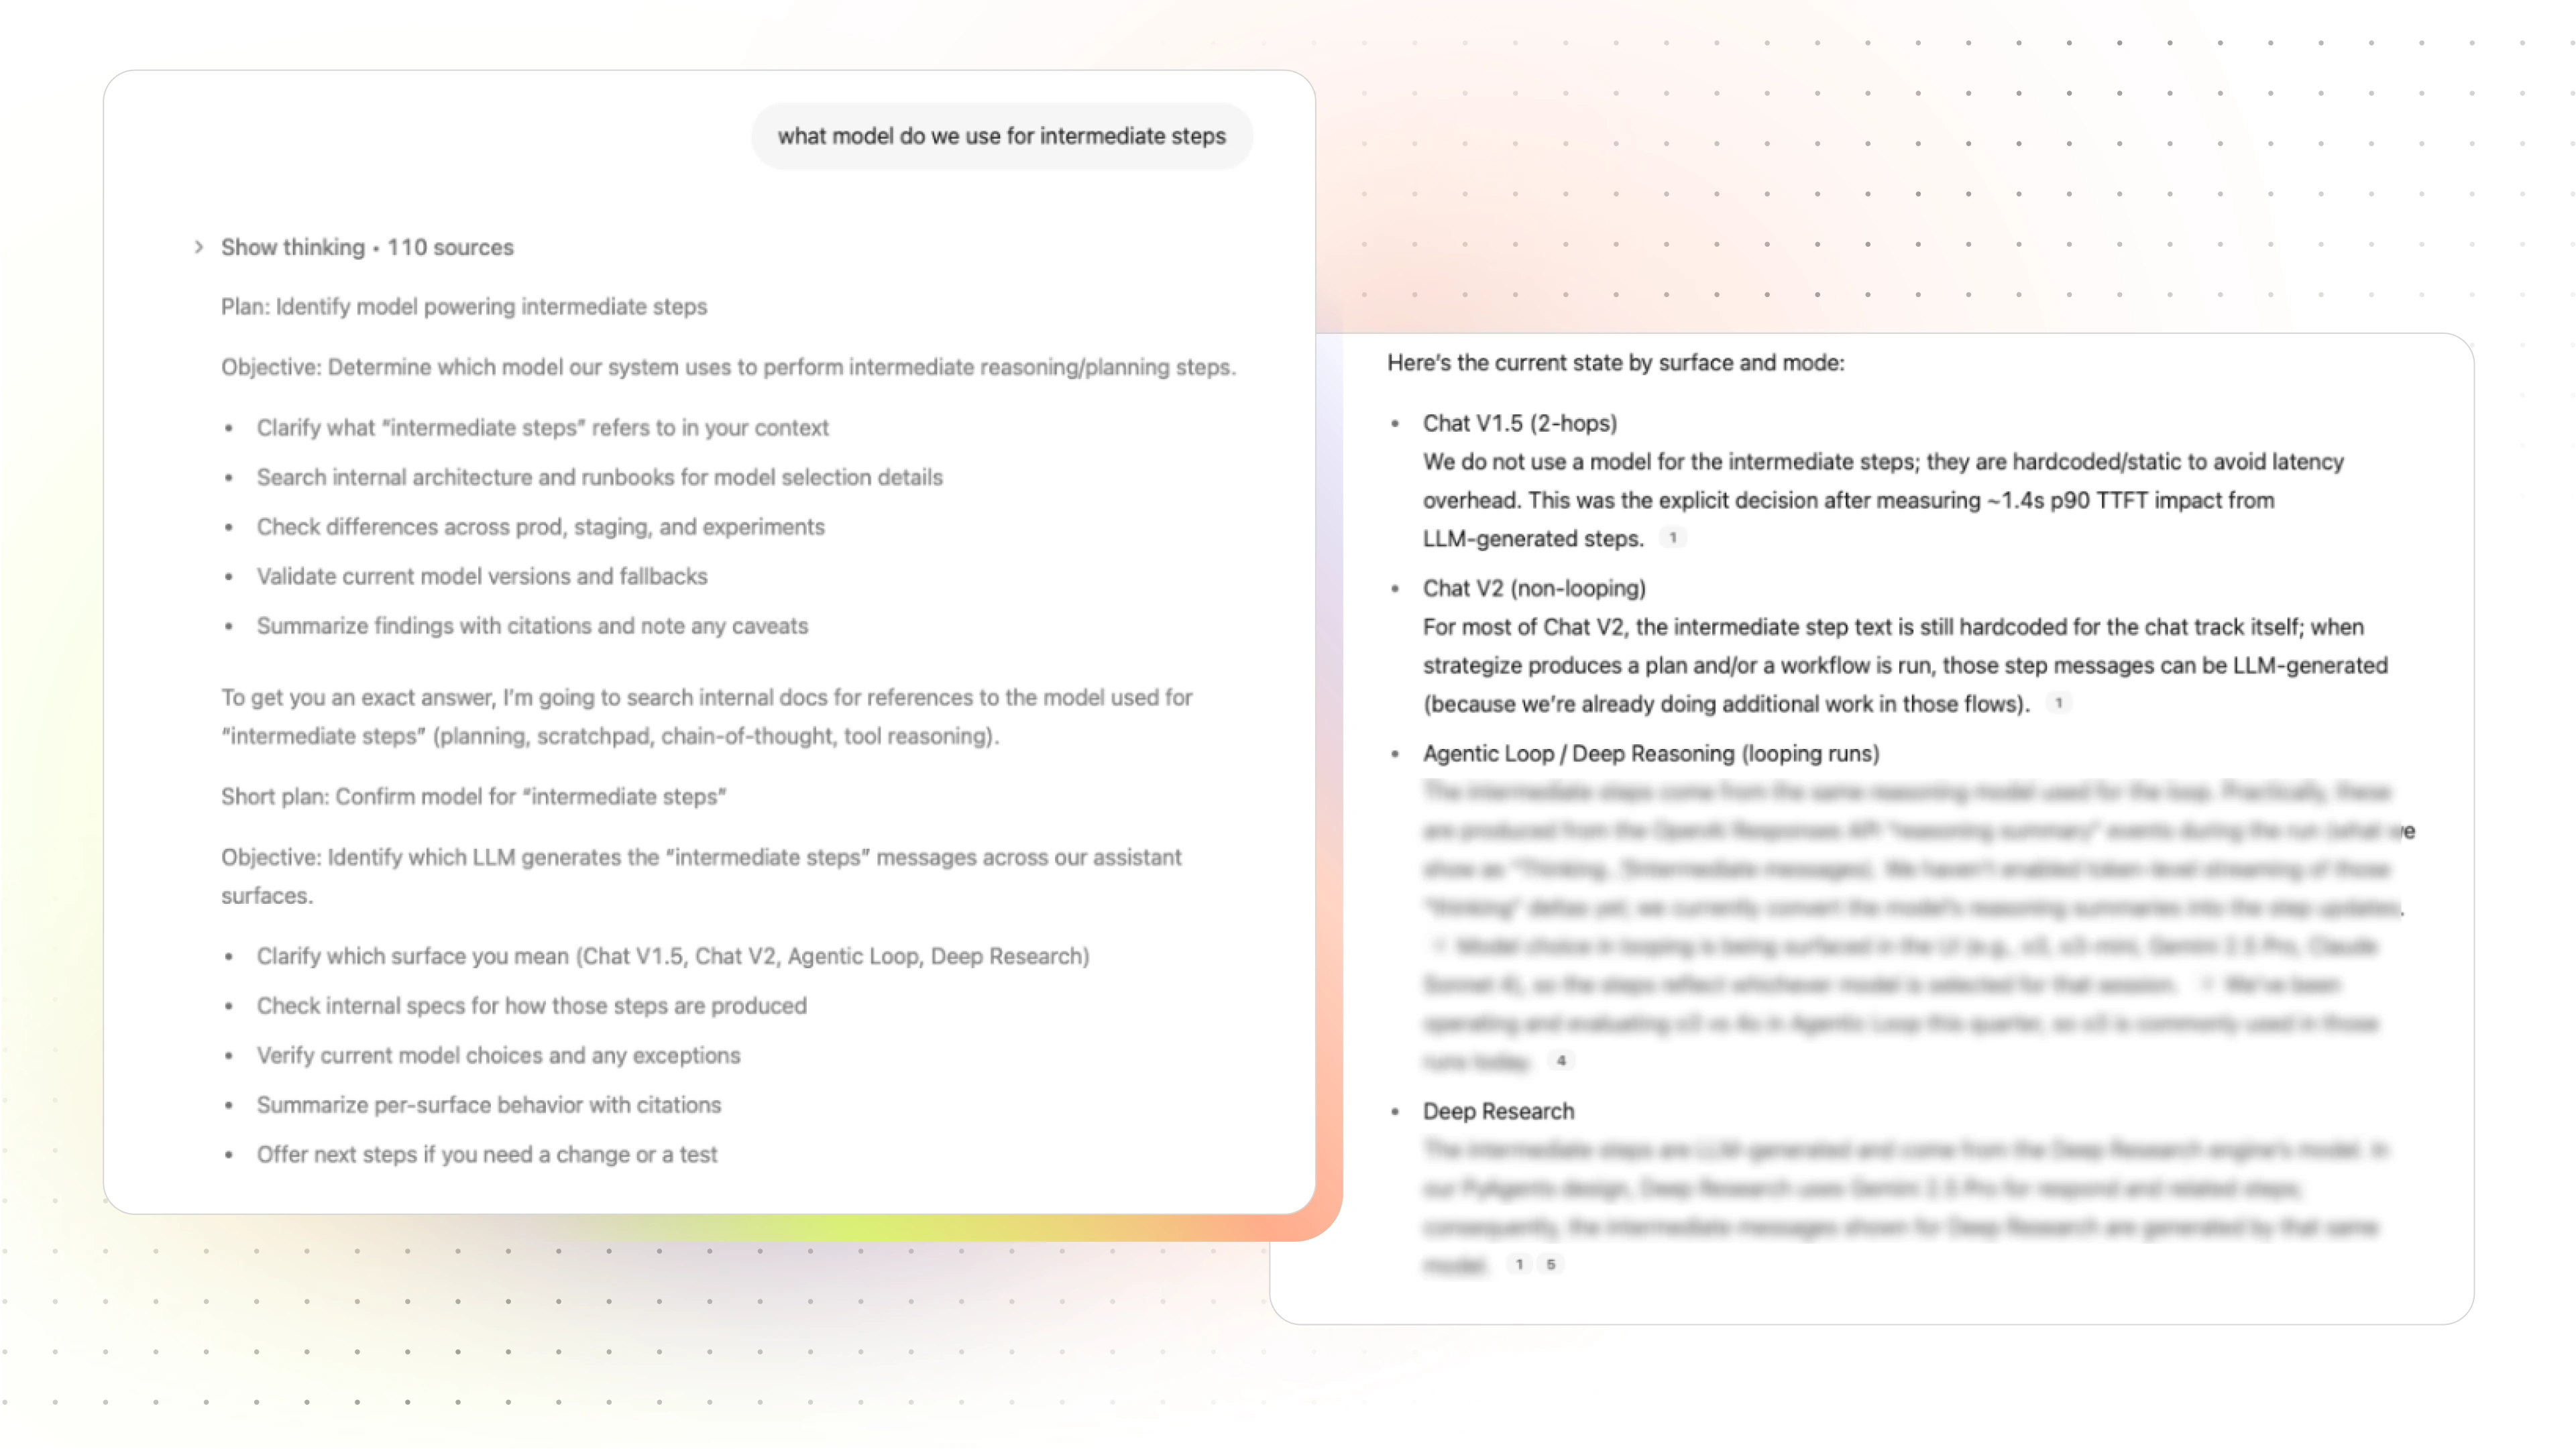
Voyons cela à l'œuvre dans un exemple de requête :
o3 a effectué une recherche initiale dans l'entreprise et a halluciné, identifiant à tort un seul modèle utilisé pour les étapes intermédiaires à partir des informations disponibles.
GPT-5 a exploité 110 sources pour trouver le contexte le plus pertinent, a reconnu qu'il existe plusieurs versions de notre architecture de raisonnement agentique et que les clients ont la flexibilité de choisir leur propre modèle dans les agents, en fournissant une réponse précise et complète.
GPT-5 sait mieux quand demander de l'aide
L'un des enseignements intéressants de GPT-5, c'est qu'il est capable d'évaluer quand répondre directement à une question ou quand revenir vers l'utilisateur pour poser des questions complémentaires.
Voyons cela appliqué à un exemple de requête :
Comme vous pouvez le voir dans le résultat ci-dessous, o3 est tombé dans le piège en supposant que Tony faisait référence à Tony Gentilcore, cofondateur de Glean dans l'ingénierie.
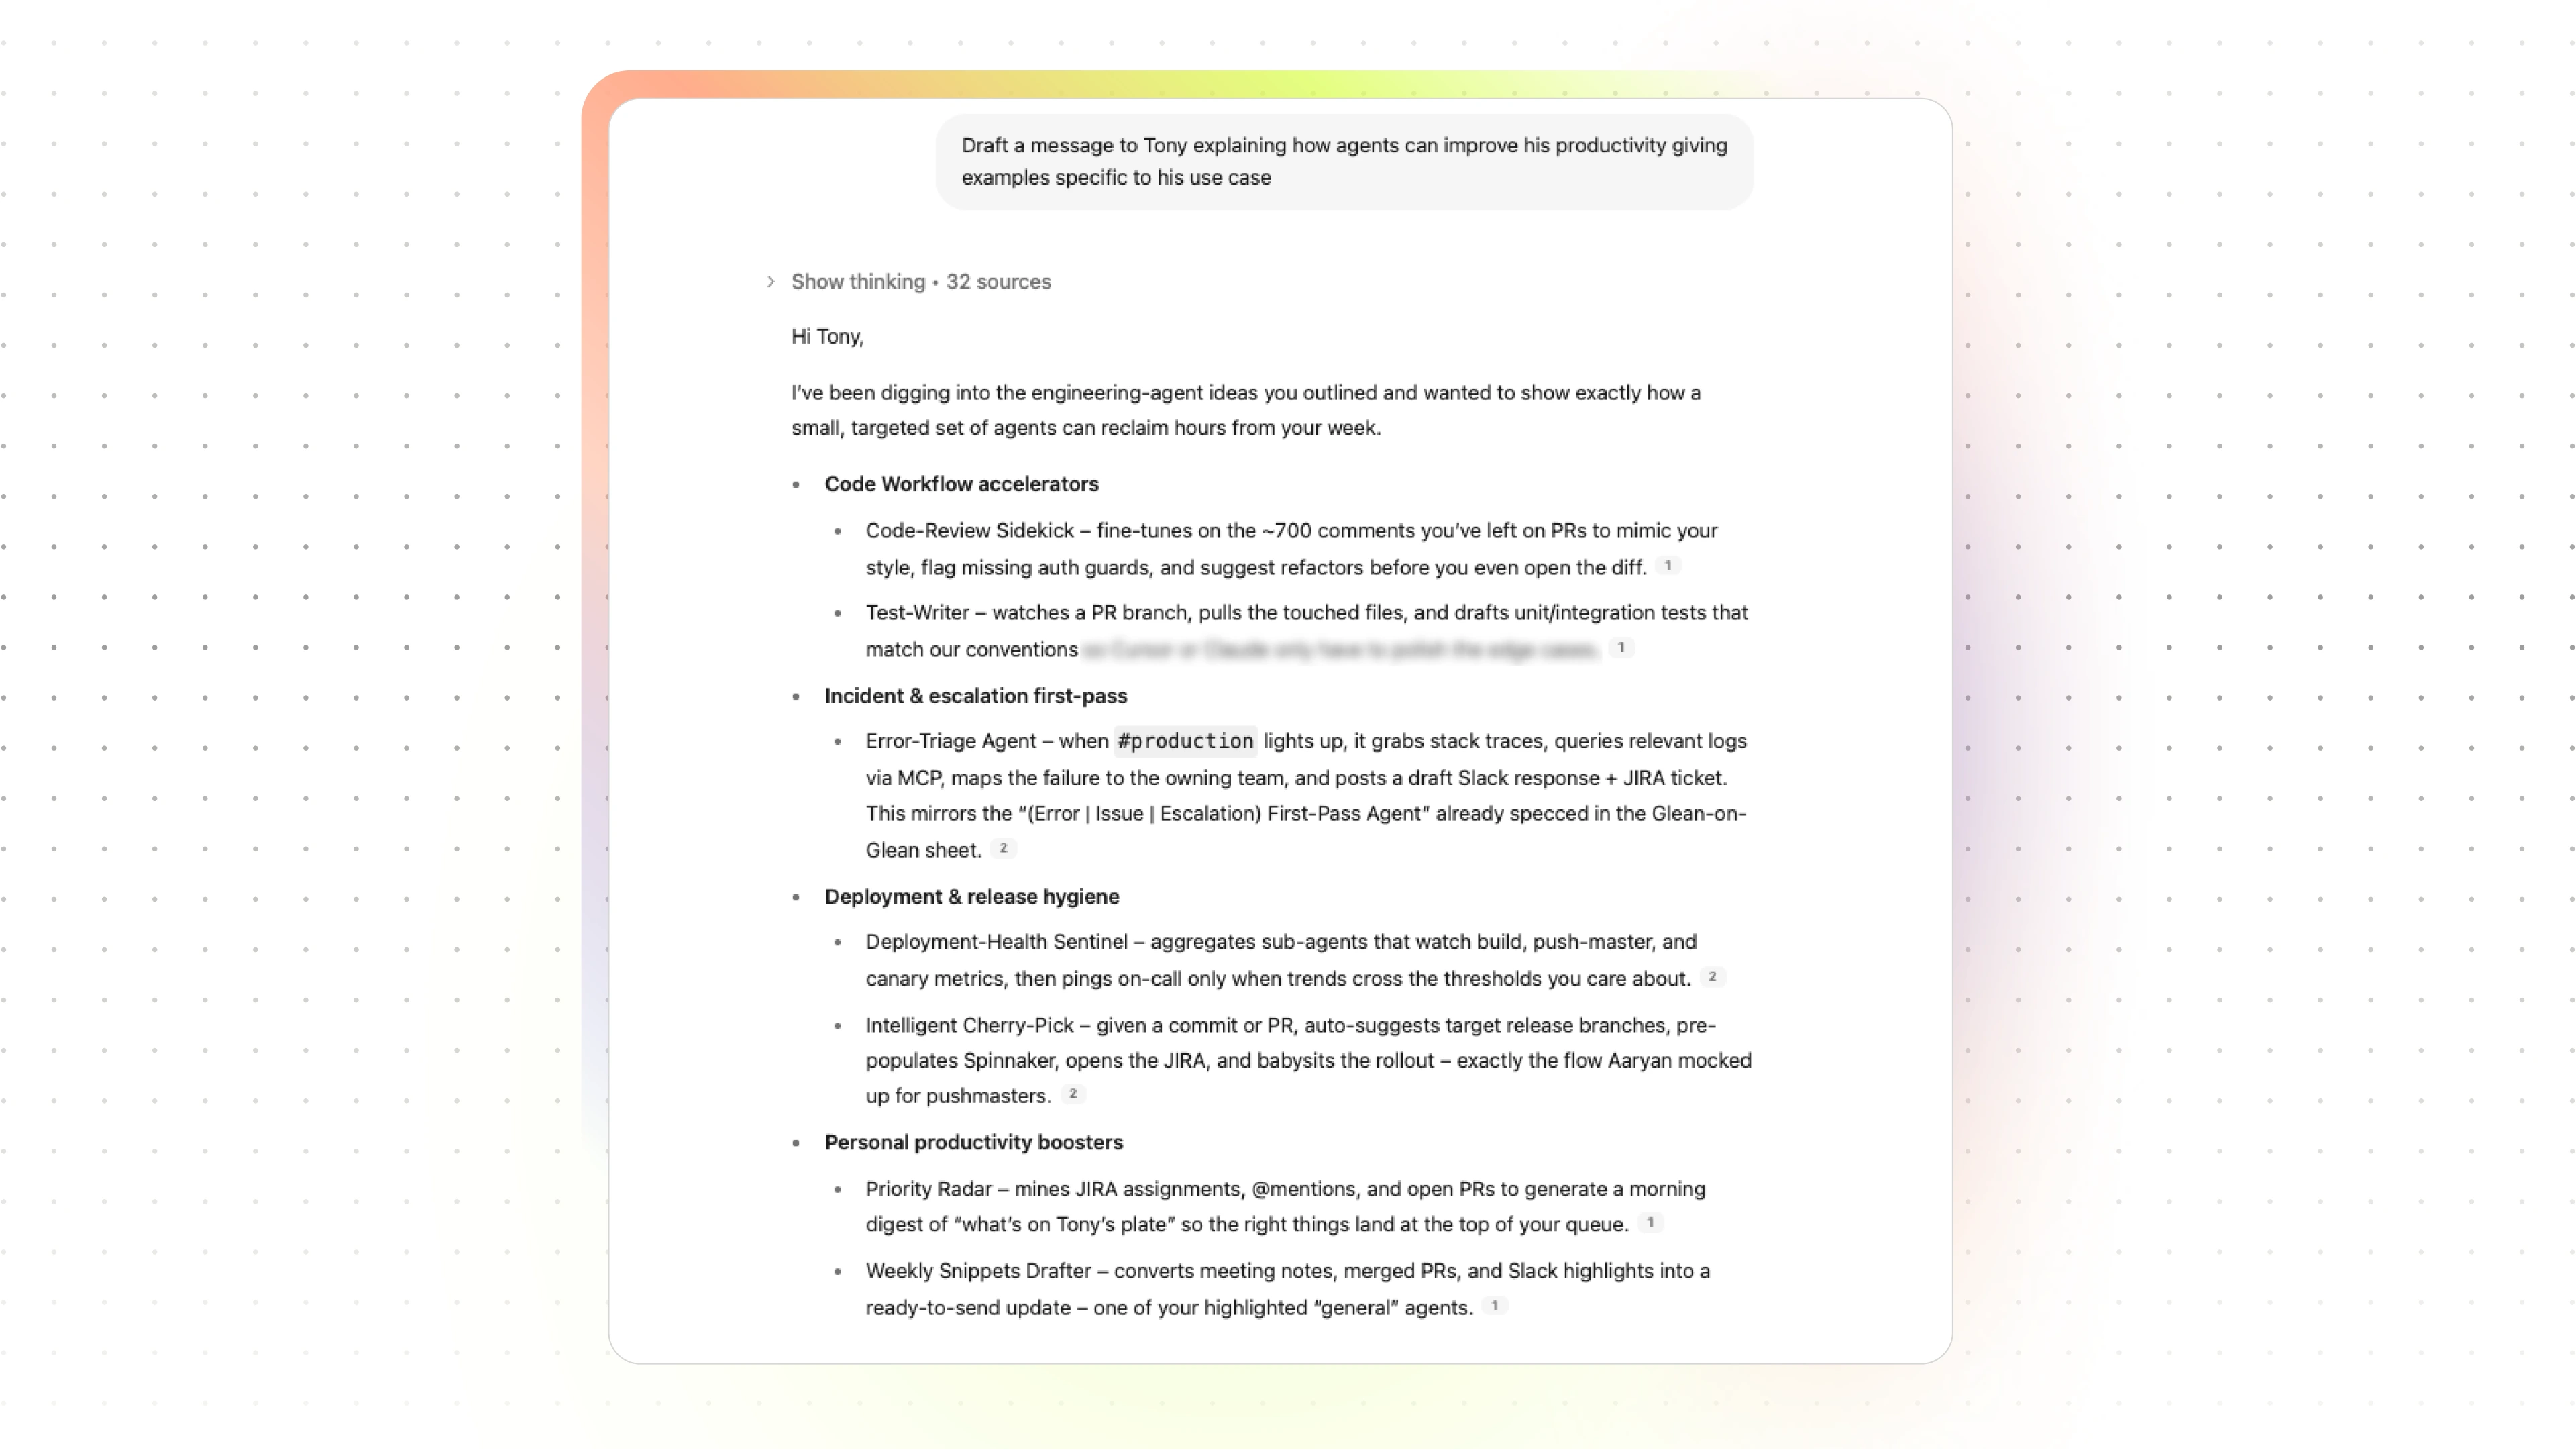
Mais en réalité, il y a deux Tony chez Glean. Les deux Tony devraient recevoir des réponses différentes, étant donné qu'ils occupent tous deux des rôles différents dans l'organisation. GPT-5 l'a compris en lançant une recherche élargie et en posant une question complémentaire, afin de mieux déterminer le meilleur chemin pour répondre à la question.

Nous avons vu les questions complémentaires devenir monnaie courante, à la fois dans l'expérience Glean Assistant et dans les chatbots IA grand public. Désormais, nous atteignons le point où le modèle peut déterminer quand il est pertinent de revenir rapidement vers l'utilisateur avec les informations dont il a besoin, lorsqu'il le peut, et d'engager une conversation uniquement lorsqu'il ne le peut pas. Ce changement rend chaque expérience conversationnelle plus précieuse.
GPT-5 introduit la verbosité, les premières évaluations montrent que nous allons l'implémenter
Anecdote : lorsque Glean a conçu à l'origine son expérience Assistant, notre équipe d'ingénierie a mis en place une instruction explicite privilégiant la concision autant que possible. Elle jugeait la qualité du chat de son propre point de vue, préférant aller droit au but plutôt que d'ajouter du superflu (leurs mots, pas les miens). Nous avons depuis supprimé ce paramètre, reconnaissant qu'il limitait la capacité de l'Assistant à s'adapter à la fois à la tâche et aux préférences individuelles.
Un ajout intéressant de GPT-5 est qu'il introduit la verbosité — la capacité d'aller de réponses brèves à moyennes jusqu'à longues — et peut répondre entièrement à la requête même en utilisant un niveau de verbosité moyen.
Voyons cela dans une requête Assistant pour une question d'assistance produit :
Pour cet exemple, o3 fournit une réponse bien formatée et complète, ce qui la rend idéale pour un article de centre d'aide.
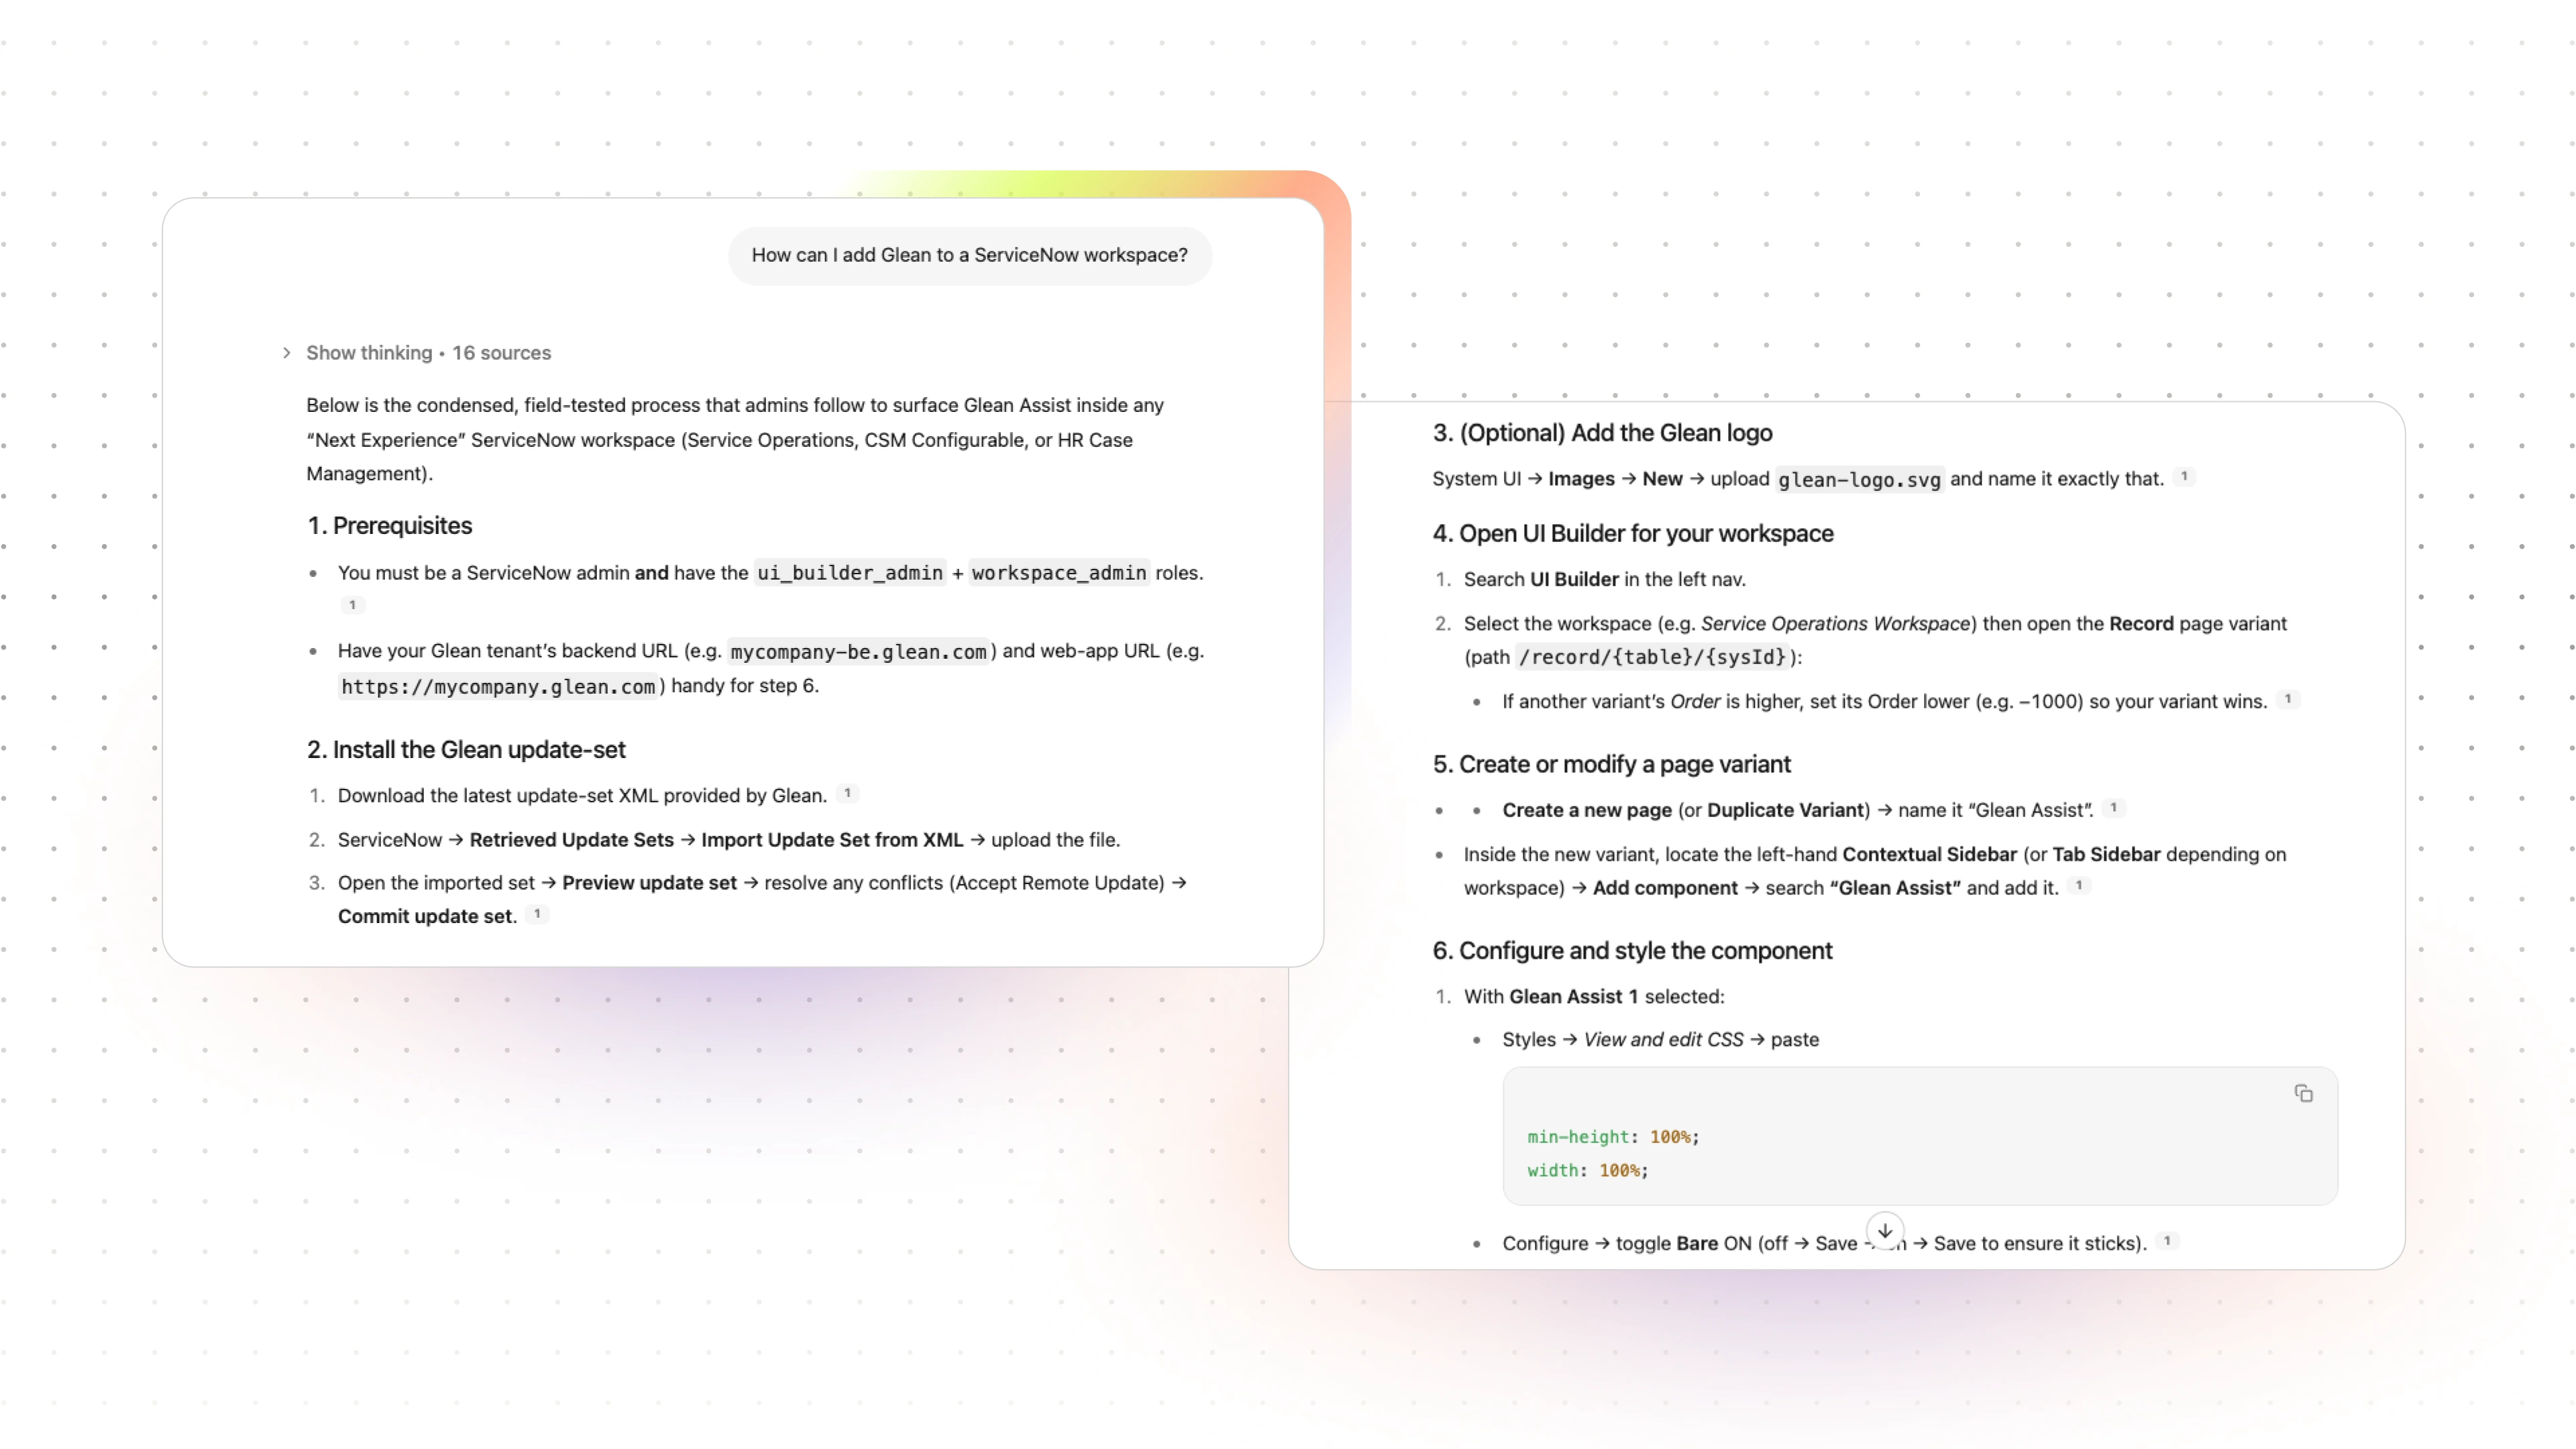
Maintenant, si j'étais un ingénieur préférant des réponses plus succinctes, je pourrais appliquer un paramètre de faible verbosité dans GPT-5, répondant à mes préférences sans rien perdre en exhaustivité.
Nous travaillons déjà à exploiter les contrôles de verbosité avec la personnalisation pour l'utilisateur final, à la fois globalement et selon la tâche, ainsi qu'à réduire la sortie de tokens lors des étapes intermédiaires des agents. Restez à l'écoute !
GPT-5 surmonte les défis de formatage rencontrés avec o3
Si la verbosité nous offre un nouveau niveau de contrôle, elle corrige également un défaut que nous avions constaté en passant de GPT-4.1 à o3 : une baisse de la qualité des réponses. La qualité des réponses offre une vision globale de la manière dont notre Assistant fournit des réponses précises, lisibles et alignées sur les attentes de l'utilisateur.
C'est parce que GPT-4.1 est bien meilleur pour structurer ses réponses qu'o3. C'est l'un des avantages de la nouvelle approche combinée des modèles polyvalents et de raisonnement : GPT-5 peut offrir les deux.
Nous avons pu le constater non seulement en échantillonnant les résultats des évaluations, mais aussi dans les métriques de formatage que nous exécutons. En examinant le formatage appliqué dans les réponses, nous pouvons voir que GPT-5, avec une verbosité élevée, est plus à même d'utiliser des listes et des séparateurs, donnant ainsi plus de structure au résultat.

Nous espérons qu'en maniant la verbosité de la bonne manière, nous pourrons contribuer à regagner une partie des métriques de qualité des réponses perdues avec o3.
Tous les modèles qui comptent, sur une seule plateforme
Si vous ne l'aviez pas encore compris, nous sommes vraiment enthousiasmés par les gains de performance que nous avons mesurés en évaluant GPT-5. Nos clients devraient se réjouir de notre prise en charge de ce nouveau modèle, et peuvent l'évaluer eux-mêmes, en comparant GPT-5 aux principaux modèles open source et commerciaux pour l'IA d'entreprise.
Si GPT-5 a réalisé des avancées en matière de raisonnement, aucun modèle n'est parfait pour tous les cas d'usage. C'est pourquoi Glean continue d'offrir à ses clients le choix du modèle, de prendre en charge les modèles les plus récents et de partager ouvertement les indicateurs de performance, afin que vous puissiez exploiter ces informations pour créer les expériences agentiques les plus performantes au travail.
Si vous êtes prêt à découvrir comment GPT-5 peut aider votre organisation à accomplir ses tâches, vous pouvez commencer à l'essayer dès aujourd'hui dans Glean Agents.
