







Le contexte d'entreprise est ce qui rend l'IA pertinente et précieuse au travail ; plus vous apportez de contexte, plus les insights sont riches. Bien que le contexte dans Glean soit soumis au respect des autorisations, ce respect ne vaut que ce que valent les autorisations sous-jacentes. Avec des centaines d'applications SaaS et des milliards de contenus générés par les utilisateurs, de nombreuses entreprises ne parviennent pas à suivre le rythme des contrôles d'accès et ont besoin d'aide supplémentaire pour préparer leurs données à l'IA.
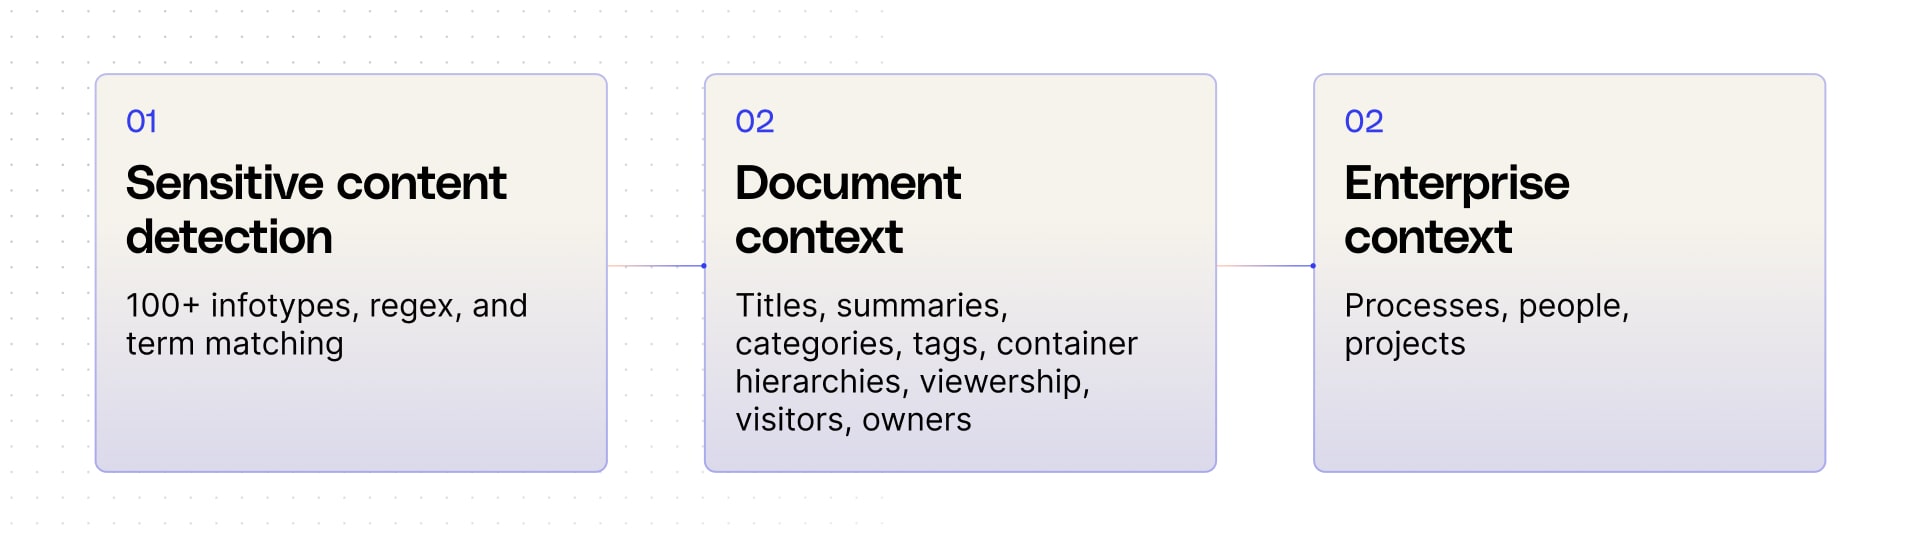
Nous avons présenté la protection continue et le masquage automatisé des contenus sensibles dans Glean sur plus de 100 sources de données lors de notre conférence utilisateurs annuelle, Glean:GO. Ces fonctionnalités ont permis aux clients de configurer des politiques personnalisées pour détecter les informations les plus sensibles pour leur organisation, des données des employés aux mots de passe et à l'authentification en passant par les projets top secret, à l'aide de plus de 100 infotypes, d'expressions régulières (regex) et de correspondances de termes.
Aujourd'hui, nous sommes ravis d'étendre cette capacité grâce à des modèles de contenu sensible qui séparent le signal du bruit en associant des classificateurs d'infotypes traditionnels à des modèles d'IA entraînés sur l'ensemble du contexte d'entreprise, comme le contenu des documents, les activités et les autorisations. Ces modèles de contenu sensible aident à distinguer les cas d'usage bénins d'une véritable exposition, avec un taux de précision de 80 % sur les données non structurées.
Si de nombreuses solutions détectent les contenus sensibles dans les données structurées, rares sont celles qui traitent les données non structurées, en particulier à l'échelle de couverture offerte par Glean. Le contenu non structuré n'a pas de schéma : la sensibilité dépend du contexte, et non seulement du contenu. C'est pourquoi les modèles de contenu sensible de Glean se démarquent : ils interprètent le contexte, en s'appuyant sur une recherche propriétaire et des graphes d'entreprise, autour des infotypes, des regex et des correspondances de termes, pour aider les entreprises à protéger automatiquement leurs données à grande échelle.
La conception des modèles de contenu sensible
Nous avons eu la chance de collaborer avec plusieurs entreprises dans le développement de ces modèles de contenu sensible, ce qui nous a permis de reproduire la manière dont les équipes de sécurité évaluent réellement l'exposition. Les équipes de sécurité de nos clients grands comptes nous ont également aidés à identifier des cas d'usage où les données sont moins sensibles qu'elles ne le paraissent au premier abord. Voici quelques exemples :
| Faible gravité | Gravité moyenne | Gravité élevée |
|---|---|---|
| Identifiants de test partagés avec l'ensemble de l'organisation. Justification de la faible gravité : supports de formation à la sécurité, où la valeur pédagogique l'emporte sur le risque d'exposition minime puisqu'ils sont signalés comme des exemples. |
Données personnelles identifiables partagées avec le service des Ressources humaines. Justification de la gravité moyenne : créées et partagées par le responsable du service des Ressources humaines. |
Numéro de sécurité sociale partagé avec l'ensemble de l'entreprise. Justification de la gravité élevée : contient des numéros de sécurité sociale de production et est accessible de manière anonyme via un lien, ce qui signifie qu'il est exposé publiquement. |
Comme le montrent les exemples ci-dessus, nous expliquons les décisions prises par les modèles de contenu sensible afin que vous puissiez comprendre leur logique. Grâce aux retours intégrés au produit, notamment les votes positifs et négatifs, les modèles continuent d'apprendre ce qui constitue des données sensibles pour les entreprises.
Les modèles de contenu sensible comprennent le contexte
La raison pour laquelle les modèles de contenu sensible peuvent raisonner sur des données non structurées est qu'ils comprennent le contexte : le contexte de chaque document, l'activité autour du document et les relations au sein de l'entreprise. Les modèles de contenu sensible examinent les relations sémantiques entre les titres des documents, les résumés de contenu et les schémas sensibles identifiés. Un document intitulé « Bonnes pratiques de sécurité » contenant des identifiants d'exemple est traité de manière fondamentalement différente d'un fichier appelé « Sauvegarde de la base de données de production » présentant des schémas de contenu similaires. Le système comprend les indices contextuels tels que « exemple », « échantillon », « modèle » et « formation » qui indiquent un usage pédagogique plutôt qu'opérationnel.
Glean va au-delà de l'analyse du document de manière isolée. Il examine également les documents étroitement liés ainsi que l'emplacement du document dans les structures de dossiers, les canaux, etc. Les documents appartenant aux équipes de sécurité, situés dans des conteneurs de formation ou étiquetés avec des métadonnées pédagogiques font l'objet d'évaluations de risque différentes de ceux présents dans les systèmes opérationnels.
Les modèles utilisent également le graphe d'entreprise, qui cartographie les relations derrière les données d'entreprise (y compris les personnes, les projets et les processus) pour rendre l'IA consciente du contexte. Le graphe d'entreprise peut discerner le rôle du document au sein de l'entreprise dans son ensemble, qu'il soit largement partagé entre les équipes de sécurité, fréquemment consulté par les formateurs ou intégré dans les parcours d'intégration, ce qui suggère l'existence d'un cas d'usage légitime pour le contenu sensible. À l'inverse, les documents présentant des schémas d'accès restreints, un historique de consultation limité ou des accès concentrés dans des rôles à privilèges élevés peuvent indiquer un risque plus important.
Mettez l'IA au travail en toute confiance grâce à la sécurité des données automatisée
Les modèles de contenu sensible marquent un tournant : chez Glean, nous utilisons désormais l'IA pour sécuriser l'IA elle-même. En comprenant à la fois le contexte des documents et celui de l'entreprise, nous pouvons créer des modèles d'IA capables de distinguer les données réelles et sensibles du bruit dans l'ensemble des données non structurées. Glean protège les contenus sensibles avec précision et met l'IA au travail en toute sécurité à l'échelle de l'entreprise.
Consultez notre page September Drop pour plus de détails sur les autres fonctionnalités passionnantes de Glean sorties cette semaine !
Les modèles de contenu sensible sont en version bêta et font partie de Glean Protect+, une suite de sécurité premium.
