
En quoi la recherche sémantique diffère-t-elle de la recherche par mots-clés, et laquelle améliore le plus la productivité en entreprise ?
La recherche sémantique surpasse la recherche par mots-clés en matière de productivité en entreprise, car elle fait correspondre le sens derrière une requête plutôt que ses mots exacts ainsi, les employés trouvent le bon document du premier coup au lieu de passer l’après-midi à deviner les termes.
La recherche par mots-clés parcourt un index à la recherche de jetons littéraux et classe les documents qui les contiennent. La recherche sémantique transforme les requêtes et les documents en embeddings vectoriels, puis renvoie les concepts les plus proches même lorsque les mots ne correspondent pas.
Cette distinction est particulièrement importante en entreprise, où la connaissance est répartie sur des dizaines d’outils — 74% of tech leaders disent que les employés perdent du temps à chercher sur plusieurs plateformes pour la trouver — et où des centaines d’auteurs utilisent une terminologie incohérente. La méthode de récupération que vous choisissez détermine la vitesse à laquelle les personnes obtiennent des réponses et la confiance avec laquelle elles agissent. Cet article explique le fonctionnement de chaque méthode, les limites de chacune, pourquoi la recherche hybride surpasse l’une ou l’autre prise isolément, et quelles technologies alimentent la recherche sémantique en entreprise.
En quoi la recherche sémantique diffère de la recherche par mots-clés dans les environnements d’entreprise
La recherche sémantique et la recherche par mots-clés adoptent des approches opposées pour accomplir la même tâche dans les enterprise environments. La recherche par mots-clés fait correspondre des jetons exacts à un index inversé et classe les résultats avec des algorithmes comme BM25 elle récupère donc les documents qui contiennent les mots précis saisis par l’utilisateur. La recherche sémantique convertit les requêtes et les documents en embeddings vectoriels, puis trouve les correspondances conceptuelles les plus proches même lorsque la requête et le document ne partagent aucun mot en commun.
Cet écart devient un problème quotidien, car les employés utilisent une terminologie incohérente entre les départements, les outils et les types de documents — 47% of digital workers ont du mal à trouver les informations dont ils ont besoin pour faire leur travail. Un système de mots-clés recherchant « leave policy » passe à côté d’un document intitulé « PTO guidelines », tandis qu’un système sémantique les reconnaît comme la même idée. La connaissance en entreprise est dispersée dans des dizaines d’applications, chacune avec ses propres conventions de nommage l’écart de vocabulaire est donc la norme plutôt que l’exception.
Le compromis est simple. La recherche par mots-clés optimise la précision sur des termes connus comme les SKU produits, les codes d’erreur et les numéros de politique. La recherche sémantique optimise le rappel pour des questions en langage naturel, où la personne qui demande peut ne pas connaître les bons mots. Les gains de la sémantique viennent du fait de combler les écarts de vocabulaire sans obliger les employés à deviner la formulation exacte qu’un auteur a utilisée.
| Dimension | Recherche par mots-clés | Recherche sémantique |
|---|---|---|
| Méthode de correspondance | Correspondance exacte de jetons sur un index inversé | Similarité vectorielle (distance cosinus) entre embeddings |
| Algorithme de classement | BM25 (fréquence des termes, IDF, normalisation par longueur) | Proximité conceptuelle dans un espace de grande dimension |
| Gère les synonymes | Uniquement avec des dictionnaires de synonymes maintenus manuellement | Oui, nativement |
| Gère les questions en langage naturel | Mal — traite les mots comme des jetons indépendants | Oui — interprète l’intention et le contexte |
| Idéal pour | Identifiants exacts : SKU, codes d’erreur, numéros de politique | Requêtes exploratoires, écarts de terminologie entre départements |
| Coût de calcul | Faible — recherches en moins d’une milliseconde | Plus élevé — nécessite souvent une infrastructure accélérée par GPU |
| Interprétabilité | Élevée — les utilisateurs voient exactement quels termes ont correspondu | Plus faible — les scores de similarité sont moins transparents |
Comment fonctionne la recherche par mots-clés et où elle apporte encore de la valeur
La recherche par mots-clés fonctionne en construisant un index inversé, une structure de données qui associe chaque terme unique d’un corpus aux documents qui le contiennent. Cette conception permet des recherches rapides, en moins d’une milliseconde, à grande échelle avec un minimum de calcul. Lorsqu’un utilisateur saisit une requête, le système récupère tous les documents contenant ces jetons exacts et les classe avec BM25, qui calcule un score selon la fréquence des termes, la fréquence inverse des documents et la normalisation par la longueur du document.
Avant la correspondance, le système traite le texte via la tokenisation, la mise en minuscules, la suppression des mots vides et le stemming, de sorte que « running », « runs » et « ran » se résolvent tous à la même forme de base. Ce pipeline est ce qui rend la recherche par mots-clés prévisible et peu coûteuse à exécuter.
La recherche par mots-clés conserve toute sa place dans des scénarios d’entreprise qui exigent une fiabilité de correspondance exacte. Exemples : rechercher un code d’erreur comme « OOM-2024-047 », retrouver un document via son SKU ou son numéro de commande, et effectuer des recherches juridiques ou de conformité où chaque document contenant un terme précis doit remonter. Son interprétabilité est un réel avantage pour la confiance : les utilisateurs peuvent voir exactement quels termes ont correspondu et pourquoi un résultat est mieux classé, ce qui rend l’ajustement de la pertinence simple pour les administrateurs.
Là où la recherche par mots-clés montre ses limites en entreprise
La recherche par mots-clés n’a aucune notion de sens elle traite donc « revenue deterioration » et « sales decline » comme des chaînes sans lien et passe à côté de résultats pertinents lorsque le vocabulaire diverge. Comme les contenus d’entreprise sont rédigés par des centaines de personnes dans différents départements, l’incohérence terminologique est la règle. Combler cet écart avec la recherche par mots-clés implique de maintenir manuellement des dictionnaires de synonymes, et ceux-ci deviennent coûteux à mesure que les contenus et le vocabulaire évoluent. Les requêtes multi-mots comme « What do eagles eat ? » sont traitées comme des jetons indépendants, sans comprendre que l’utilisateur pose une question ni que « eagles » désigne l’oiseau plutôt qu’une équipe ou un groupe.
Comment fonctionne la recherche sémantique et pourquoi elle est essentielle pour la recherche d’informations en entreprise
La recherche sémantique s’appuie sur des modèles de réseaux de neurones, comme des architectures de type transformer telles que BERT, pour convertir à la fois les requêtes et les documents en embeddings vectoriels denses. Il s’agit de représentations mathématiques qui rapprochent les contenus conceptuellement similaires dans un espace de grande dimension. La recherche devient alors un problème de similarité plutôt qu’un problème de correspondance exacte : le système calcule la similarité cosinus entre le vecteur de la requête et les vecteurs des documents, puis renvoie les résultats les plus proches, classés selon leur proximité conceptuelle.
Le processus se déroule en trois étapes. D’abord, il interprète l’intention de l’utilisateur via le traitement du langage naturel. Ensuite, il analyse le contexte en examinant les relations entre les mots et les concepts. Enfin, il classe les résultats selon la correspondance avec le sens de la requête plutôt qu’avec ses mots exacts. En pratique, cela permet à la recherche sémantique de relier « résoudre un problème de connexion après réinitialisation du mot de passe » à des guides de dépannage de l’authentification, à de la documentation de récupération d’accès et à des FAQ associées, même si aucun de ces documents ne contient l’expression exacte.
La qualité des embeddings dépend directement de la qualité du contenu. Des documents avec des descriptions trop succinctes, des titres obscurs ou des métadonnées manquantes produisent des embeddings faibles qui dégradent la précision de la recherche, raison pour laquelle la préparation du corpus est un prérequis à une recherche sémantique efficace.
Le rôle du contexte dans la recherche sémantique en entreprise
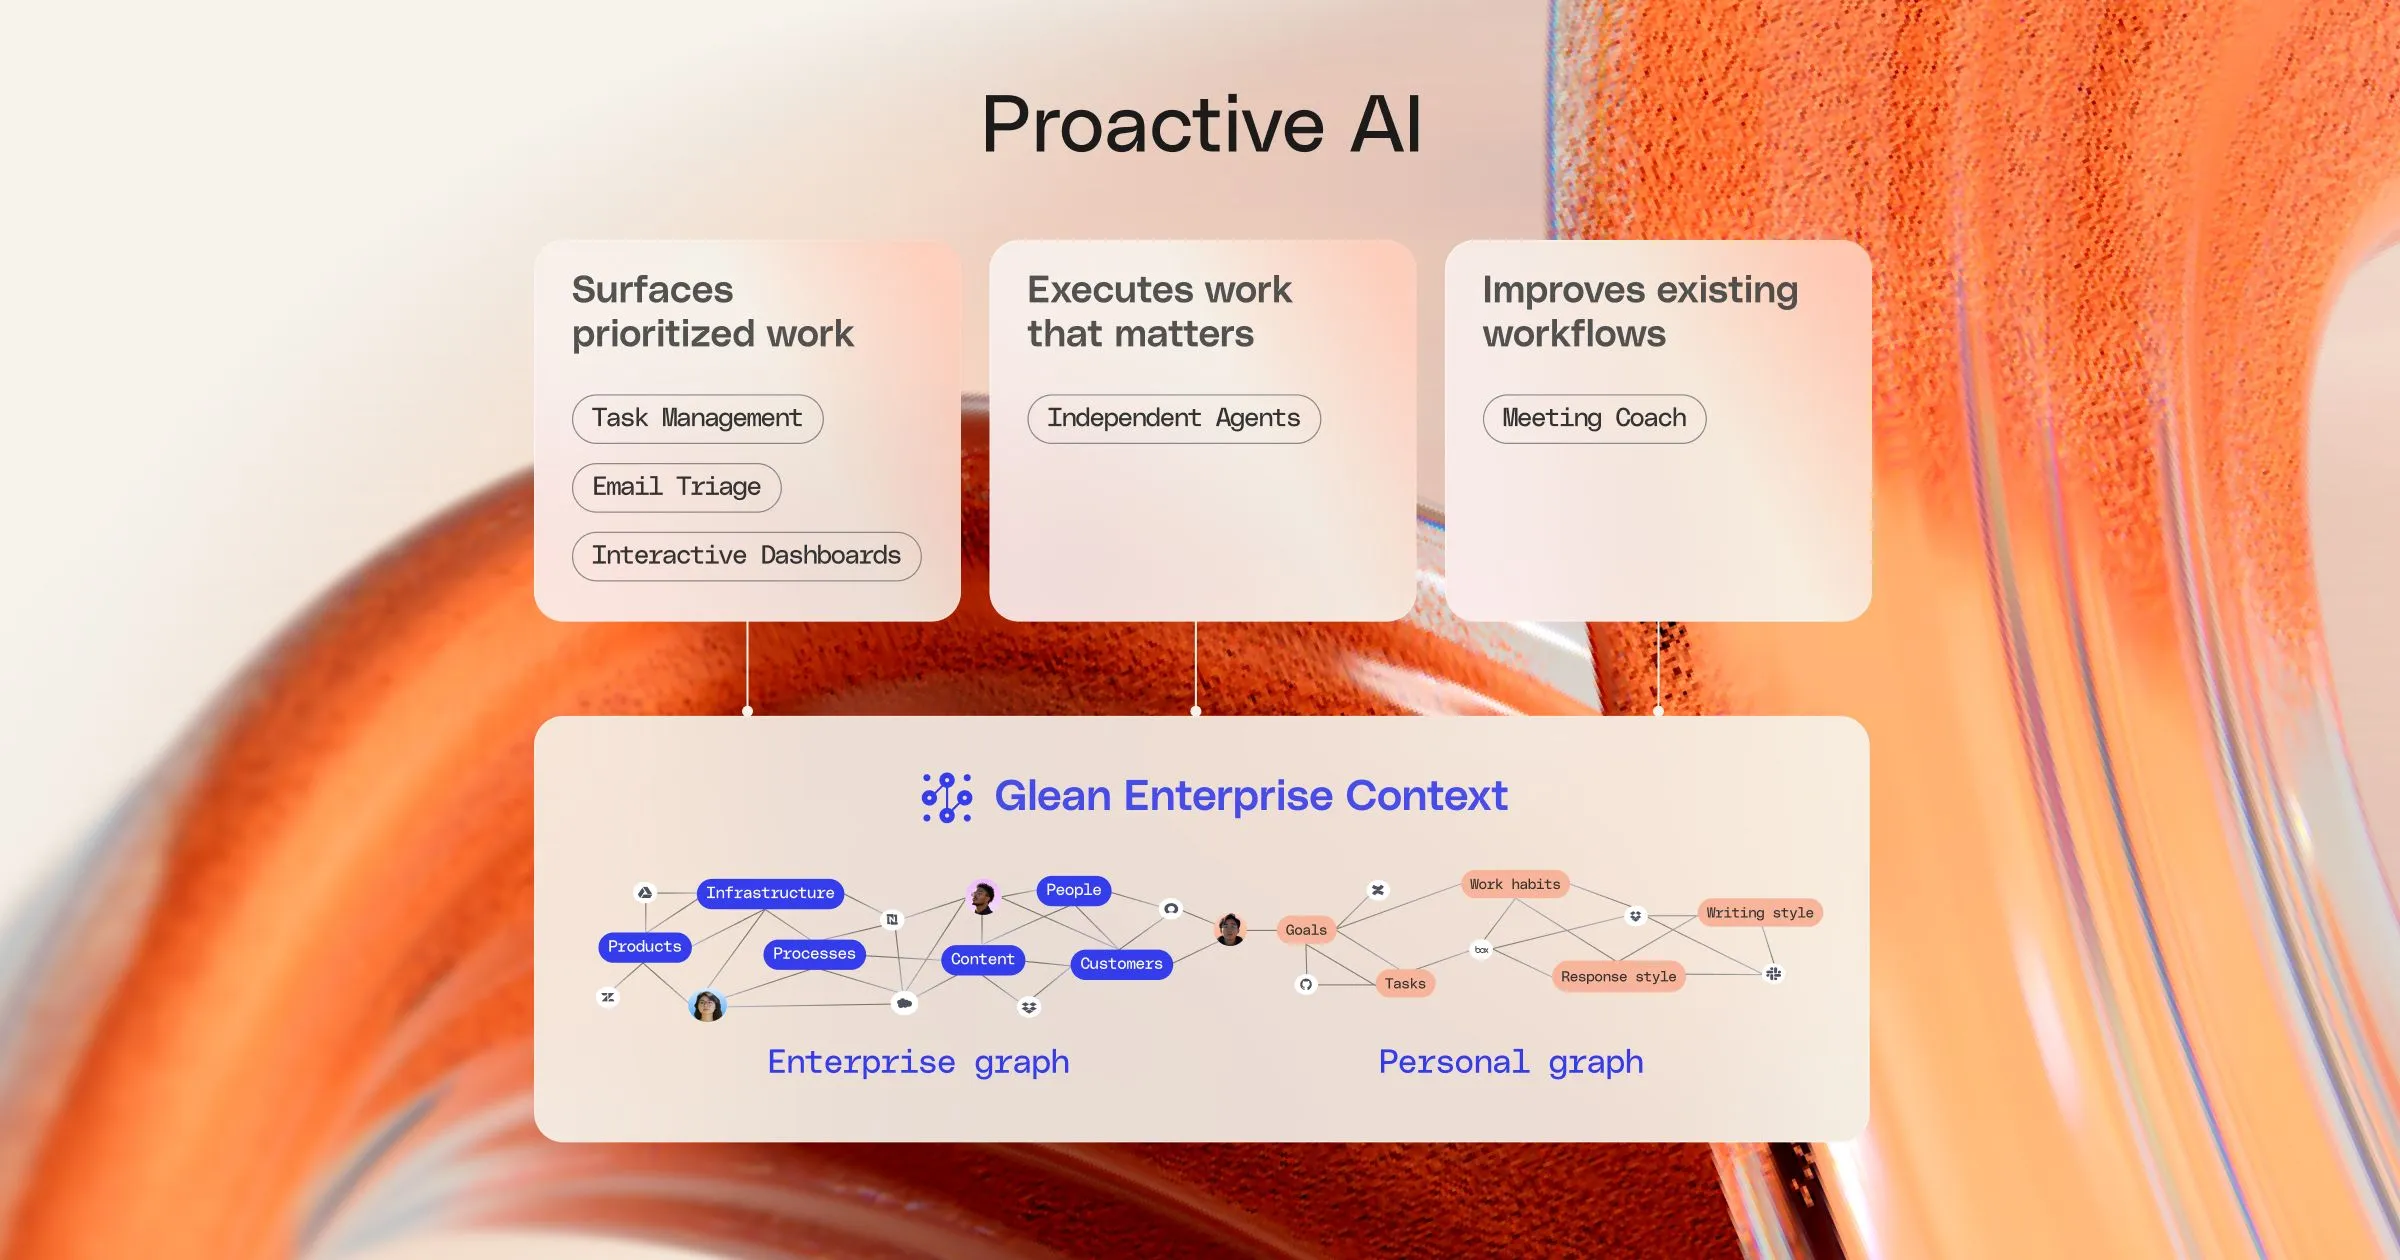
Les systèmes de recherche en entreprise qui superposent un contexte organisationnel à la similarité sémantique renvoient des résultats bien plus pertinents que la seule correspondance sémantique. Ce contexte inclut l’auteur d’un document, l’équipe qui l’utilise, la date de dernier accès, ainsi que l’identité de la personne qui effectue la recherche. Un système qui comprend à la fois un Enterprise Graph, c’est-à-dire les relations à l’échelle de l’organisation entre les personnes, les contenus et les interactions, et un Personal Graph, les signaux individuels propres à chaque utilisateur, peut distinguer une « revue de pipeline » d’un commercial de celle d’un ingénieur, et renvoyer le bon résultat pour chacun. Glean a construit sa recherche sur précisément ce système de contexte. La gestion des permissions doit être appliquée en amont de tout modèle de langage, car une recherche sémantique qui fait remonter des documents qu’un utilisateur ne devrait pas voir crée un risque de sécurité, pas un gain de productivité.
Pourquoi la recherche hybride surpasse chacune des méthodes prises isolément dans les environnements d’entreprise
La recherche hybride surpasse chacune des méthodes prises isolément, car elle combine le scoring lexical (mots-clés et BM25) et le scoring sémantique (similarité vectorielle) au sein d’un même pipeline de recherche. Elle capture les correspondances exactes lorsqu’elles existent et retrouve du contenu conceptuellement pertinent lorsque le vocabulaire diverge, offrant le meilleur des deux mondes. Les requêtes en entreprise ont besoin des deux, car elles couvrent un large spectre : certaines sont des recherches précises comme « policy-2024-Q3-rev2 », d’autres sont des questions en langage naturel comme « comment gérons-nous les remboursements clients en EMEA ? », et beaucoup se situent entre les deux.
Une architecture courante exécute les deux moteurs en parallèle et fusionne les résultats via une fusion de scores, ou utilise une approche en deux étapes où l’un génère des candidats et l’autre les reranke. Dans les deux cas, le résultat réduit à la fois les échecs « aucun résultat » des systèmes uniquement à mots-clés et le bruit des correspondances « souples » des systèmes uniquement sémantiques. Associer une recherche hybride à la génération augmentée par récupération (RAG) produit des réponses étayées et citées plutôt que des synthèses au jugé, car la couche de recherche fournit à la couche de génération les bonnes sources.
Les plateformes de recherche qui combinent la recherche hybride à des signaux de contexte basés sur des graphes, couvrant qui, quoi, quand et où, renvoient de manière constante de meilleurs résultats que les systèmes construits sur une seule méthode de recherche.
Comment le choix de la méthode de recherche impacte la productivité et la prise de décision en entreprise
Le choix de la méthode de recherche façonne directement la productivité en entreprise, car il détermine combien de temps de recherche les employés récupèrent. Une analyse récente a montré que les employés perdent plus de trois heures par jour à chercher des informations, à recréer du travail perdu ou à attendre des collègues la différence entre deviner des termes et obtenir une réponse se cumule donc très vite. Les systèmes uniquement à mots-clés obligent les employés à deviner la bonne terminologie, à essayer plusieurs variantes de requête et à parcourir les résultats manuellement. Chaque tentative de recherche infructueuse se traduit par des heures perdues à l’échelle de l’organisation.
La recherche sémantique réduit le délai d’obtention d’une réponse en faisant remonter des résultats pertinents dès la première requête, même lorsqu’un employé ne connaît pas le terme canonique. Ce bénéfice est maximal lors de l’onboarding, des projets transverses et de l’intégration post-acquisition, où le vocabulaire est méconnu. La prise de décision s’améliore aussi, car une recherche qui relie des informations connexes à travers les systèmes donne aux équipes une vision plus complète : un membre de l’équipe finance qui étudie l’optimisation des coûts devrait aussi voir des postmortems d’ingénierie pertinents, des contrats fournisseurs et des tableaux de bord opérationnels.
Une recherche qui combine compréhension sémantique, recherche hybride et contexte organisationnel fait évoluer l’expérience des employés de « chercher et assembler », en consultant plusieurs outils et en recollant des fragments, vers « demander et agir », en obtenant une réponse étayée et en passant à l’étape suivante.
Quelles technologies prennent en charge la recherche sémantique dans les applications d’entreprise
Plusieurs technologies fonctionnent ensemble pour prendre en charge la recherche sémantique dans les applications d’entreprise. Les modèles d’embeddings basés sur des transformers, notamment BERT et les architectures bi-encodeur, convertissent le texte en vecteurs denses qui capturent le sens. Le choix du modèle, et le fait qu’il soit ou non affiné (fine-tuned) sur du contenu spécifique au domaine, affecte directement la qualité de la recherche. Les index vectoriels et les algorithmes de recherche de plus proches voisins approximatifs (ANN) permettent ensuite une recherche par similarité rapide à grande échelle, même s’ils exigent davantage d’infrastructure de calcul, souvent accélérée par GPU, qu’un index inversé traditionnel.
Au-dessus de la couche de recherche, la génération augmentée par récupération (RAG) associe la recherche hybride à de grands modèles de langage pour générer des réponses conversationnelles, sourcées et citées, ancrées dans des documents de référence. Au lieu de renvoyer une liste de liens classés, le système synthétise une réponse et indique ses sources. Les implémentations de niveau entreprise ajoutent trois exigences supplémentaires : une recherche tenant compte des permissions qui applique les contrôles d’accès existants au moment de la requête, une journalisation d’audit pour la conformité, et des connecteurs couvrant les bases de connaissances, les systèmes de tickets, les CRM, les outils de communication et le stockage cloud.
Un système de contexte relie ces éléments entre eux. Combiner un Graph d’entreprise des relations organisationnelles avec un Graph personnel des habitudes de travail individuelles rend la recherche sémantiquement précise et contextuellement pertinente pour la personne spécifique qui pose la question.
Questions fréquemment posées
Quelles sont les principales différences entre la recherche sémantique et la recherche par mots-clés ?
La recherche par mots-clés fait correspondre des jetons exacts à un index et classe les résultats selon des statistiques de termes comme BM25. La recherche sémantique convertit le texte en embeddings vectoriels et classe selon la similarité conceptuelle. En bref, la recherche par mots-clés optimise la précision sur des termes connus, et la recherche sémantique optimise le rappel sur l’intention en langage naturel lorsque les mots exacts diffèrent.
Comment la recherche sémantique améliore-t-elle la recherche d’information en entreprise ?
La recherche sémantique comble les écarts de vocabulaire entre services et outils, réduit les requêtes sans résultat et fait remonter du contenu conceptuellement lié, même lorsqu’un utilisateur ne connaît pas le terme canonique. Cela réduit le temps pour obtenir une réponse et diminue la création de contenu en doublon, puisque les personnes trouvent ce qui existe déjà au lieu de le réécrire depuis zéro.
Quelles sont les limites de la recherche par mots-clés dans les environnements d’entreprise ?
La recherche par mots-clés ne peut pas gérer les synonymes, les paraphrases ou l’intention sans dictionnaires de synonymes maintenus manuellement. Elle a aussi du mal lorsque le contenu d’entreprise utilise une terminologie incohérente entre équipes, ce qui est l’état par défaut dans la plupart des grandes organisations. Une recherche sur « politique de congés » passera tout simplement à côté d’un document intitulé « directives PTO ».
Quand devrais-je utiliser la recherche sémantique plutôt que la recherche par mots-clés ?
Utilisez la recherche sémantique lorsque les employés posent des questions en langage naturel, lorsque la terminologie varie d’une équipe à l’autre, ou lorsque les requêtes sont exploratoires. Utilisez la recherche par mots-clés pour des identifiants précis, des recherches de conformité et des requêtes structurées qui nécessitent la fiabilité d’une correspondance exacte. Pour une recherche en entreprise en production, utilisez les deux dans une architecture hybride afin que chaque méthode couvre les lacunes de l’autre.
Quel rôle la qualité du contenu joue-t-elle dans la précision de la recherche sémantique ?
La recherche sémantique n’est aussi bonne que le contenu qu’elle indexe. Les documents avec des descriptions succinctes, des métadonnées manquantes ou des titres cryptiques produisent des embeddings faibles qui mènent à des résultats non pertinents. Cela fait de la préparation du corpus et de l’enrichissement des métadonnées un prérequis à un déploiement efficace, et non une étape de nettoyage optionnelle après coup.
Choisir la bonne méthode de recherche, c’est la différence entre des employés qui cherchent des réponses et des employés qui les obtiennent et passent à autre chose. Nous avons conçu notre plateforme Work AI pour combiner une recherche hybride, une recherche tenant compte des autorisations et un système de contexte afin que vous obteniez des réponses fondées, avec citations, où que vous travailliez. Demandez une démo pour découvrir comment Glean et l’IA peuvent transformer votre lieu de travail.