






Vous avez créé votre premier agent. Vous lancez quelques requêtes de test, et les résultats semblent prometteurs — et maintenant ? La clé pour passer d'une démo sympathique à un agent fiable, c'est de créer une évaluation.
Tout le monde devrait apprendre à évaluer les agents, non seulement parce que cela renforce la confiance dans leur qualité, mais aussi parce que cela vous apprend à tirer le meilleur parti de votre plateforme d'agents. Les meilleures plateformes d'agents rendent les évaluations accessibles en garantissant que les agents excellent dans les fondamentaux. Pensez au respect des instructions, à la sécurité, à la personnalisation et à la conscience du contexte. Cela permet aux créateurs de concentrer leurs évaluations sur les critères de qualité de plus haut niveau qui rendent les agents réellement utiles pour les utilisateurs finaux.
Chez Glean, nous menons des évaluations à grande échelle depuis des années, en nous appuyant sur ce que nous avons appris de la recherche. Dans cet article, nous aborderons les deux aspects : comment évaluer des agents individuels pour les améliorer, et comment nous abordons les évaluations à grande échelle pour garder les agents fiables dans toute l'entreprise.
Comment concevoir votre évaluation
Considérez une évaluation comme une manière structurée d'observer les performances de votre agent dans le monde réel. Avant de commencer à créer votre agent, posez-vous quelques questions simples :
- De quoi votre équipe a-t-elle besoin ? Imaginez les workflows les plus importants que vos utilisateurs doivent gérer. Comment un agent IA peut-il les aider à donner le meilleur d'eux-mêmes ?
- À quoi ressemble un travail de qualité ? Si vous deviez noter la production de l'agent, quel serait le critère de réussite le plus important ? C'est votre étoile polaire.
Répondre tôt à ces questions vous aidera à concevoir une évaluation ciblée et interprétable, qui vous fournira des indications efficaces sur la façon d'améliorer votre agent.
Partez de la réalité : créer votre jeu d'évaluation
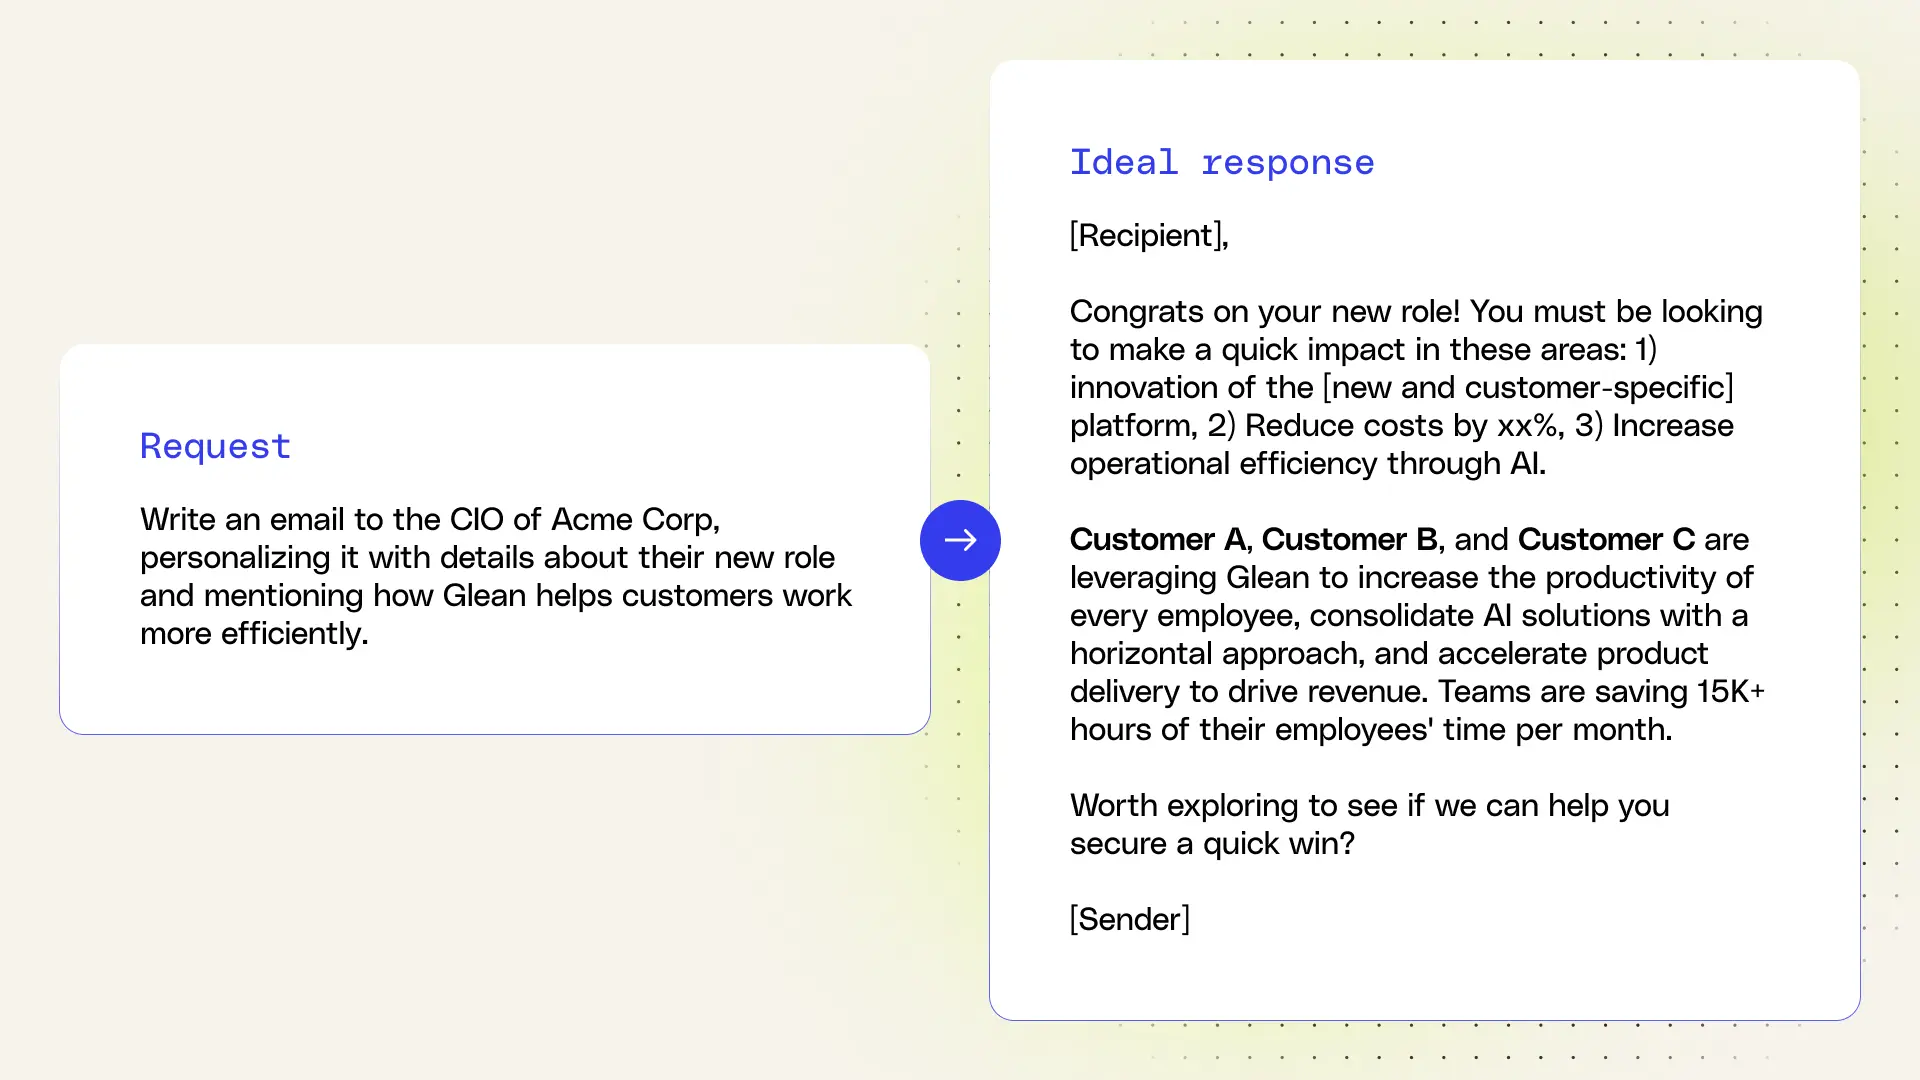
Une bonne évaluation commence par un jeu d'évaluation : un ensemble représentatif d'instructions utilisateurs associées aux réponses idéales. La meilleure façon de constituer un jeu d'évaluation, c'est d'aller directement à la source : vos utilisateurs. Commencez par demander à quelques experts métier parmi vos utilisateurs de vous aider à sélectionner un petit ensemble de haute qualité d'environ 20 exemples réels. C'est bien plus précieux que de s'appuyer uniquement sur des benchmarks publics ou des requêtes hypothétiques, qui passent souvent à côté de la complexité de votre activité.
N'ayez pas peur des jeux d'évaluation complexes ! Les utilisateurs ont tendance à pousser les capacités des agents en demandant des tâches en plusieurs étapes sur plusieurs sources. Ce ne sont pas des cas marginaux, mais souvent les tâches les plus précieuses à accomplir. Commencez par tester les instructions sur lesquelles vous avez des doutes afin de voir exactement ce que votre agent peut gérer avant de vous lancer dans les optimisations.
Par exemple, lorsque nous avons créé un agent de prospection commerciale, nous avons demandé à l'équipe des ventes ce qui fait un excellent email de premier contact. Leurs retours et leurs exemples idéaux sont devenus le cœur de notre jeu d'évaluation.
À quoi ressemble la réussite ? Choisir vos métriques
Une fois que vous disposez de votre jeu d'évaluation, vous avez besoin d'une manière cohérente de noter les performances de l'agent. C'est là qu'interviennent les métriques. Commencez par une seule métrique étoile polaire, la mesure la plus importante de la qualité ou de l'utilité de l'agent, sur laquelle tout le monde peut s'aligner.
Se concentrer sur une seule métrique principale ne signifie pas ignorer la façon dont elle est atteinte. Imaginez un bon agent comme un groupe de musique jouant en harmonie : si le son d'ensemble est l'étoile polaire, chaque instrument doit être accordé. Décomposez votre métrique étoile polaire en 2 à 4 sous-métriques simples pour noter de manière cohérente et avoir une vision claire de ce qu'il faut améliorer. Pour notre agent de prospection commerciale, notre étoile polaire était la qualité du message, que nous avons décomposée en quatre composantes :
- Exhaustivité : le message contient-il tous les ingrédients clés ?
- Une accroche percutante pour capter l'attention.
- Une mention de la priorité stratégique du prospect.
- Le défi qui bloque cette priorité.
- Le résultat commercial positif que Glean apporte.
- Un élément de preuve (comme une statistique ou un exemple client).
- Un appel à l'action clair.
- Personnalisation : le message est-il adapté au prospect ?
- Pertinent : « Votre expansion en Europe avec [programme client] ajoute beaucoup de complexité — comment votre équipe gère-t-elle le partage des connaissances à travers les fuseaux horaires et les régions ? »
- Générique : « Je vois que vous déployez l'IA dans votre application — la prochaine étape, c'est l'IA pour vos équipes internes ? »
- Ton : le message semble-t-il personnel, pertinent et facile à comprendre ?
- Parfait : « Vos ingénieurs ne consacrent que deux heures par jour au code — Glean les aide à récupérer le reste de leur temps en rendant le code, les documents et les tickets rapidement accessibles. »
- Mauvais ton : « La technologie de recherche propriétaire de Glean interroge diverses sources de données non structurées afin d'identifier les documents de l'entreprise pertinents pour chaque utilisateur. »
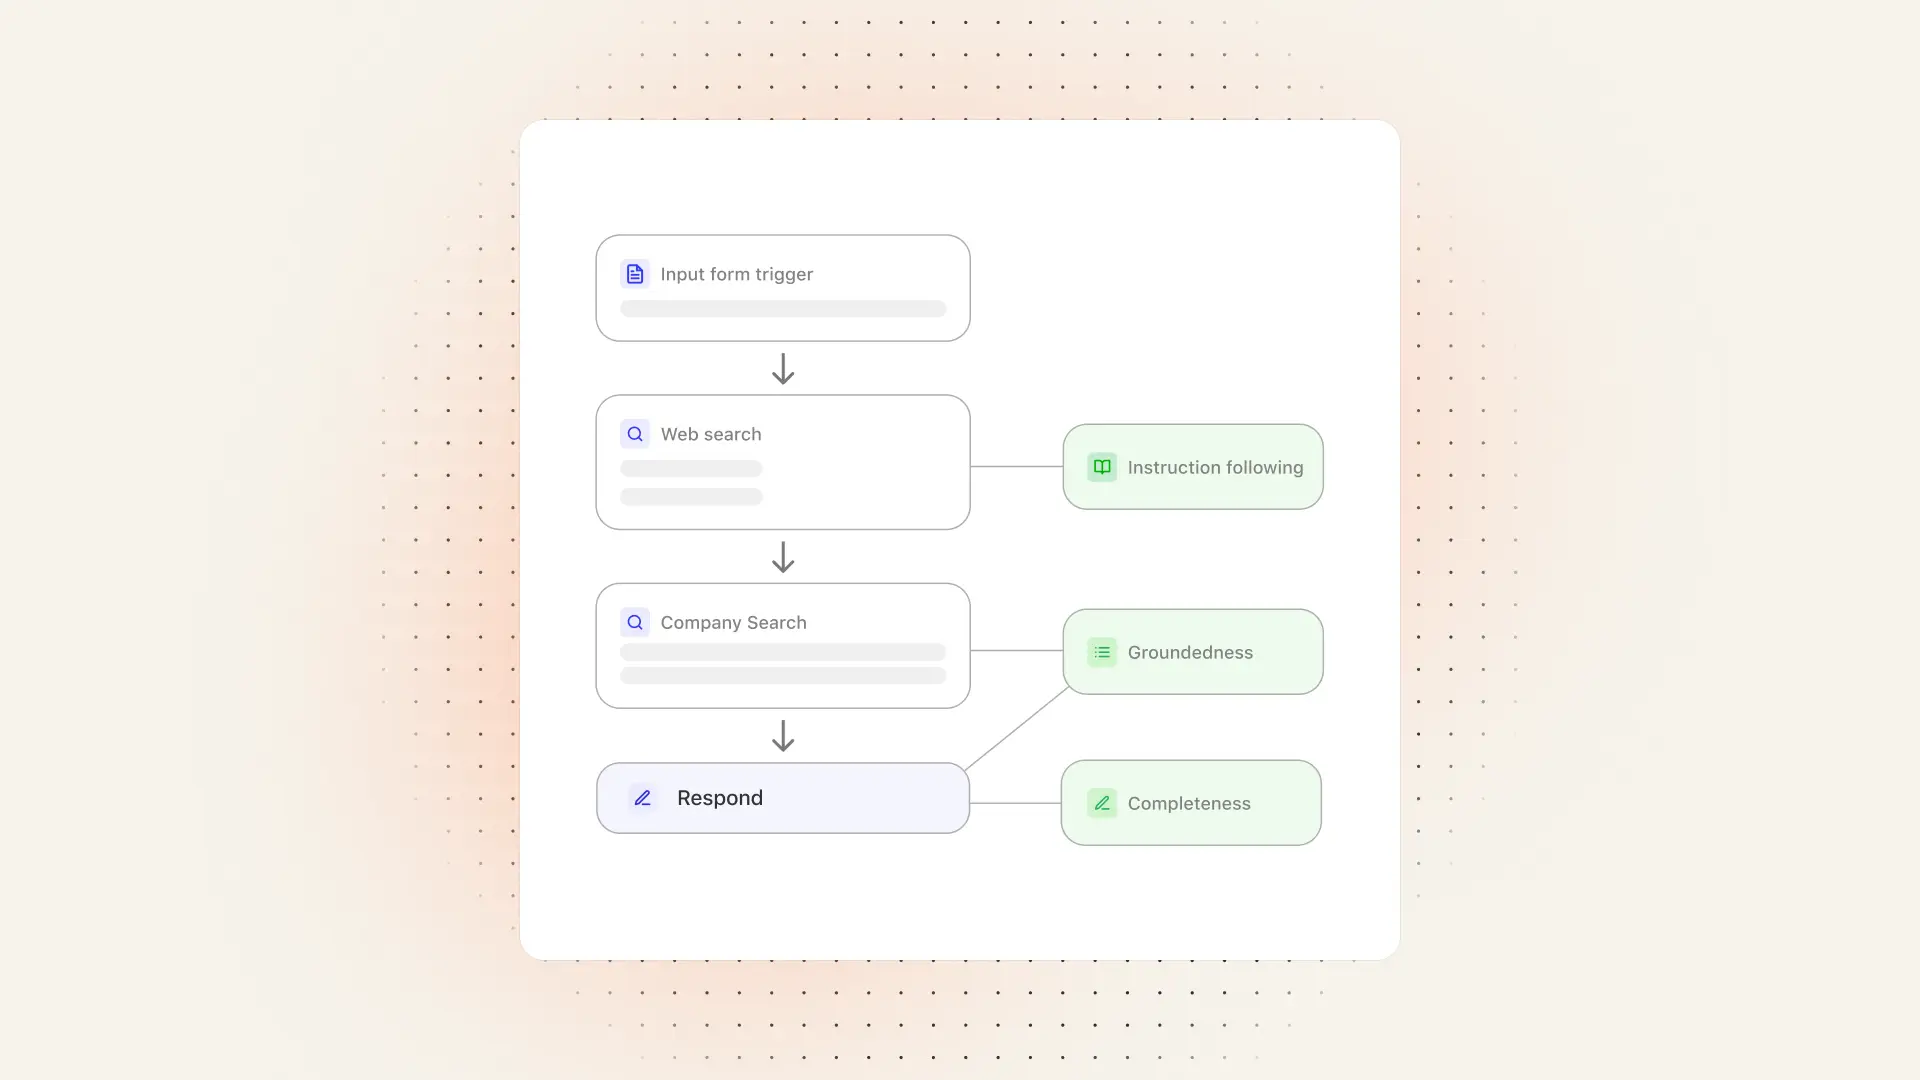
- Ancrage factuel : les affirmations reposent-elles sur des données d'entreprise et publiques exactes ?
En matière de notation des métriques, une simple notation binaire (0 ou 1) fonctionne le mieux. Elle évite la confusion liée aux scores partiels et garde des résultats clairs et cohérents. Différentes personnes jugent souvent un « 3 sur 5 » différemment. Elle rend aussi la notation plus fiable avec les juges LLM, car les modèles de langage ont tendance à avoir du mal avec les échelles nuancées. Les principales exceptions sont des métriques comme le coût ou la latence, où des chiffres précis comptent vraiment.
Des insights à l'action : améliorer votre agent
Une fois votre évaluation lancée, place à la partie la plus importante : utiliser les résultats pour améliorer votre agent. Vous pouvez exploiter cette boucle de rétroaction pour transformer un bon agent en un excellent agent.
Commencez par examiner les métriques pour repérer où l'agent sous-performe, passez en revue les exemples pour identifier des tendances, puis apportez des améliorations ciblées. Par exemple, un agent de prospection commerciale qui échoue sur la personnalisation n'utilise peut-être pas les bonnes sources : reformuler ses instructions de recherche peut donc aider. Si le problème vient du ton, ajoutez des exemples de bon versus mauvais ton. En règle générale, apportez les modifications à l'agent dans cet ordre :
- Affiner les instructions : Les changements les plus impactants proviennent souvent de l'affinement des instructions. Soyez plus précis, ajoutez des exemples de ce qu'il faut faire (et de ce qu'il ne faut pas faire), et fournissez un cadre clair pour structurer le raisonnement et les réponses.
- Structurer le contexte : Contrôlez les informations que l'agent consulte en l'orientant vers des sources de données spécifiques lorsque le contexte général est trop large. Vous pouvez également éviter la surcharge d'informations en utilisant des sous-agents dotés de leur propre mémoire.
- Ajuster les paramètres : Ajustez les paramètres du LLM comme la température, qui contrôle la créativité de l'agent. C'est une excellente façon d'affiner le ton de la sortie.
- Choisir les LLM : Certains modèles excellent vraiment dans certains domaines de tâches et sont à la traîne dans d'autres. Remplacer le LLM par un autre peut apporter un gain significatif.
Trouver la bonne solution devient plus facile avec la pratique. Voici quelques scénarios courants :
- Votre agent d'analyse concurrentielle fournit-il une analyse superficielle ? Essayez d'ajouter une étape qui invite l'agent à exposer son raisonnement avant de donner la réponse finale.
- Votre agent conversationnel répond-il bien, mais trop lentement ? Ajustez les paramètres de mémoire pour qu'il ne lise que les portions pertinentes de l'historique de conversation à chaque cycle de réponse.
- Votre agent de rédaction de contenu semble-t-il rigide et stéréotypé ? Augmentez le paramètre de créativité et donnez-lui quelques extraits pour s'inspirer.
- Votre agent de messagerie commerciale omet-il des histoires clients essentielles ? Ajustez les instructions de ses étapes de recherche pour qu'elles décrivent plus précisément les informations qu'il doit trouver.
Les évaluations à grande échelle : automatisation et bouclage de la boucle de rétroaction
Mettez maintenant votre agent entre les mains de vos utilisateurs. L'usage réel, où des retours comme les votes positifs, les votes négatifs et les partages aident à valider les performances, constitue souvent le test le plus précieux. Vous pouvez même échantillonner des requêtes réelles d'utilisateurs et les ajouter à votre évaluation pour garder votre jeu d'évaluation à jour et aligné sur les besoins changeants des utilisateurs. En complément de l'échantillonnage de requêtes, automatiser la notation à l'aide des LLM est un excellent moyen de faire évoluer vos évaluations à mesure que votre base d'utilisateurs s'agrandit.
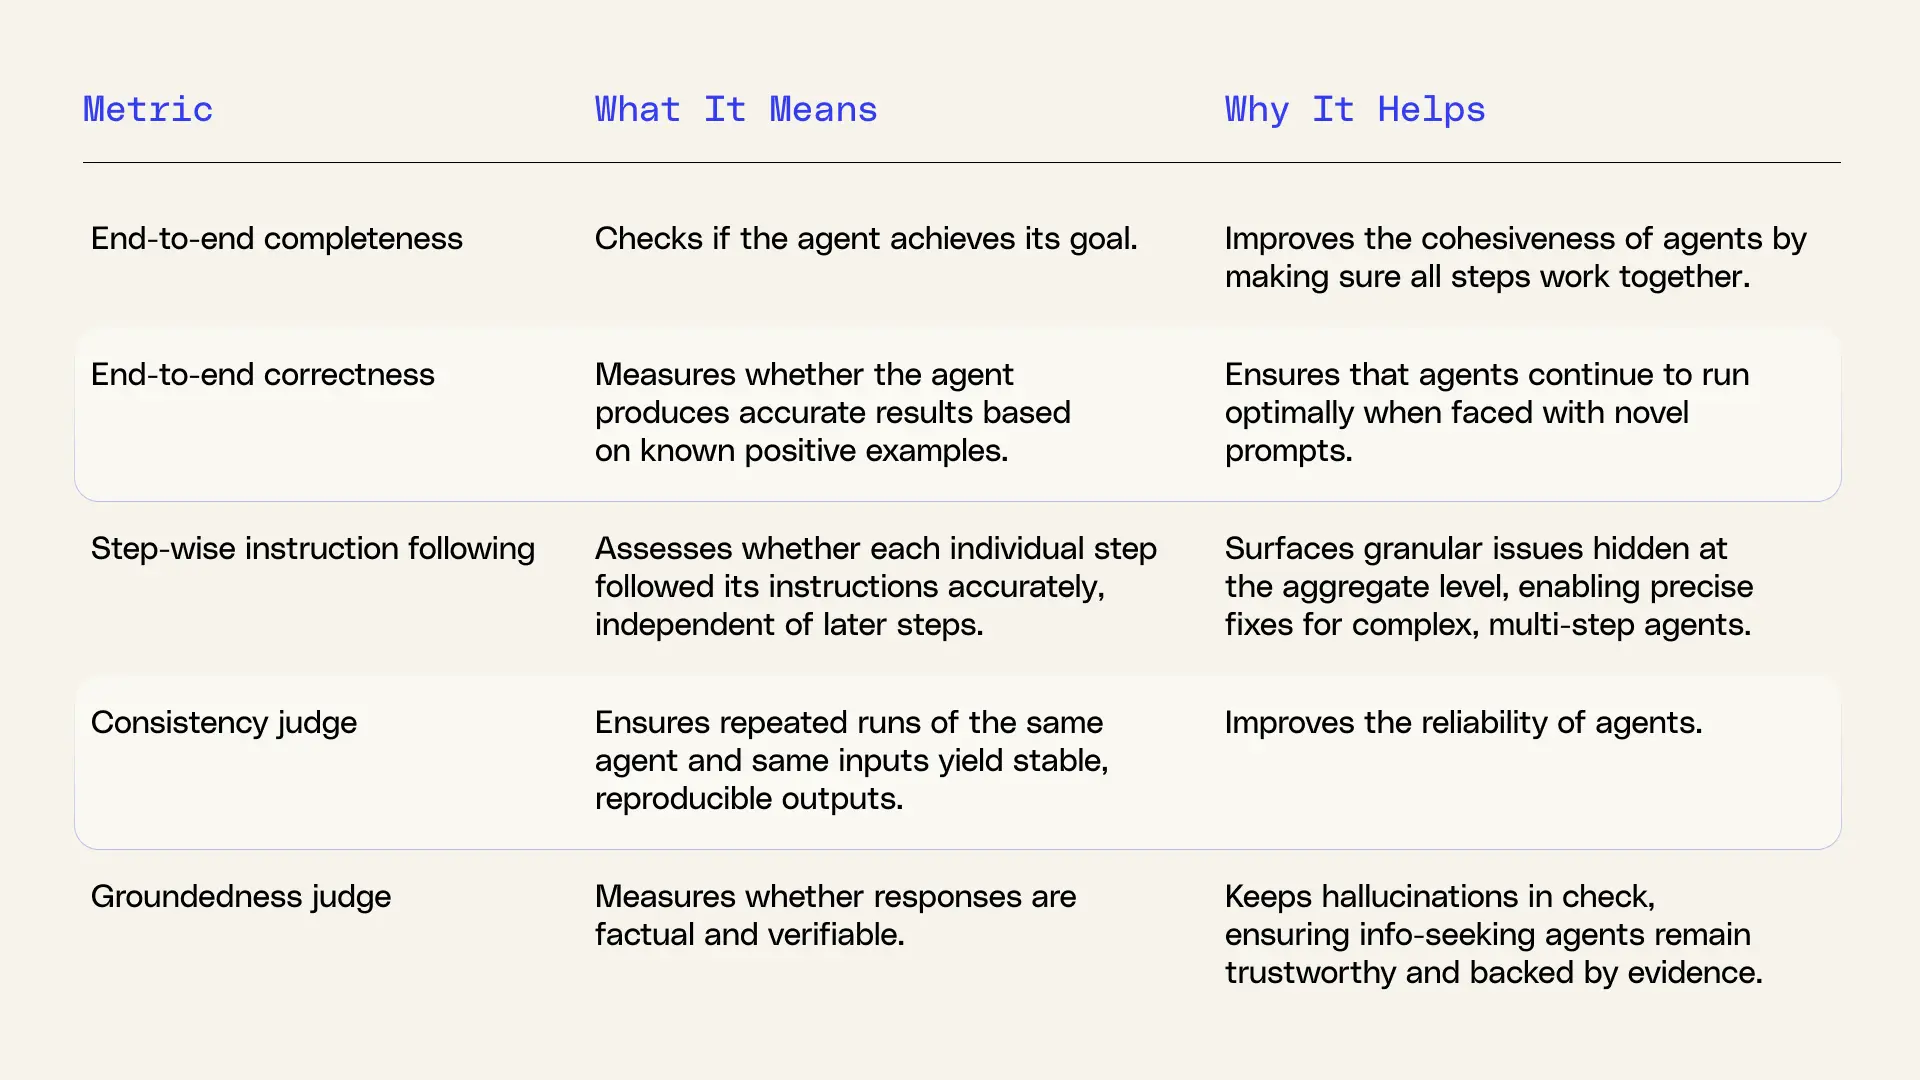
Chez Glean, nous menons des évaluations automatisées à grande échelle pour garantir que les agents, quel que soit le cas d'usage et l'environnement de travail, soient utiles et dignes de confiance. Nous décomposons la qualité de la plateforme en métriques distinctes. La plupart d'entre elles sont notées par des LLM alignés sur les retours des utilisateurs, tels que les votes positifs et négatifs, ainsi que par des experts humains du domaine. En superposant ces métriques pour couvrir tous les aspects de la maturité d'entreprise, Glean offre une plateforme d'agents de confiance pour les cas d'usage transverses.
Commencez à construire en toute confiance
Les évaluations sont le pont entre les agents IA qui font une belle démo et les agents IA qui génèrent un véritable impact. Elles vous aident à affiner les instructions, à préciser la portée et à ajuster vos agents à partir de données utilisateur réelles, et non de simples suppositions.
Pendant que vous évaluez des agents pour vos cas d'usage spécifiques, Glean exécute en continu des évaluations au niveau de la plateforme en arrière-plan, en suivant des métriques comme l'exactitude, la pertinence et le respect des instructions afin de garantir que les agents restent fiables à grande échelle.
Notre objectif chez Glean est de rendre les évaluations accessibles, afin que vous puissiez faire confiance aux performances des agents et partager en toute confiance des agents au sein de votre organisation. C'est maintenant à votre tour. Commencez à créer des agents, commencez à évaluer des agents, et mettez un ensemble d'agents au service de votre équipe.
