






Les agent harnesses sont souvent présentés comme un moyen d'aider les agents à prendre en charge des tâches plus longues et plus complexes. L'agent harness de Glean y parvient de plusieurs façons, principalement grâce à une gestion du contexte qui permet aux agents de raisonner efficacement à travers les outils, les données et les workflows. Le harness prend également en charge le trace learning, aidant les systèmes d'agents à s'auto-améliorer en s'appuyant sur les sessions passées. Le routage permet aux modèles spécialisés de prendre en charge les tâches qu'ils sont les mieux à même de gérer, afin que les agents obtiennent des résultats de haute qualité à moindre coût.
Mais la conception d'un harness ne consiste pas seulement à rendre les agents plus performants. Elle est aussi essentielle à l'efficacité en matière de tokens. Dans cet article, nous expliquons comment nous avons fait évoluer notre harness afin d'orchestrer les outils pour chaque requête à l'aide de code, et comment cette approche s'est révélée plus efficace, même pour les requêtes simples. Comparée à notre approche précédente, elle a réduit l'utilisation de tokens de 24 %. Nous examinerons également les décisions de conception clés qui ont rendu ces résultats possibles.
Les agent harnesses passent mieux à l'échelle avec un appel d'outils 100 % programmatique
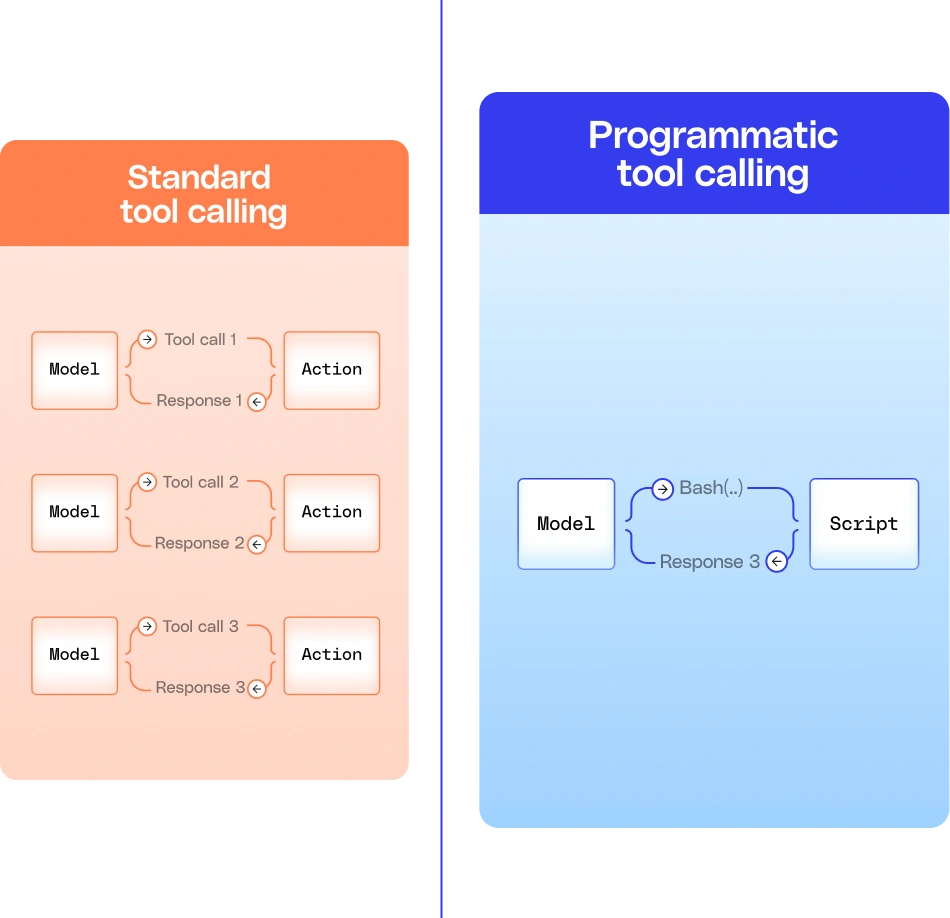
La caractéristique déterminante de l'agent harness de Glean est l'appel d'outils 100 % programmatique. Au lieu d'émettre directement des appels d'outils standards, le modèle écrit du code dans le sandbox de l'agent, en appelant les capacités de Glean via le runtime Python et le SDK d'outils. Le code constitue une meilleure primitive d'exécution que les appels d'outils standards, car l'orchestration, le filtrage, les boucles et les branchements peuvent tous se produire au sein d'une seule exécution de script, plutôt que d'être dispersés sur plusieurs allers-retours avec le LLM.
Dans une boucle d'appel d'outils standard, chaque entrée et sortie d'outil est sérialisée puis désérialisée pour revenir dans la fenêtre de contexte. Le modèle appelle un outil, le résultat arrive dans le contexte, le modèle le lit et appelle l'outil suivant. Pour un workflow mobilisant des dizaines de documents à travers plusieurs systèmes, ce schéma ajoute du gaspillage de tokens, de la latence et une surcharge de raisonnement qui n'a rien à voir avec la logique réelle de la tâche.
Notre première tentative d'appel d'outils programmatique reposait sur une approche hybride. L'appel d'outils standard gérait les opérations simples et à étape unique, tandis que l'appel d'outils programmatique prenait en charge les tâches multi-outils. Mais exiger du modèle qu'il décide à chaque tour quel mode utiliser introduisait sa propre surcharge, qui grignotait les gains d'efficacité que nous cherchions à obtenir. Il s'avère que les modèles sont tout aussi bons pour écrire un court script pour un appel d'outil unique que pour effectuer un appel d'outil standard.
Nous avons donc supprimé entièrement l'appel d'outils standard. Le shell est désormais le seul outil exposé directement au modèle, ce qui permet à l'agent d'écrire et d'exécuter des scripts dans le sandbox pour tout ce qu'il a besoin d'appeler. Toutes les autres capacités, y compris la recherche, les outils d'écriture et les compétences, sont exposées via le SDK d'outils de Glean.
La troncature des outils relie le contexte au système de fichiers du sandbox
Un harness de codage comme celui-ci a besoin d'un système de fichiers de sandbox pour conserver les sorties d'outils, les étapes intermédiaires, les données et le raisonnement. Cette sortie reste sur le disque entre les tours au lieu d'inonder le contexte du modèle, qui est réservé à un raisonnement à fort signal, aux décisions et aux résultats d'outils tronqués. En ne conservant que les parties les plus informatives d'un workflow dans la fenêtre de contexte, le harness évite la dégradation du contexte et reste fiable tout au long des tâches de longue durée qui nécessitent un raisonnement complexe sur de grandes quantités de données.
Chaque harness doit décider de la quantité de la sortie d'un outil que le modèle voit réellement. Si tout reste dans le contexte, les performances se dégradent à mesure que le contexte s'accumule et que le modèle perd en attention. Si tout est résumé, le modèle peut perdre des informations clés dont il a besoin. Un excès de résumé a aussi un coût caché : comme le modèle ne connaît pas à l'avance la structure de la sortie d'un outil donné, il peut consommer des tokens simplement pour comprendre comment lire les données depuis le système de fichiers.
Dans le harness de codage de Glean, chaque appel d'outil renvoie un aperçu tronqué, écrit la sortie complète dans un fichier et indique au modèle exactement quelle quantité de contenu se trouve sur le disque. Le modèle lit directement le fichier lorsqu'il a besoin de plus de détails, et évite ce coût lorsqu'il n'en a pas besoin. Cela fonctionne parce qu'une fois que le modèle voit la structure d'un résultat et quelques lignes ou entrées représentatives, il peut en déduire le reste sans avoir besoin de la charge utile complète dans le contexte. Le modèle a seulement besoin de savoir où se trouve la sortie utile et comment l'obtenir.
La recherche et la divulgation progressive gardent le contexte allégé
Le harness de codage peut exécuter des workflows complexes avec des outils à grande échelle, mais précharger des centaines de compétences et d'outils d'entreprise dans la fenêtre de contexte dilue l'attention, réduit la fiabilité et gonfle les coûts. Nous avons donc construit le harness sur une combinaison de recherche et de divulgation progressive à la place.
Le harness démarre avec un ensemble minimal d'outils de base dans les instructions système. Cela inclut seulement deux outils de recherche : un pour le contexte d'entreprise et un pour les outils et compétences. Ces outils de base permettent à l'agent de trouver toutes les autres ressources dont il a besoin. Lorsque l'agent trouve un outil ou une compétence via la recherche, il n'en voit pas immédiatement l'intégralité du contenu. Il voit seulement un nom et une description légers, puis ne lit le schéma complet ou l'ensemble complet des références que lorsque la tâche le requiert réellement, grâce à la divulgation progressive.
La recherche et la divulgation progressive sont toutes deux nécessaires car elles résolvent des problèmes différents. La divulgation progressive permet à un agent d'utiliser efficacement une ressource complexe en ne lisant que les parties d'une compétence ou d'un schéma pertinentes pour la tâche en cours, plutôt que de se laisser distraire par le reste. Mais la divulgation progressive n'est utile qu'une fois que l'agent sait quelle ressource utiliser. La recherche oriente l'agent vers le bon outil ou la bonne compétence, de sorte que lorsqu'il approfondit, il peut être sûr de regarder au bon endroit.
Repenser l'architecture du harness autour d'un ensemble de base d'outils de recherche a introduit ses propres défis. Chaque recherche fait apparaître de nouveaux outils et compétences que le modèle doit prendre en compte, ce qui signifie que l'ensemble d'instructions sur lequel le modèle raisonne peut croître à chaque tour. Si ce contexte était inséré dans les tours antérieurs, il invaliderait le cache de préfixe, la partie initiale d'une conversation dont les LLM peuvent réutiliser les états d'attention au lieu de les recalculer. Pour éviter cela, Glean ajoute les résultats de recherche à la fin de la conversation. Cela permet au modèle d'agir sur les outils et compétences nouvellement apparus sans invalider le cache de préfixe, rendant les réponses plus rapides et plus rentables.
Pourquoi les harnesses de codage conviennent aux tâches d'entreprise de longue durée
Le passage à un harnais de code reflète une évolution plus large de l'IA d'entreprise. Le travail implique de plus en plus l'orchestration et l'automatisation à travers des dizaines de systèmes SaaS, et non plus seulement une conversation textuelle. Les workflows inter-systèmes exigent une logique précise et une gestion des états, et le code répond à ces exigences plus directement que les appels d'outils fondés sur le langage naturel.
Les harnais de code deviennent également l'option la plus efficace et indépendante des modèles pour l'exécution agentique. Les modèles de pointe de tous les grands laboratoires excellent déjà dans le codage agentique, et les modèles ouverts rattrapent rapidement leur retard. Comme une large gamme de modèles peut piloter le harnais de Glean, les progrès des capacités de codage des LLM se traduisent directement par une meilleure exécution des agents, sans nécessiter de refonte. Les créateurs d'agents peuvent remplacer les modèles librement à mesure que leurs besoins et exigences évoluent.
Un harnais de code ne se contente pas de permettre aux agents d'appeler davantage d'outils. Il leur permet d'utiliser les outils, le contexte et les compétences avec une efficacité et une fiabilité bien supérieures, même à l'échelle des plus de 1 000 outils nécessaires pour automatiser une entreprise entière. Associé à un ensemble d'outils de recherche de haute précision, le harnais de code de Glean devient la base d'agents de travail puissants qui réalisent des workflows d'entreprise avancés avec 24 % de tokens en moins.
