






Les agents d'IA d'aujourd'hui sont puissants, et pourtant ils abordent chaque tâche comme une page blanche. Chaque exécution est en réalité sans état, si bien que le système répète souvent la même exploration, essaie les outils dans des ordres différents, oublie parfois des étapes clés ou rencontre des modes d'échec prévisibles. Cela ressemble beaucoup à un nouvel employé qui apprend un processus pour la première fois. Même lorsque l'agent finit par réussir, le chemin qu'il a emprunté et les erreurs commises en cours de route ne sont pas conservés, de sorte que la prochaine tâche similaire repart de zéro.
Pour tenir leurs promesses, les agents doivent apprendre davantage comme le font les humains. Ils doivent être exposés à des tâches réelles, apprendre de chaque succès et de chaque échec, et transmettre ce contexte durement acquis.
C'est là que les traces deviennent essentielles. Une trace est un enregistrement de la manière dont une tâche a réellement été exécutée, incluant les outils utilisés, dans quel ordre, avec quels paramètres, et quel en a été le résultat.
Dans les environnements d'entreprise, les traces sont particulièrement précieuses car la partie la plus difficile du problème n'est pas l'utilisation des outils, mais la compréhension des workflows : quels systèmes font réellement autorité, comment plusieurs outils sont combinés au fil des étapes, les conventions et le séquencement implicites, et quels schémas n'apparaissent que dans un usage réel.
Ces schémas ne se trouvent pas dans les données d'entraînement des modèles. Ils n'émergent qu'à travers l'exécution.
Le trace learning transforme ces exécutions en une boucle de rétroaction. Au lieu de mémoriser des trajectoires entières, le système en extrait les parties utiles : quelle stratégie a fonctionné, qu'est-ce qui a échoué, et ce qu'il faudrait faire différemment la prochaine fois. Au fil du temps, cela permet à l'agent de :
- éviter de répéter des schémas d'échec connus
- réutiliser des séquences d'outils et des choix de paramètres efficaces
- s'adapter aux workflows spécifiques à l'environnement
- améliorer ses performances sans fine-tuning ni jeux d'instructions volumineux
C'est pourquoi les traces ne sont pas seulement utiles pour l'observabilité. Lorsque les agents apprennent à partir d'elles, ils peuvent passer de l'exécution ponctuelle de tâches à la construction d'une véritable expertise spécifique à l'environnement.
Dans ce blog, nous partagerons l'approche de Glean en matière de trace learning, notamment la façon dont nous concevons pour l'exactitude, nous concentrons sur les stratégies d'outils au niveau des workflows, et ancrons tout dans les permissions et la gouvernance.
Comment le trace learning améliore les performances des tâches
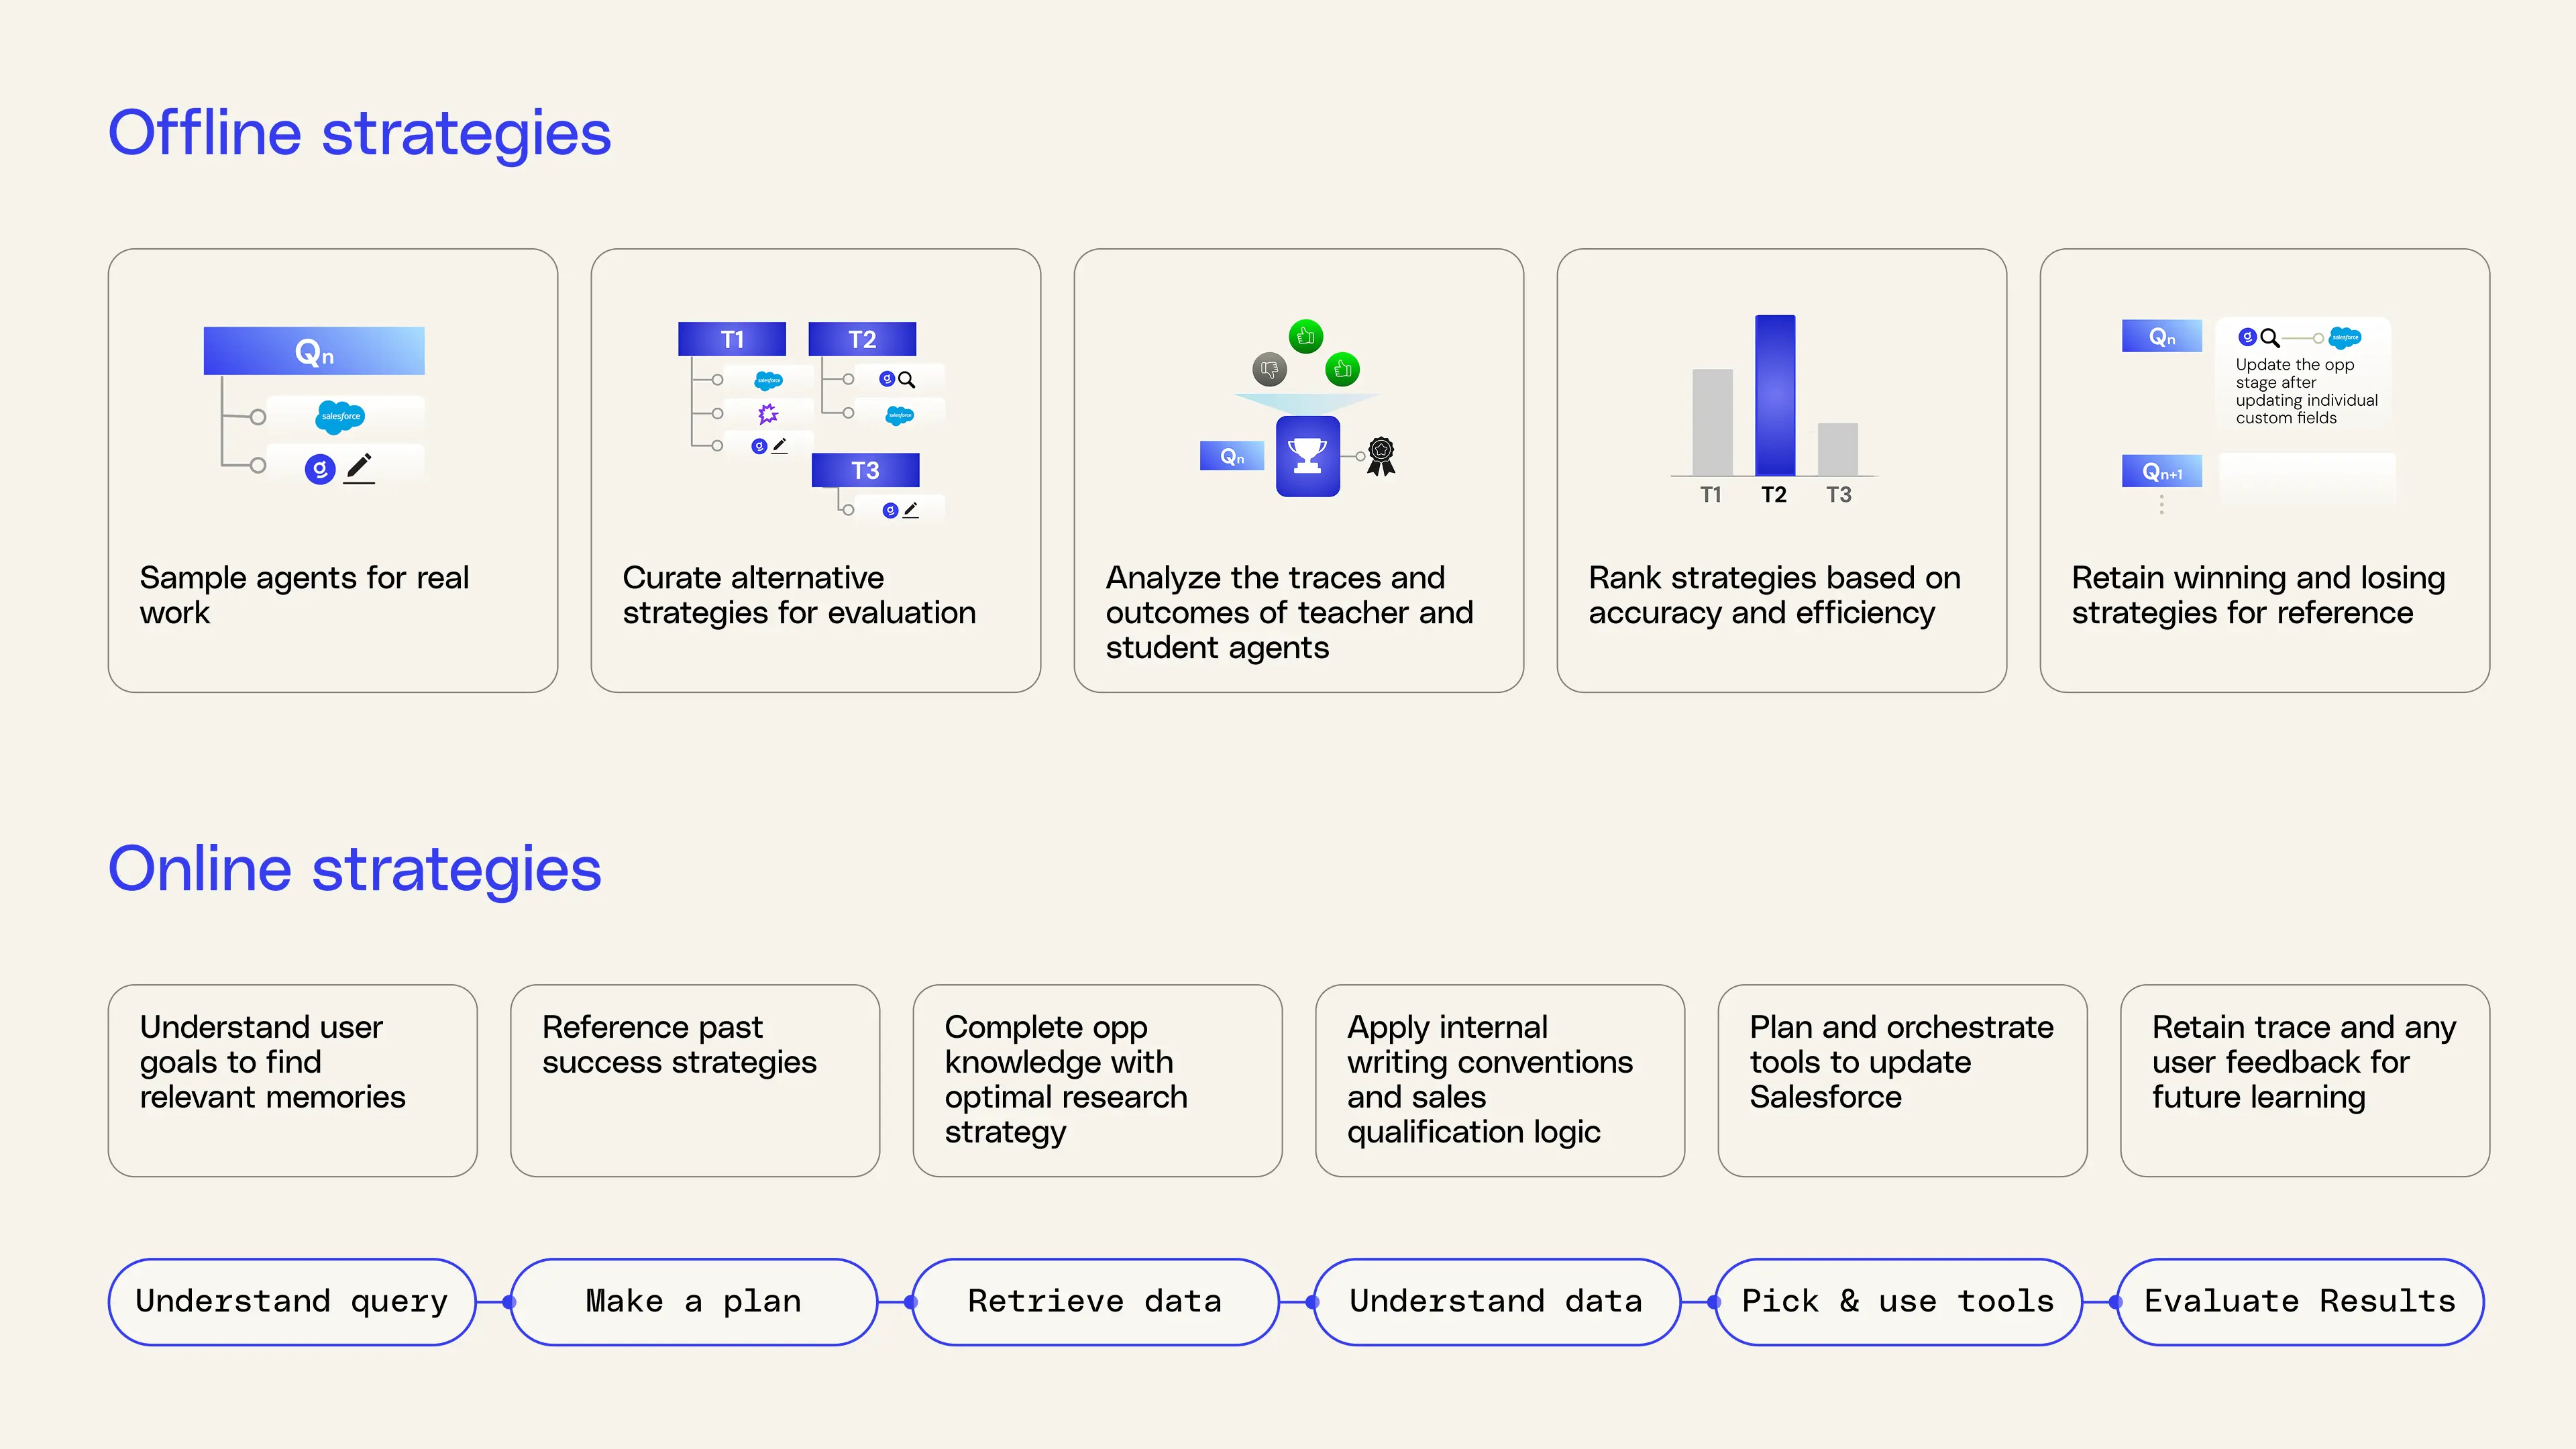
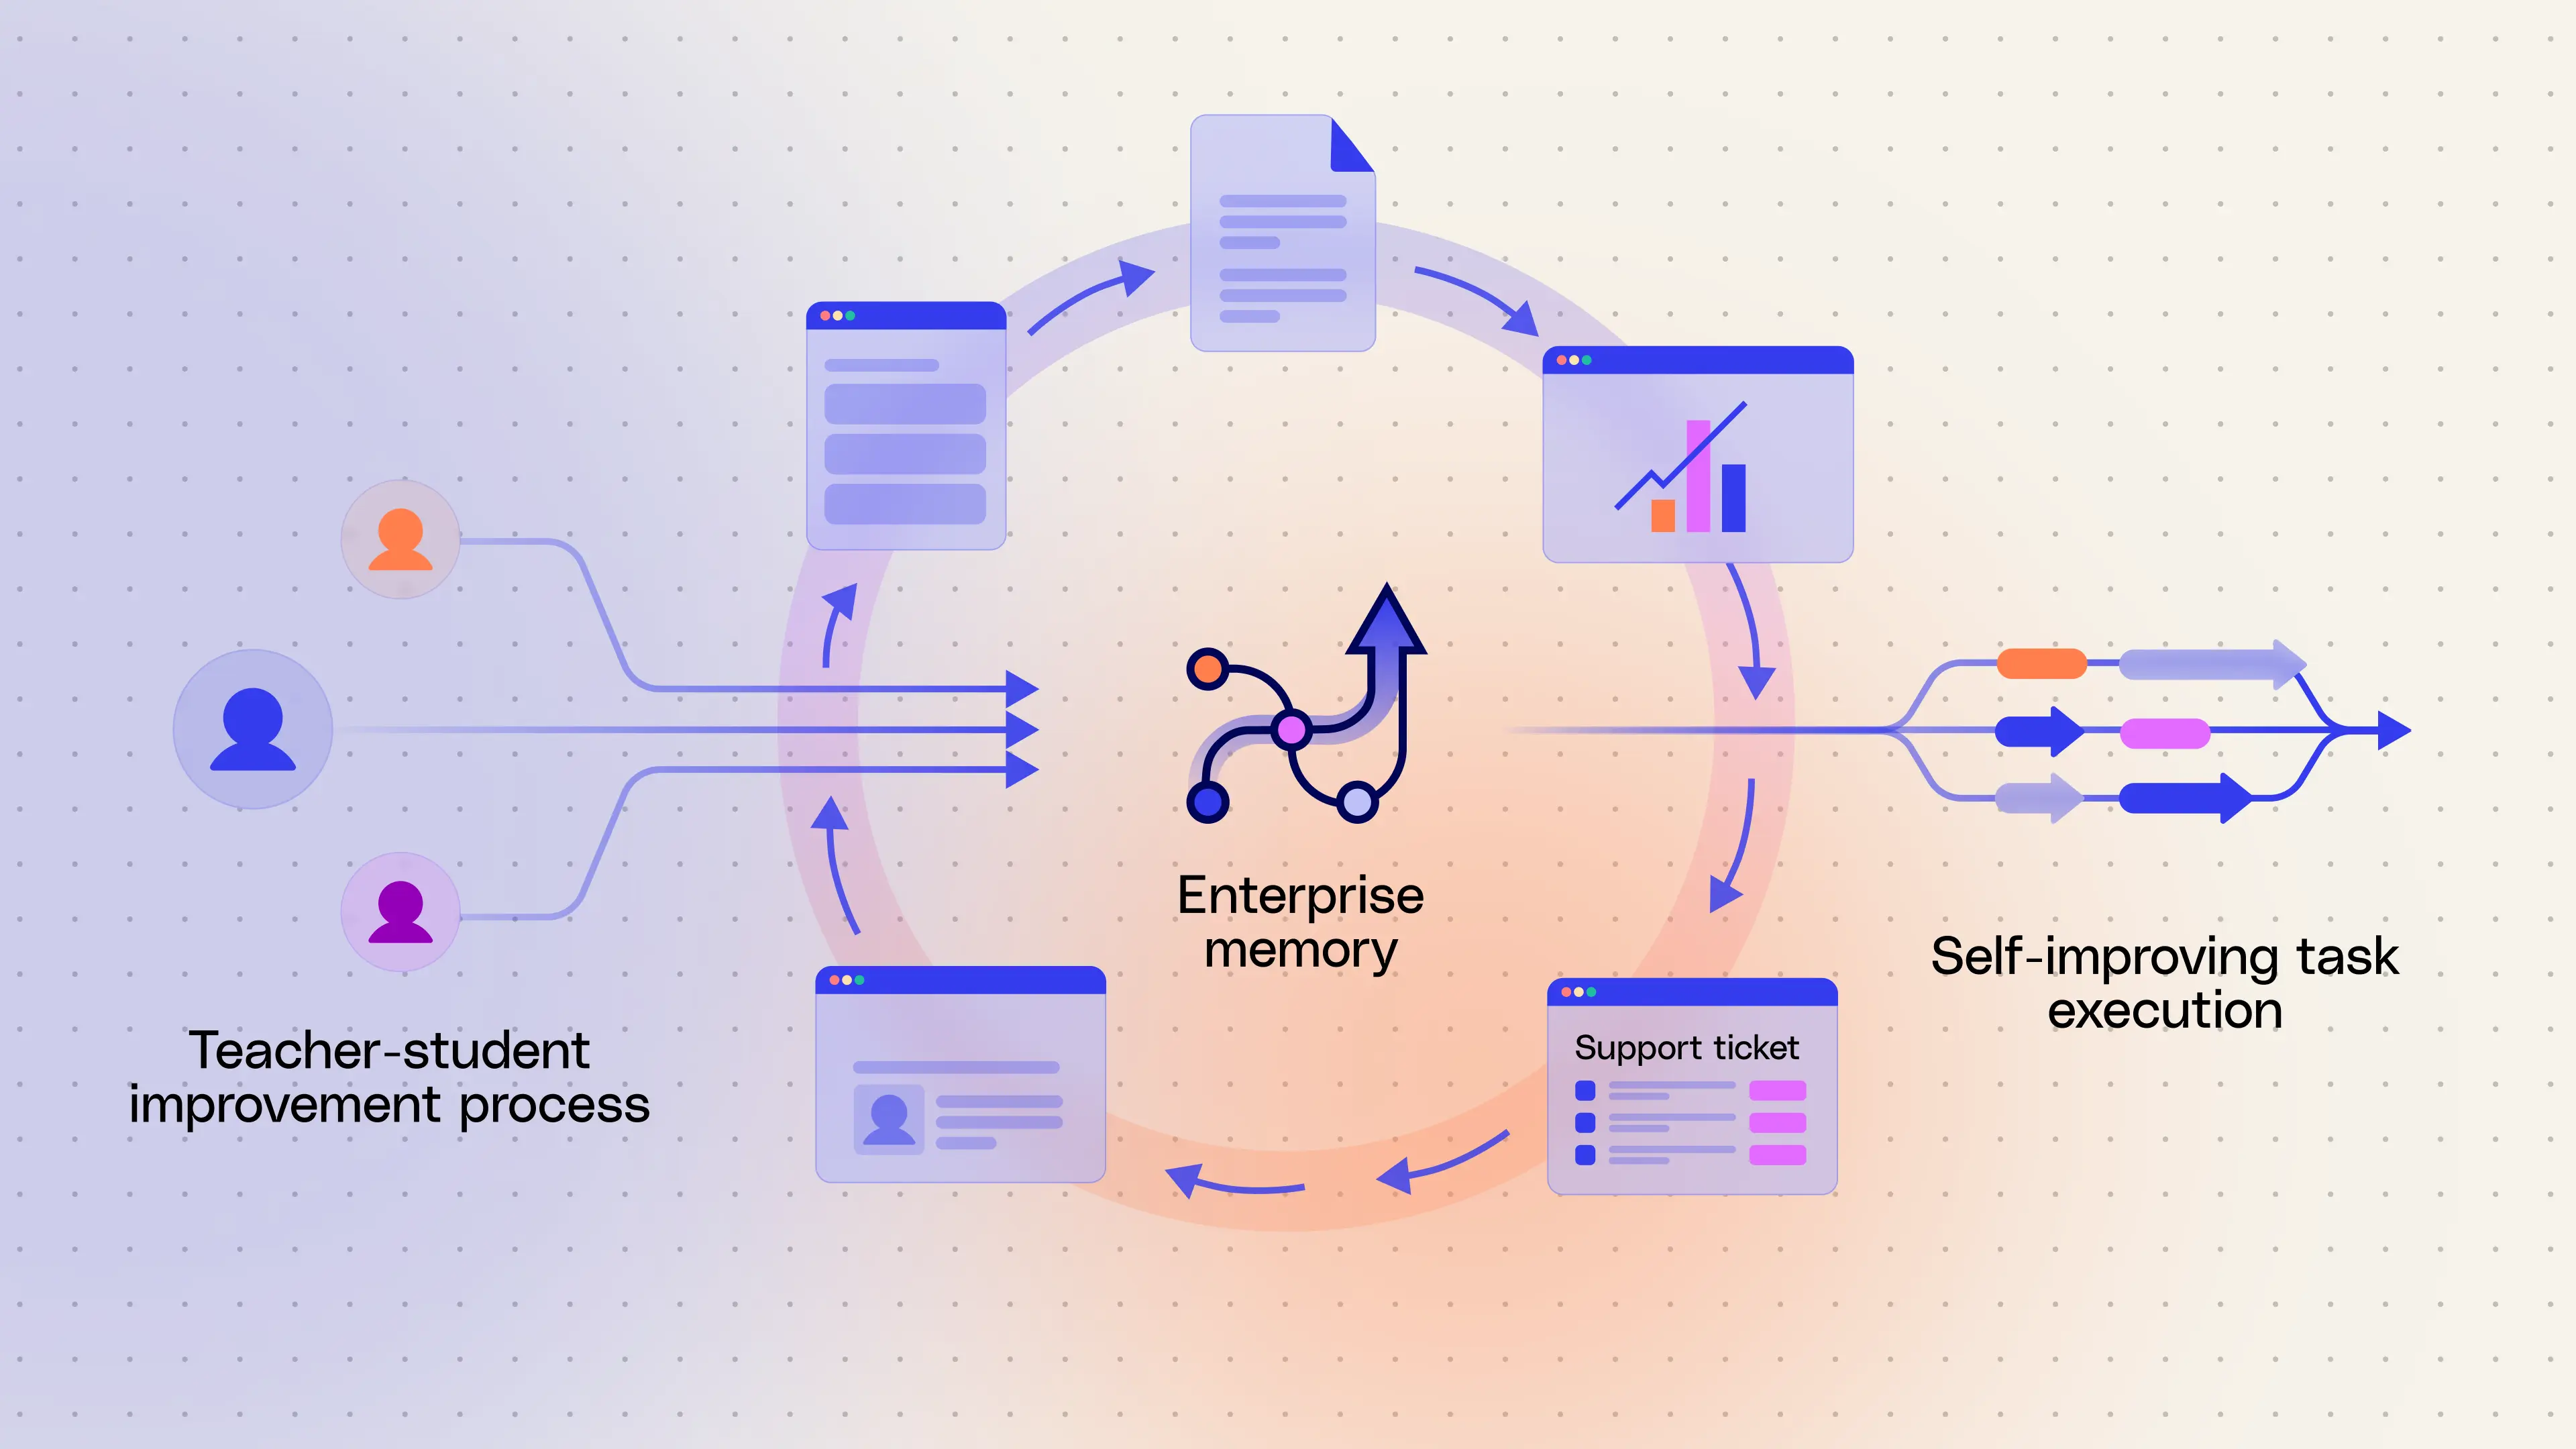
À un niveau général, le trace learning comporte deux composantes :
- L'apprentissage hors ligne, qui extrait des stratégies à partir de traces historiques.
- L'application en ligne, qui récupère et applique ces stratégies au moment de l'exécution.
Vous pouvez le concevoir comme une boucle où chaque tâche renforce les agents.
Apprentissage hors ligne : explorer des alternatives en toute sécurité
Pendant l'apprentissage hors ligne, Glean échantillonne des traces réelles basées sur des tâches agentiques issues de votre déploiement. Il apprend ensuite de ces traces en :
- Exécutant un agent « enseignant » performant doté d'un budget de raisonnement élevé et d'un large accès aux outils, afin de servir de référence de haute qualité sur ce à quoi ressemble une « bonne » exécution d'une tâche.
- Comparant plusieurs traces d'agents « élèves » qui opèrent sous de véritables contraintes de production, notamment des budgets plus serrés, des jeux d'outils plus stricts et des limites de latence, afin de comprendre comment l'agent se comporte dans des conditions réelles.
- Notant chaque stratégie. La combinaison de plusieurs élèves et d'un enseignant crée une base de référence pour évaluer quelles stratégies sont plus ou moins performantes. Nous sélectionnons les stratégies qui se démarquent de leur groupe en fonction de l'exactitude, du comportement d'appel des outils, de l'efficacité d'exécution et de l'alignement avec les retours des utilisateurs.
- Distillant les meilleures stratégies issues des élèves les plus performants en mémoires compactes en langage naturel qui guideront les futures exécutions de l'agent.
Application en ligne : appliquer les bonnes mémoires au moment de l'exécution
Lorsqu'une personne soumet une requête à Glean, celui-ci :
- Comprend l'objectif
- Récupère les mémoires pertinentes en fonction du schéma de la tâche
- Adapte le plan de l'agent à l'aide de ces mémoires avant l'exécution
- Exécute le plan en utilisant ces mêmes mémoires dans le contexte
Par exemple, pour une requête comme « Mettre à jour toutes mes opportunités Salesforce ouvertes », Glean peut utiliser des mémoires telles que :
- Ne pas modifier StageName si un champ MEDDICC est vide ou ne contient qu'un texte générique comme « TBD » ou « Follow up next week ».
- Lorsque les champs MEDDIC sont mis à jour, privilégier la mise à jour de ces champs dans une écriture distincte avant de modifier StageName.
- Pour les champs narratifs à texte long tels que Customer_Narrative__c, ajouter une nouvelle section datée au lieu d'écraser le contenu existant.
- Lors du changement d'étape d'une opportunité Salesforce, utiliser d'abord l'outil « Update Salesforce opportunity » pour renseigner chaque champ clé, y compris Amount, CloseDate, ForecastCategory, MEDDIC, Next Step, si ce champ est vide ou date de plus de 14 jours.
- Lors de la recherche de moins de 10 opportunités, utiliser la recherche Glean avec le filtre d'application Salesforce et le filtre de type de document « Opportunity » plutôt que l'outil de recherche Salesforce Object Query Language (SOQL).
- Lors de la recherche d'un grand nombre d'opportunités à des fins d'analyse, utiliser la recherche SOQL en sélectionnant au minimum les champs personnalisés `ARR__c`, `TechStack__c`, `Partner__c` et `SeatCount__c`, ainsi que les champs d'opportunité standard.
Ces mémoires ont été apprises à partir de schémas de réussite et de modes d'échec rencontrés durant la phase hors ligne du trace learning dans le propre déploiement de Glean.
Travaux récents en trace learning
Les travaux récents sur le trace learning convergent vers une idée commune : les agents s'améliorent lorsqu'ils peuvent conserver et réutiliser une expérience structurée issue de tâches réelles. Au lieu de se reposer uniquement sur un entraînement statique, ces approches considèrent les exécutions passées comme une source d'apprentissage, permettant aux agents de s'adapter à des environnements complexes, évolutifs et fortement dépendants du contexte.
Dynamic Cheatsheet est l'une des premières formulations de cette idée. Elle présente la mémoire comme une couche adaptative, auto-organisée, où l'agent décide de ce qu'il convient de conserver ou d'écarter en fonction de son utilité. L'idée clé est qu'une mémoire efficace doit être à la fois suffisamment spécifique pour être exploitable et suffisamment abstraite pour se généraliser. Plutôt que de stocker des trajectoires complètes, le système distille les traces en conseils concis en langage naturel qui capturent ce qui comptait, d'une manière transférable à des tâches similaires. Cela fait de la mémoire bien plus qu'un simple enregistrement du passé, mais quelque chose qui peut guider de façon fiable les comportements futurs.
Agentic Context Engineering (ACE) s'appuie sur cette idée en passant à des playbooks structurés. ACE agrège des schémas issus de nombreuses traces pour en faire des stratégies réutilisables qui encodent quand une stratégie s'applique, comment séquencer les étapes, quels outils prioriser et comment gérer les modes de défaillance courants. Cela fait passer le système de la mémorisation de ce qui s'est passé à l'apprentissage de ce qui devrait être fait.
ReasoningBank utilise l'apprentissage contrastif pour améliorer ces stratégies. Au lieu de simplement renforcer les traces réussies, il compare explicitement les exécutions réussies et les exécutions échouées afin de comprendre où le comportement a divergé. En analysant ce qui a changé entre un échec et un succès, comme le choix de l'outil, l'ordre ou le raisonnement intermédiaire, le système peut isoler les décisions qui ont réellement compté.
L'apprentissage par traces de Glean s'appuie sur ces idées mais les adapte aux environnements d'entreprise. Au lieu de se fier uniquement aux résultats d'une seule trace enseignante, Glean agrège des signaux issus de nombreuses exécutions et applique une validation plus stricte avant d'apprendre. Cela rend les recommandations apprises plus précises, tout en leur permettant de se généraliser à des tâches similaires au sein du déploiement d'un client.
Comment nous avons conçu l'apprentissage par traces pour l'entreprise
L'apprentissage par traces est autant un problème de précision qu'un problème d'apprentissage
Construire une mémoire d'entreprise relevait autant d'un problème de conception autour de la précision que d'un problème d'apprentissage. Pour l'IA d'entreprise, la bonne réponse n'est généralement pas disponible dans les données publiques, et les résultats des agents ne sont pas toujours directement vérifiables.
Nous avons constaté qu'une seule trace enseignante, même avec l'effort de raisonnement le plus élevé, n'était pas suffisamment fiable à elle seule. Nous sommes donc passés à une configuration plus stricte : extraire des assertions à partir des réponses, vérifier leur concordance, résoudre les conflits à l'aide de Glean Search, et renoncer entièrement à apprendre lorsque les incohérences ne peuvent être résolues.
Dans l'apprentissage hors ligne, nous exécutons une trace enseignante à fort raisonnement et la comparons à plusieurs exécutions alternatives. Pour déterminer ce que le système devrait réellement apprendre, nous extrayons des affirmations factuelles de plusieurs réponses, vérifions leur concordance, et ne conservons une réponse canonique que lorsque les résultats sont cohérents ou peuvent être vérifiés à l'aide d'outils supplémentaires. Si l'incohérence ne peut être résolue, nous ne générons aucun apprentissage. Cette approche est plus prudente et plus sélective quant à ce dont elle apprend, comparée aux systèmes qui se contentent de faire confiance à leurs propres résultats ou de réutiliser telles quelles les exécutions passées.
Parce que la précision compte, Glean est délibéré dans le choix de ce dont il apprend. Le flux actuel d'apprentissage par traces sélectionne des requêtes de haute qualité et représentatives, susceptibles de se reproduire, et il utilise plusieurs classificateurs ainsi que des vérifications d'intention à forte confiance plutôt que de tenter d'apprendre de chaque requête possible. Cela permet aux stratégies résultantes de rester plus réduites, plus propres et plus fiables en tant que recommandations à l'exécution.
Tout comme avec l'approche de ReasoningBank, nous apprenons aussi à partir des succès et des échecs, et pas seulement des exécutions qui se sont bien terminées. L'objectif est d'exposer le modèle à des traces diverses afin qu'il puisse comprendre plusieurs chemins vers une solution, voir où l'exécution échoue, et en tirer des leçons plus utiles qu'un unique chemin optimal ne pourrait en offrir. Nous veillons à ce qu'au fil du temps l'agent devienne de plus en plus précis dans la manière dont il aborde les tâches.
Stocker des stratégies d'outils volontairement restreintes qui se généralisent à des tâches connexes
Lors de la conception de l'apprentissage par traces, nous avons pris la décision consciente de stocker des apprentissages volontairement restreints. L'objectif était de capturer des recommandations du type « dans cette situation, privilégiez cette stratégie » plutôt que de prescrire des séquences exactes ou d'abstraire de manière trop large, afin que les apprentissages restent exploitables tout en se généralisant à des tâches connexes.
Dans un environnement comptant des centaines de connecteurs et d'actions, le défi n'est pas seulement de trouver le bon outil, mais de savoir comment utiliser efficacement les outils ensemble. Les agents doivent dépasser les actions individuelles et apprendre des schémas d'exécution réutilisables, par exemple quand paralléliser plutôt que séquencer les appels d'outils, quand un système fait autorité pour l'analytique plutôt que pour le détail au niveau des enregistrements, et quand plusieurs outils devraient être combinés en un seul flux de travail. Cela importe encore davantage dans les environnements d'entreprise, où la difficulté n'est pas la disponibilité des outils, mais la compréhension de la manière dont le travail s'accomplit réellement au sein d'une organisation spécifique.
En d'autres termes, l'apprentissage par traces déplace l'attention de « quel outil appeler » vers « comment accomplir une tâche à travers plusieurs outils ».
La capture de ces schémas au niveau des flux de travail présente un autre avantage important. Elle réduit l'espace d'action à l'exécution en regroupant les outils en primitives de plus haut niveau, tout en fournissant des recommandations pratiques sur la manière dont ces outils devraient être utilisés ensemble. Au lieu de naviguer isolément entre des dizaines d'outils, les agents peuvent opérer au niveau de flux de travail porteurs de sens, comme « mettre à jour les notes de version », adaptés à la manière dont cette tâche est réellement réalisée au sein d'une entreprise donnée.
Ces avantages de l'apprentissage par traces s'étendent aux outils basés sur MCP, où un contexte et des instructions limités rendent l'apprentissage à partir des traces d'exécution encore plus précieux.
Diviser les apprentissages en niveaux de déploiement et d'utilisateur pour capturer en toute sécurité les préférences individuelles
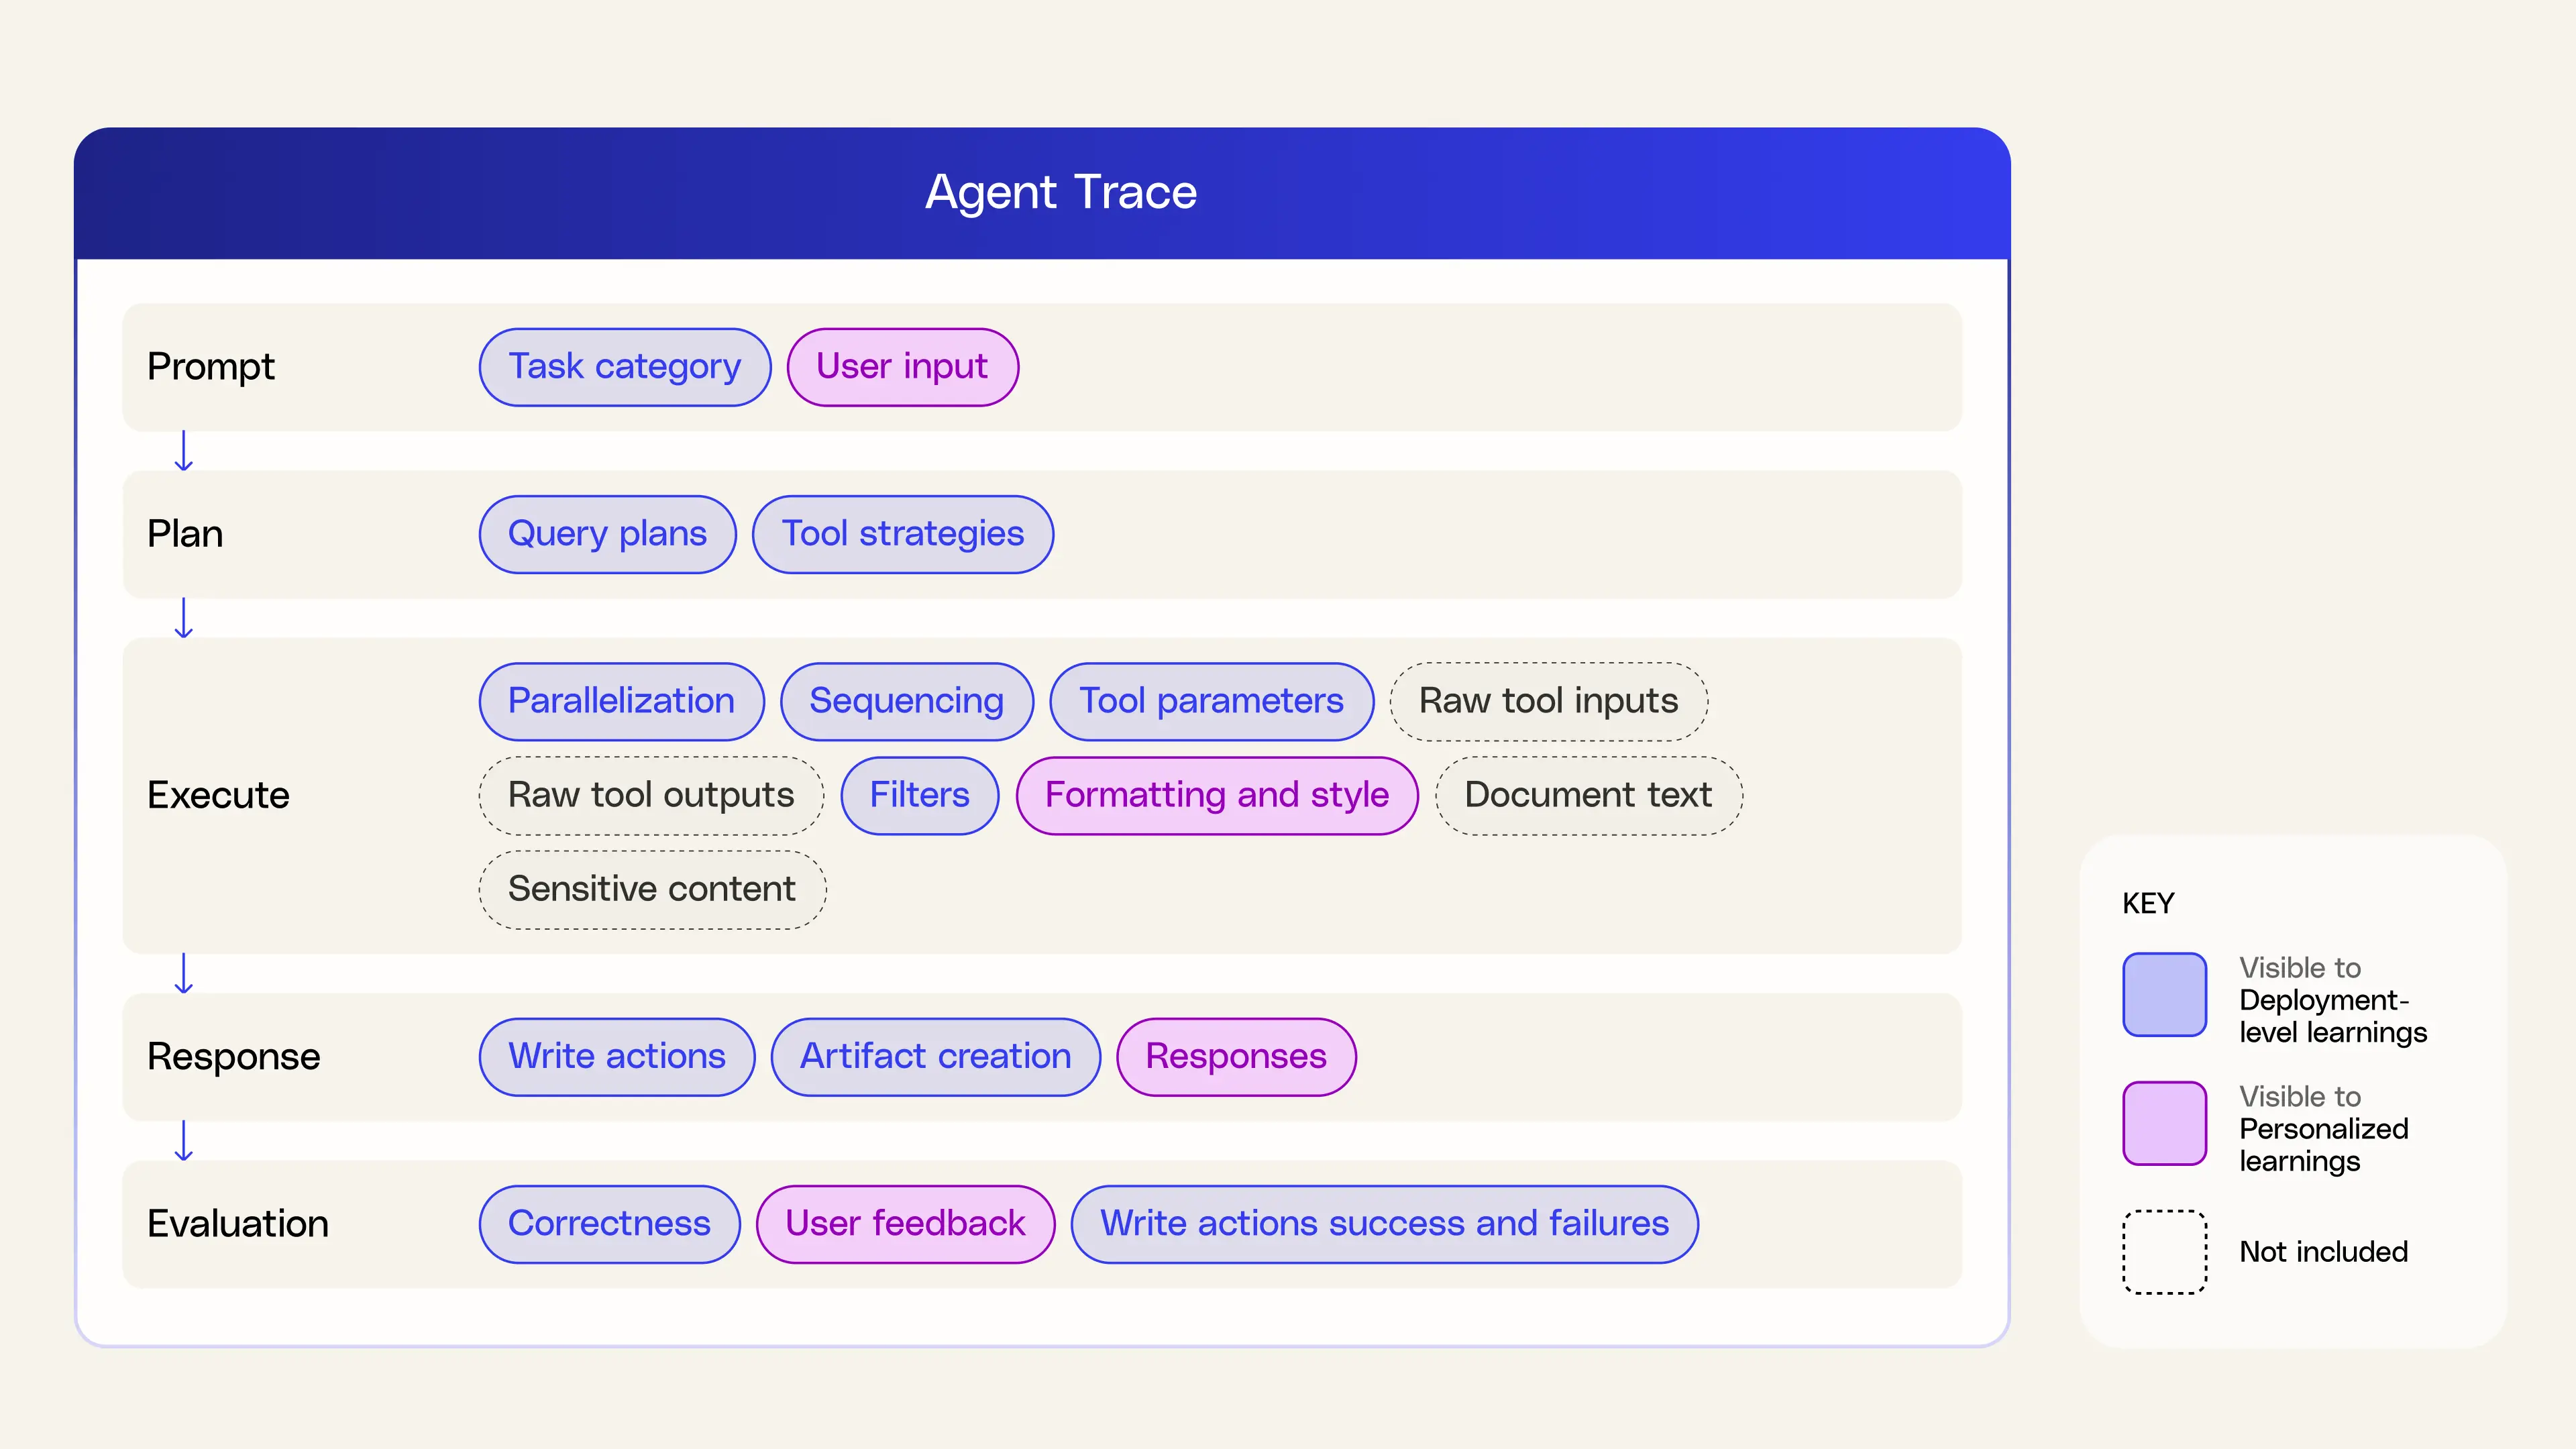
La mémoire est conçue avec la sécurité à l'esprit. L'apprentissage se produit au niveau du déploiement ou de l'utilisateur et n'est jamais généralisé entre entreprises. Tous les apprentissages sont stockés en dehors des modèles, sans aucune information conservée en dehors d'un déploiement Glean. Les actions qui écriraient dans des applications comme Google Drive, Salesforce, Jira, Asana ou Slack sont rejouées dans un chemin fantôme sans toucher aux données de production. Cela nous permet d'apprendre en testant des flux de bout en bout réalistes sans impacter les données des clients.
Nous structurons la mémoire sur deux niveaux : des stratégies au niveau du déploiement qui sont partagées au sein d'une entreprise, et des apprentissages personnalisés qui ne sont visibles que par l'utilisateur individuel.
- L'apprentissage au niveau du déploiement se concentre sur la manière dont les outils sont utilisés, et non sur les données sous-jacentes. Nous ne stockons que ce qui se généralise, comme les noms d'outils, les schémas de séquencement, les modèles de paramètres et les types de requêtes. Nous excluons explicitement les invites utilisateur, le contenu des documents, les résultats bruts des outils, les titres, les identifiants, les e-mails et autres champs sensibles.
- L'apprentissage au niveau de l'utilisateur est privé à chaque individu. Il capture des préférences telles que les modèles de contenu et la mise en forme de documents comme les pull requests, les notes de version et les mises à jour de statut, ainsi que les styles de communication pour les travaux créatifs ou destinés aux clients.
Nos premières versions de l'apprentissage par traces ne stockaient que des stratégies au niveau du déploiement, afin de prioriser la sécurité et une compréhension partagée des workflows. Mais cela signifiait aussi que nous passions initialement à côté de la mémoire au niveau de l'utilisateur, là où les modèles, la mise en forme et les préférences de travail individuelles comptent le plus. Nous avons ensuite constaté que ces stratégies au niveau de l'utilisateur avaient un impact significatif sur les performances, ce qui nous a conduits à adopter une structure de mémoire à deux niveaux.
Étendre l'apprentissage par traces au-delà des exécutions d'agents
L'apprentissage par traces est une étape clé vers la création d'agents qui s'améliorent avec l'expérience. En apprenant à partir d'exécutions réelles, les agents dépassent la simple réalisation ponctuelle de tâches et commencent à accumuler des connaissances pratiques sur ce qui fonctionne, ce qui échoue et comment aborder plus efficacement des problèmes similaires au fil du temps.
Mais les traces ne se limitent pas aux exécutions d'agents. Elles existent également dans l'ensemble des systèmes d'entreprise, sous forme d'enregistrements de la façon dont le travail s'effectue réellement, couvrant les documents, les actions et les interactions entre les outils. La prochaine étape consiste à relier ces couches. Les traces d'agents montrent comment les tâches sont exécutées, tandis que les traces d'entreprise montrent comment le travail circule à travers l'organisation. Ensemble, elles ouvrent la voie à une compréhension plus approfondie des workflows — c'est là qu'interviennent les graphes de contexte.
Pour en savoir plus sur l'exécution de tâches qui s'améliore d'elle-même, demandez une démo dès aujourd'hui !
