






Il y a un an, lorsque MCP a décollé, il semblait offrir un moyen simple et prêt à l'emploi de connecter l'IA aux données et aux actions, et beaucoup se demandaient si l'index avait encore un avenir. Un an plus tard, la question a évolué, car la qualité des outils MCP tout prêts n'a pas atteint le niveau requis pour l'entreprise : qui dispose réellement de la meilleure couche de contexte d'entreprise ?
Il est désormais largement admis que les grands agents dépendent d'un contexte de haute qualité associé à de puissants modèles de raisonnement. On le constate dans tout le secteur : Cursor utilise la recherche de code pour améliorer la précision des réponses de 12,5 %. Les recommandations d'Anthropic sur l'ingénierie du contexte soulignent que le contexte est une ressource essentielle pour les agents et doit être activement organisé. Même la connaissance d'entreprise d'OpenAI inclut certains connecteurs synchronisés (indexés).
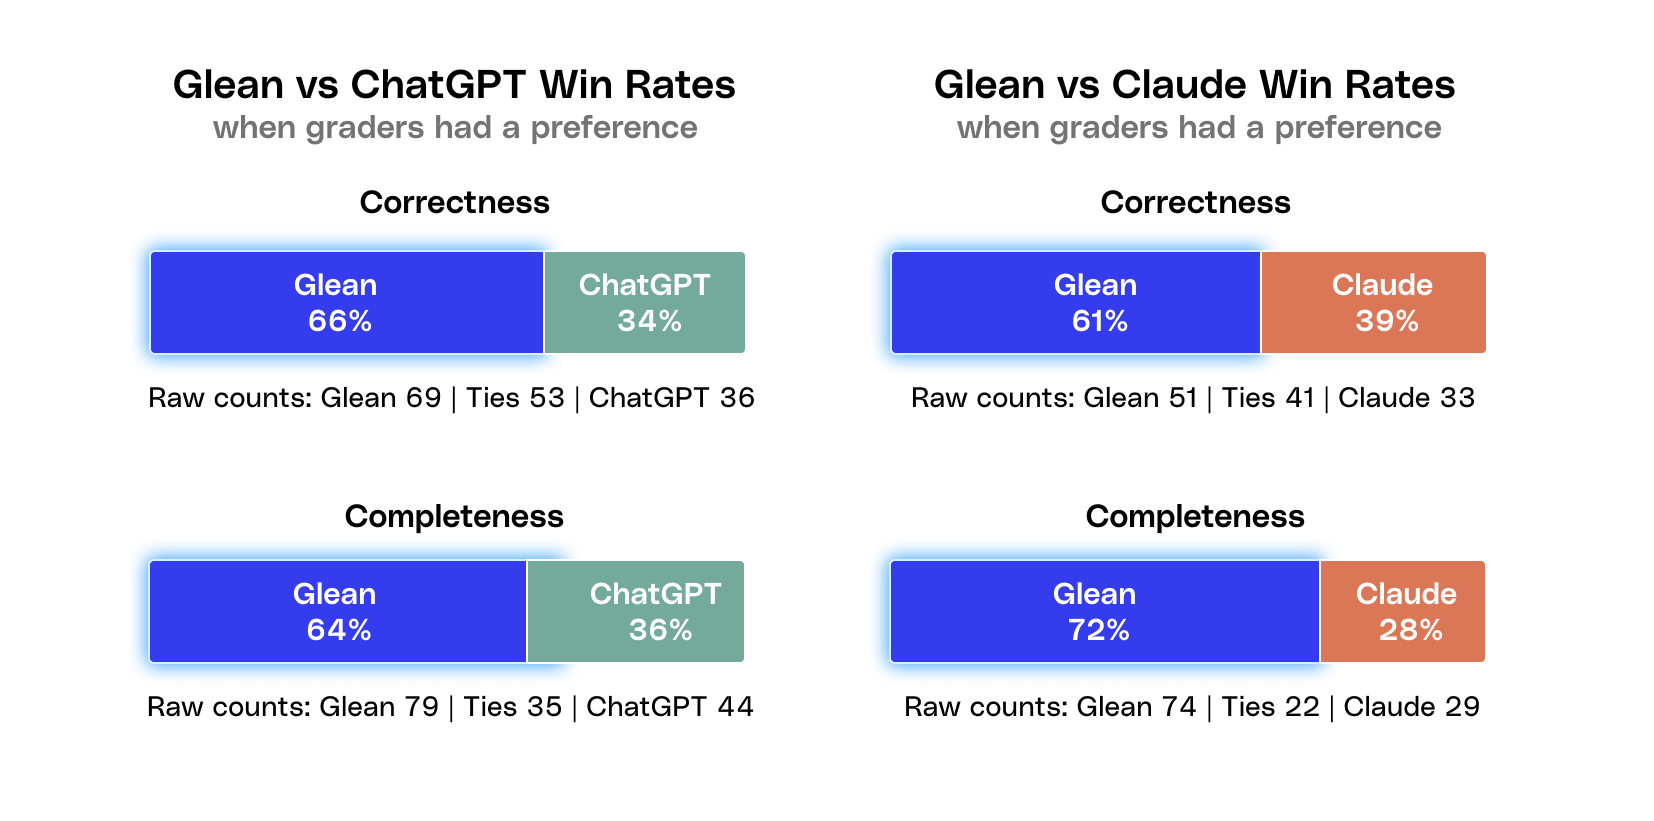
Nous avons donc examiné comment la pile que Glean a construite au cours des six dernières années en matière de contexte d'entreprise se comparait aux nouveaux acteurs du marché comme la connaissance d'entreprise de ChatGPT d'OpenAI et la recherche d'entreprise de Claude d'Anthropic. Nous avons découvert que les évaluateurs humains, lorsqu'ils avaient une préférence, choisissaient la réponse de Glean comme étant correcte 1,9 fois plus souvent que celle de ChatGPT et 1,6 fois plus souvent que celle de Claude.
La pérennité du contexte
Avant d'aborder les résultats, nous voulons expliquer pourquoi le contexte compte pour le travail agentique, et pourquoi les modèles seuls échouent lorsqu'il s'agit de le gérer.
Les LLM disposent d'un budget d'attention fixe. Ils traitent les entrées comme une séquence unique de tokens, avec un sens limité de la structure ou de l'importance. À mesure que le contexte s'étend, le mécanisme d'attention doit se répartir sur un nombre croissant de tokens, ce qui affaiblit sa capacité à se concentrer sur les bons. Cela entraîne également des interférences où le contexte commence à entrer en conflit dans la mémoire du modèle, faisant que les faits se brouillent, que les anciennes et nouvelles preuves se concurrencent, et que des tokens non pertinents captent l'attention.
Ce phénomène porte le nom de pourrissement du contexte (context rot). Timothy Lee, rédacteur de la newsletter Understanding AI, l'a bien résumé dans un article mettant en avant une étude d'Adobe. Il a noté qu'à mesure que la « botte de foin » grandissait, la précision du modèle à trouver l'« aiguille » chutait fortement. Et il ne s'agissait là que de sauts de raisonnement uniques : les performances chutaient encore davantage lorsque les modèles devaient effectuer plusieurs sauts.
Chez Glean, nous pensons que le problème du pourrissement du contexte est sur le point de prendre une ampleur bien plus grande. Les agents sont à l'aube d'exécutions plus longues et de travaux complexes, qui exigent beaucoup plus de contexte. Les agents ont besoin du bon contexte au bon stade de l'exécution ; sinon, les erreurs de récupération initiales se répercutent, compromettant le reste de l'exécution de l'agent.
Conception de l'évaluation
Ensemble de requêtes et jeu de données
La difficulté de l'évaluation de la recherche d'entreprise est qu'il n'existe pas de bons benchmarks publics. La recherche d'entreprise ne concerne pas uniquement le contenu, elle est façonnée par tout ce qui entoure ce contenu. La pertinence dépend de signaux qui n'apparaissent jamais dans les jeux de données statiques : la fréquence à laquelle les équipes ouvrent un fichier, qui interagit avec lui, dans quels systèmes il réside, comment il est lié à des tickets ou des commits, etc. Les connecteurs comptent également : différentes applications exposent différentes métadonnées, horodatages et types d'objets, et ces signaux influencent fortement le classement et la fraîcheur. Il faut réellement connecter de véritables données d'entreprise et exécuter de véritables requêtes d'entreprise pour pouvoir évaluer la recherche d'entreprise.
C'est ce que Glean a fait pour cette évaluation. Nous avons conçu notre jeu de données et nos requêtes pour reproduire aussi fidèlement que possible un environnement d'entreprise réel, sans toucher aux données des clients. Notre substitut était le déploiement réel de Glean lui-même. Nous avons déterminé la distribution des classes de requêtes, regroupements d'intentions des utilisateurs lorsqu'ils émettent une requête, au sein de notre pool de clients agrégé et anonymisé afin de préserver leur confidentialité. Nous avons ensuite extrait environ 280 requêtes du propre déploiement interne de Glean, et non de données clients, qui tentaient de correspondre étroitement à cette distribution, tout en gardant à l'esprit les profils de connecteurs limités disponibles dans ChatGPT et Claude.
Nous avons concentré l'ensemble de requêtes sur des requêtes plus « complexes », en utilisant le nombre de sources de données sollicitées par la requête comme indicateur de complexité : « Quelle est notre politique RH ? » est relativement simple, car elle repose généralement sur un seul document canonique. En revanche, si une requête sollicite plusieurs sources de données, elle peut nécessiter un raisonnement multi-sauts pour réconcilier les entités entre les sources, ce qui la rend bien plus difficile à traiter correctement.
Pour le jeu de données, nous avons connecté des sources de données comparables entre Glean et ChatGPT, et entre Glean et Claude, afin que dans chaque appariement nous puissions tester la pile de recherche : la profondeur des connecteurs, la manière dont les pipelines de recherche et de classement fournissent la pertinence, et dans quelle mesure le modèle utilise les outils de recherche.
Pour la comparaison avec ChatGPT, nous avons utilisé ChatGPT Business avec la connaissance d'entreprise, connecté à Google Drive, Google Calendar, GitHub et Slack. Pour la comparaison avec Claude, nous avons utilisé la recherche d'entreprise de Claude Teams sur Sonnet 4.5, connectée à Confluence, Jira, GitHub, Google Drive, Slack et Salesforce. Au moment de cette évaluation, ChatGPT ne disposait pas de ce que nous considérons comme des connecteurs essentiels tels que Jira et Salesforce, ce qui limitait la complexité possible de son ensemble de requêtes et de son jeu de données.
Comme Glean est agnostique en matière de modèles et utilise à la fois Anthropic et OpenAI, nous avons exécuté Glean sur les mêmes modèles. Nous avons isolé les performances de recherche et les harnais d'agents en comparant Glean (GPT-5.1) à ChatGPT, et Glean à Claude (tous deux sur Sonnet 4.5).
Évaluation
Nous avons mené une évaluation à l'aveugle et randomisée en utilisant une échelle de préférence à cinq points (nous avons regroupé les préférences en catégories pour ce blog) selon les dimensions suivantes :
- Exactitude : précision factuelle et validité logique par rapport à la requête
- Exhaustivité : couverture de toutes les parties de la question et des étapes nécessaires
Nous avons choisi ces indicateurs d'évaluation car ils reflètent ce qui préoccupe réellement les entreprises : La réponse est-elle fiable, ou s'agit-il d'une hallucination ? L'IA a-t-elle entièrement répondu à la requête de l'utilisateur, ou ce dernier doit-il encore terminer le travail ?
Les citations étaient affichées aux côtés des réponses afin que les évaluateurs puissent vérifier les affirmations factuelles. Lorsqu'une question sortait de leur domaine d'expertise, les évaluateurs pouvaient « appeler un ami » en utilisant la recherche d'experts de Glean pour trouver un expert du sujet, puis confirmer leur jugement avec lui.
Nous avons choisi une évaluation relative (comparant les réponses entre elles) plutôt qu'une évaluation subjective, car les gens se calibrent différemment sur ce qu'ils considèrent comme « correct » ou « complet », et les comparaisons relatives réduisent ce biais propre à chaque personne. Nous avons également atténué le biais de position en permutant aléatoirement les positions de Glean et de ChatGPT ou Claude pour différentes requêtes.
Nous avons fait appel à quatre évaluateurs pour la phase initiale, puis nous avons recoupé les résultats avec notre propre équipe qualité IA afin de nous assurer que l'évaluation respectait les directives.
Résultats de l'évaluation
Nous avons analysé les résultats à l'aide de ratios victoires-défaites. Lorsque les évaluateurs exprimaient une préférence, ils choisissaient Glean plutôt que ChatGPT 1,9× plus souvent et plutôt que Claude 1,6× plus souvent sur le critère de l'exactitude.
Glean a résolu le problème du contexte en combinant des données indexées pour une recherche rapide, des Graphes d'entreprise pour comprendre les relations, et une mémoire d'entreprise (via l'apprentissage par traces) pour optimiser l'utilisation des outils, en se concentrant sur les structures de données sous-jacentes qui alimentent la recherche.
En examinant Claude et ChatGPT, nous avons constaté qu'ils ont tendance à compenser les lacunes de qualité de leurs outils en multipliant les appels d'outils. Ils récupèrent donc trop de données, ce qui est à la fois coûteux et susceptible d'introduire du bruit menant à des résultats inexacts.
Claude et ChatGPT adoptent toutefois des stratégies d'appel d'outils différentes. Nous observons que Claude emprunte une voie « en profondeur » :
- il réfléchit davantage à la question
- effectue des appels d'outils séquentiels
- lit l'intégralité des résultats en détail
- et s'il est sur la mauvaise piste, il pivote et en explore une autre
Comme il s'appuie sur des outils basés sur MCP qui ont tous des valeurs par défaut, des limites et des formats de données différents, Claude peut se retrouver avec un contexte inégal selon la source. Par exemple, si Slack renvoie de longs fils de discussion tandis qu'un autre outil ne fait remonter que quelques enregistrements courts, Slack peut facilement dominer la fenêtre de contexte et fausser ce à quoi le modèle prête attention. De plus, nous avons constaté qu'il était difficile pour Claude de se corriger une fois engagé sur une voie particulière. Par exemple, une fois qu'il avait déterminé que Slack pouvait répondre à la question, il n'invoquait souvent pas d'autres outils MCP pour trouver la source canonique.
ChatGPT, en comparaison, adopte une stratégie « en largeur » en lançant des recherches en parallèle et en ne consultant que les extraits les plus pertinents de chaque document. Il optimise la vitesse et l'étendue en survolant d'abord les documents, en déclenchant de nombreuses recherches et en parcourant de nombreux documents, puis en approfondissant quelques-uns des documents les plus pertinents. Malgré tous les efforts d'OpenAI pour sonder en largeur et en profondeur, il ne parvient parfois toujours pas à trouver l'information pertinente en raison de la qualité des outils de recherche sous-jacents. L'autre difficulté de cette approche est qu'elle peut entraîner une surcharge de contexte, car OpenAI lit des documents provenant de nombreuses sources et peine à synthétiser des données contradictoires, notamment en combinant d'anciens documents avec de plus récents.
Bien que nous n'ayons pas mesuré la latence ni le coût, chaque appel d'outil représente une dépense. S'appuyer sur de nombreux appels d'outils et tokens pour passer au crible des données largement non pertinentes devient un contournement coûteux et peut aussi atteindre les limites de débit, provoquant l'échec de futures requêtes pour d'autres utilisateurs de l'organisation. Les index et les graphes de connaissances perdurent parce qu'ils sont extrêmement précis et évitent le piège classique de la force brute par la puissance de calcul.
Classes de requêtes
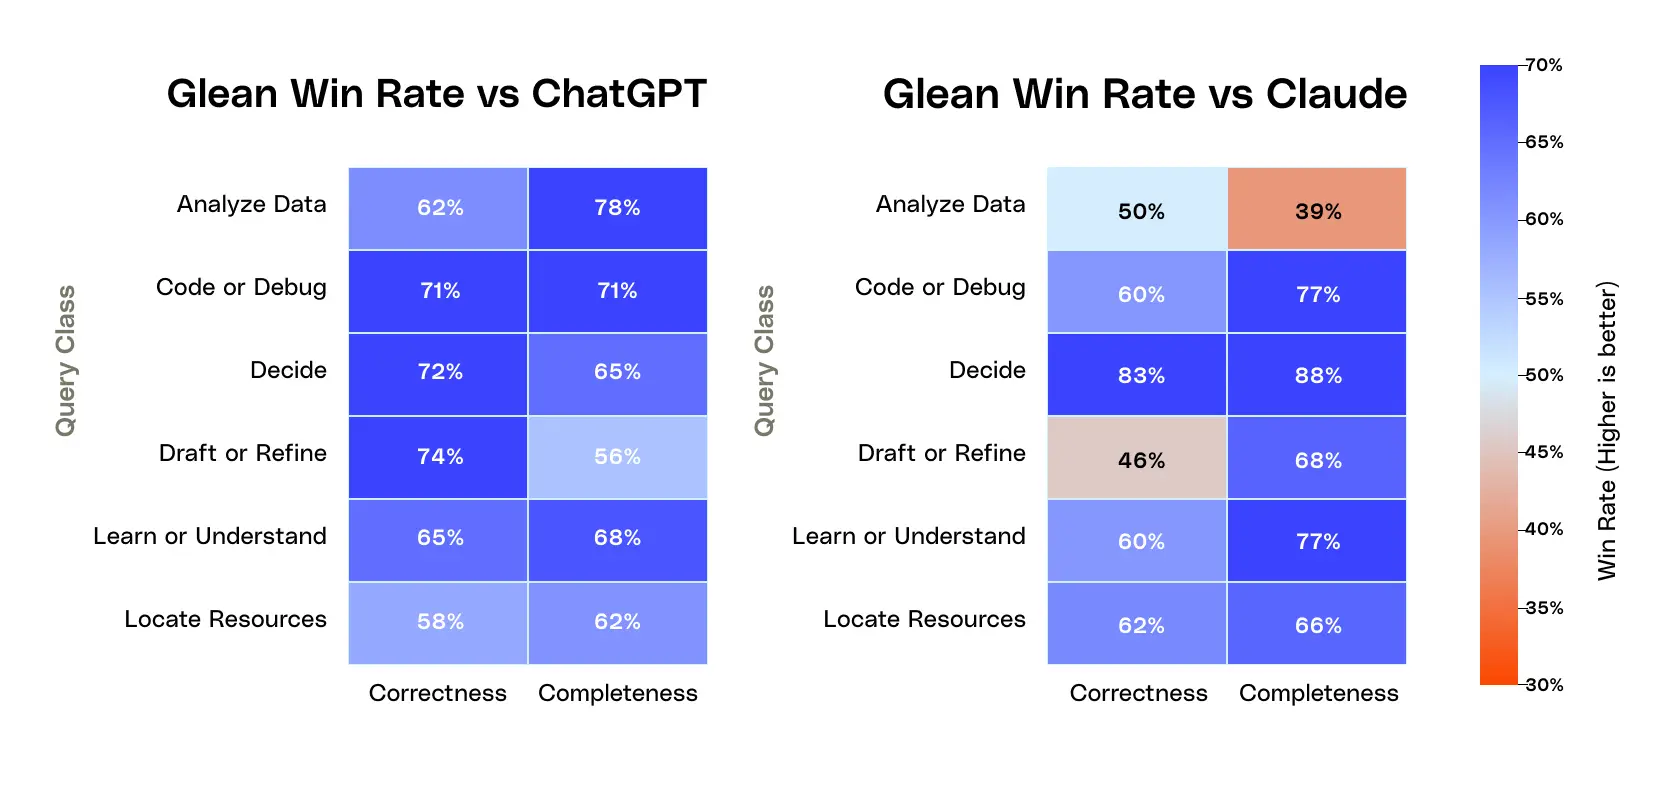
Nous avons ensuite examiné comment Glean se comportait selon les différentes classes de requêtes. Si la recherche est souvent considérée comme une catégorie unique, elle sous-tend en pratique de nombreux types de travail agentique, notamment :
- Analyser des données : calculer des métriques, identifier des tendances, générer des graphiques et des tableaux
- Coder et déboguer : écrire du code ou résoudre des problèmes de configurations techniques
- Prendre des décisions : peser les options, comparer les compromis, recommander une marche à suivre
- Rédiger du contenu : écrire ou éditer des e-mails, documents, spécifications et présentations
- Apprendre : expliquer, définir et fournir des guides étape par étape
- Trouver des informations : la recherche classique — localiser un document ou une ressource spécifique
Lorsque l'on observe la répartition des requêtes où Glean a été préféré, les victoires se répartissent sur l'ensemble de ces catégories, reflétant les différentes façons dont les entreprises utilisent réellement l'IA aujourd'hui.
Les résultats quantitatifs ne racontent qu'une partie de l'histoire ; nous avons donc également mené une évaluation qualitative pour comprendre où et pourquoi Glean, ChatGPT et Claude performaient le mieux.
Exactitude
Victoires
Glean s'est montré meilleur pour trouver le document canonique, comprendre le jargon propre à l'entreprise, traiter les requêtes ambiguës et répondre aux requêtes techniques.
Sur le plan de l'exactitude, Glean a mieux performé sur les tâches nécessitant la source faisant autorité pour une réponse. Cela reflète nos origines dans la recherche d'entreprise, où la précision dépend de la capacité à récupérer le bon document, puis le bon extrait.
En coulisses, Glean construit un modèle de recherche sémantique pour chaque entreprise, stocké de manière sécurisée dans le VPC du client. Le modèle apprend le langage de l'entreprise et devient sensible aux produits, clients, projets, abréviations et termes du secteur. Ces modèles sémantiques expliquent en partie pourquoi Glean a surpassé ses concurrents sur les requêtes reposant sur un jargon propre à l'entreprise.
Glean maintient également un Graphe d'entreprise sur les données, cartographiant les relations entre projets, clients, équipes, tickets, documents et code. Lorsqu'une requête est ambiguë, Glean peut exploiter ce graphe pour identifier le projet ou l'entité visé par l'utilisateur.
Les fondations de recherche de Glean vont aussi au-delà d'un index unique : nous construisons plusieurs index spécialisés sur vos données, adaptés au type de requête. Par exemple, nous maintenons des index lexicaux et sémantiques dédiés à la recherche de code, ce qui nous aide à mieux performer sur les requêtes techniques où le contexte pertinent réside dans le code plutôt que dans des documents.
Je vais rechercher dans Salesforce les comptes attribués à Martinique. Martinique Charleston est attribuée à 43 comptes dans Salesforce en tant que Customer Success Manager. Voici la liste complète :
Comptes (A-Z)
- Adler Street Capital
- Aether Ridge Energy
- AlioraCorp
- Antivex Systems
- Apexion Materials
- Aurora Global Logistics
- Brookline Inc.
- CashTrail Rewards
- Cepora
- ChromaWave
- CloudBridge Nexus (Partner)
- CodeFountain Labs
- Cyphin Labs
- Diamond Analytics
- Diatris Foundation
- DualSight Metrics
- Elora
- Exonaa Financial
- Fork Analytics
- Fortisense Labs
- Granite Edge Management
- Harborline Capital Group
- Harmony Capital
- Hyperine
- Intellibug Labs
- Keystone Balance Advisors, LLC
- LoopTransit Labs
- Lumina Vector AG
- Northwind Strategy Group
- NovaCredi México
- Onyx Harbor Security
- Pathwise Learning Institute
- PulseLink Safety Systems
- SeatPilot Systems
- Sparklift Intelligence
- Starlight Arcade Studios
- Stonegate Payments
- Summit Ridge Ventures
- TreeLine Field Systems
- VectorSignal Insights
- Wavecrest IT Services
Souhaitez-vous consulter davantage de détails sur des comptes spécifiques ou filtrer cette liste par secteur, taille ou d'autres critères ?
Je vais rechercher dans Salesforce les comptes attribués à Martinique. Martinique Charleston est attribuée à un seul compte dans Salesforce : Neptune
Détails du compte :
- Nom du compte : Neptune
- ID du compte : XXXX
- Propriétaire : Martinique Charleston
- Secteur : Internet Software & Services
- Type : Open Opportunity Prospect
Remarque : ces informations sont basées sur les données Salesforce actuelles, où Martinique Charleston est répertoriée comme propriétaire du compte.
Glean a déduit que Martinique est une customer success manager et a interprété le propriétaire comme étant la CSM attribuée au compte, plutôt que le propriétaire du compte. Claude n'a récupéré qu'un seul enregistrement indiquant Martinique comme propriétaire du compte. Glean est en mesure de mieux déduire l'intention de l'utilisateur à partir de la requête grâce à la profondeur de son indexation, en intégrant des champs plus riches et plus structurés, ainsi que le Graphe d'entreprise qui met en correspondance les employés, comme Martinique, avec les comptes.
Je vais rechercher des informations sur la fréquence des statistiques de corpus dans la documentation de votre entreprise. D'après les résultats de recherche, les statistiques de corpus s'exécutent à plusieurs fréquences selon la variante du pipeline :
Pipeline principal des statistiques de corpus
corpus_stats s'exécute selon un double calendrier :
-
Quotidien : Minuit UTC
(
0 0 * * *) -
Horaire : Chaque heure de 1 à 23 UTC
(
0 1-23 * * *), uniquement si le dernier dump récent date de moins de 65 minutes
Les exécutions horaires ne se déclenchent que pour les dumps récents d'un âge maximal de 65 minutes, tandis que l'exécution quotidienne a lieu quelle que soit la fraîcheur du dump afin de garantir la couverture.
Corpus Stats DAC Only
corpus_stats_dac_only s'exécute
chaque semaine, le dimanche à minuit UTC
(0 0 * * 0).
Cette variante calcule spécifiquement les décomptes de documents X avec une période de rétrospective Y.
Pipeline associé
corpus_insights s'exécute selon un calendrier différent - deux fois par mois — le 1er et le 16 à minuit UTC, avec des exécutions consécutives espacées de 15 jours
Vous pouvez consulter les calendriers d'exécution actuels des pipelines et les exécutions de tâches sur go/xxx. Besoin d'aide pour comprendre pourquoi une exécution spécifique des statistiques de corpus a échoué ou pour ajuster la fréquence ?
Je vais rechercher des informations sur les statistiques de corpus et leur fréquence dans les systèmes de votre entreprise. D'après ma recherche dans les communications internes et la documentation, les statistiques de corpus s'exécutent selon une cadence hebdomadaire.
Le pipeline corpus_stats dépend de l'achèvement de docs_data et s'exécute environ une fois par semaine. En examinant les fichiers X générés par le pipeline, les dates montrent une tendance hebdomadaire cohérente (4 octobre, 11 octobre, 18 octobre, 4 novembre).
Il existe également une variante appelée corpus_stats_xxx_only qui s'exécute selon le même calendrier hebdomadaire.
Il convient de noter que le pipeline comporte une vérification de seuil : il ne s'exécutera pas si le docs_data le plus récent n'est pas suffisamment à jour. Le seuil est d'environ 1 heure et 5 minutes.
Glean a correctement identifié le calendrier échelonné pour l'exécution des statistiques de corpus, tandis que Claude a incorrectement déduit une simple cadence hebdomadaire. Glean n'a pas eu à s'appuyer uniquement sur des documents potentiellement obsolètes ou inexacts : il a aussi pu examiner directement le code comme source de vérité. À l'inverse, la recherche de Claude s'est fortement appuyée sur Slack.
Points faibles
Cela dit, il existait des domaines où d'autres faisaient mieux que Glean. L'un d'eux consistait à savoir quand demander des clarifications : Claude reconnaissait souvent lorsqu'il n'y avait pas assez d'orientation ou de données pour répondre et choisissait de poser des questions de suivi.
ChatGPT avait tendance à mieux suivre les instructions explicites de l'utilisateur liées à une source de données ou à une procédure particulière, en se concentrant exactement sur ce qui était demandé. Glean, en revanche, optimise l'utilité. Lorsque nous constatons un contexte manquant ou des occasions d'ajouter des détails utiles, nous allons parfois au-delà du libellé littéral de la requête pour combler les lacunes, tout en ancrant le tout dans les connaissances de votre entreprise.
Exhaustivité
Points forts
En matière d'exhaustivité, nous avons constaté que Glean se démarquait sur les requêtes nécessitant des détails techniques complets, des étapes concrètes à suivre et une compréhension de cadres exhaustifs.
En examinant les commentaires des évaluateurs, ils préféraient les réponses qui détaillaient les étapes concrètes et incluaient les bons canaux Slack, formulaires d'admission, tickets Jira ou playbooks. Cela provient en partie du Graphe d'entreprise et de la connaissance de la relation entre les tickets Jira et les différents projets, mais aussi de la reconnaissance de l'intention de l'utilisateur dans le contexte d'entreprise et d'une réponse plus globale aux questions en faisant émerger des étapes concrètes à suivre.
Glean sait également mieux rester concentré sur l'intention de l'utilisateur, car il récupère un contexte plus pertinent pour sa requête. Lorsque ce contexte est riche, précis et bien ciblé, le modèle peut déduire « de quoi il s'agit réellement » à partir des preuves environnantes plutôt que de s'appuyer uniquement sur la requête. Autrement dit, un meilleur contexte permet à l'agent de déduire l'intention plutôt que de la deviner.
Lorsque la tâche consiste à créer un cadre cohérent (analyse concurrentielle, cadre de décision, plan en plusieurs étapes), l'avantage de Glean est qu'il peut voir de manière fiable une plus grande partie du paysage pertinent et le structurer avec le Graphe d'entreprise. Ainsi, l'IA peut parcourir systématiquement les éléments connexes au lieu de surpondérer les résultats d'une seule source.
D'après les documents liés à Juniper Beta, le projet est géré principalement par :
- Gestion de produit / programme beta global : Arvin Allworth (Product Manager, Growth & Knowledge Management). Il est le PM de Juniper et propriétaire de documents tels que « Juniper - Weekly Update » et « Juniper Beta Candidate Apps », qui décrivent et suivent la beta.
- Direction de l'ingénierie pour Juniper : Sam Aimes (Software Engineer, EM de l'équipe Juniper). Il apparaît comme manager des ingénieurs principaux de Juniper et est répertorié comme propriétaire de « Proactive intelligence (Juniper) ».
- Déploiement quotidien de la beta / configuration des expériences : Bradley Murphey (Software Engineer). est le contributeur individuel principal qui édite et possède des configurations comme « [Juniper] Draft of experiment config to greenlist Juniper BETA users » et « Juniper beta: add Crema Inc. and Popsicle Io testers to home_page_task_list_greenlist », qui portent spécifiquement sur la cohorte beta et les mécanismes de déploiement.
Donc : Arvin gère le programme Juniper Beta côté produit, Sam dirige l'équipe d'ingénierie et Bradley pilote la configuration des expériences beta et les travaux de déploiement.
Souhaitez-vous leurs coordonnées ou les noms de documents spécifiques référencés ?
La beta Juniper est dirigée par Arvin Allworth — il est le PM/DRI du projet Juniper (annoncé sur Slack et répertorié comme PM dans le document d'exécution R&D).
Glean a fourni une réponse plus complète en listant tous les responsables du projet, tandis que ChatGPT n'a mentionné que le PM global. Le Graphe d'entreprise de Glean peut identifier les différents types de propriétaires de projet et comprendre sur quoi travaillent les collaborateurs dans toute l'organisation.
Points faibles
Nous avons constaté que ChatGPT a tendance à l'emporter sur l'exhaustivité lorsqu'une requête tire parti de plusieurs approches ou exemples, par exemple en présentant 3 méthodes différentes, en comparant des schémas et en proposant des alternatives dans différents langages de programmation.
Nous avons également observé un biais constant en faveur d'explications causales avec un contexte élargi. ChatGPT aime présenter un récit complet, étape par étape, et développer avec des analogies ou des exemples, ce qui donne l'impression que les réponses sont expliquées de façon plus détaillée. Glean, à l'inverse, est optimisé pour être plus concis et orienté tâches, avec moins de mise en contexte narrative. Dans les comparaisons côte à côte, ce pragmatisme peut parfois sembler manquer de contexte face au style plus foisonnant de ChatGPT.
À mesure que Glean continue de personnaliser l'expérience, nous nous éloignons des préférences globales pour devenir plus adaptables à chaque individu. Si un utilisateur préfère une réponse plus directe et unique, la mémoire de Glean s'adaptera à mesure que nous apprenons des interactions des utilisateurs et de leurs préférences personnelles. L'exhaustivité relève en fin de compte de la perception de l'utilisateur, et notre objectif est de nous assurer qu'il obtient toutes les informations qu'il souhaite, de la manière dont il les souhaite.
Tous les contextes ne se valent pas
Offrir un contexte d'entreprise de qualité exige des fondations techniques solides. C'est précisément ce dans quoi nous investissons chez Glean : des connecteurs, des index, un Graphe d'entreprise, une mémoire d'entreprise (via l'apprentissage par traces) et des compétences qui fonctionnent de concert pour donner aux agents le contexte dont ils ont besoin pour opérer pleinement et avec précision.
À mesure que la taille et la diversité des données d'entreprise exploitées par l'IA augmentent, ces fondations comptent encore davantage. La plupart des nouveaux acteurs ne prennent en charge qu'une poignée d'intégrations, loin d'être représentatives des applications présentes au sein d'une entreprise moderne, puis comblent le déficit de couverture via MCP. Les implémentations MCP naïves introduisent des difficultés quant à la manière dont les outils sont appelés, exposant souvent des outils de qualité faible ou incohérente, ce qui rend difficile de réconcilier et de combiner les résultats entre les outils.
Glean compte plus de 100 connecteurs, et cela fait toute la différence. Nous pouvons prendre en charge davantage de tâches agentiques parce que nous voyons une plus grande part de l'entreprise et parce que la pile de contexte sous-jacente est conçue pour gérer cette échelle. Et grâce au serveur MCP distant de Glean, nous rendons ce contexte unifié disponible partout où vous choisissez d'utiliser l'IA, afin que vous puissiez aussi apporter le contexte de Glean dans ChatGPT ou Claude. Nous continuons d'améliorer la façon dont Glean s'intègre à l'un comme à l'autre, avec pour objectif de faire du contexte d'entreprise complet le socle de votre travail dans ChatGPT et Claude.
Auteurs : Matthew Zhao, Karthik Rajkumar, Neil Dhruva, Julie Mills, Matt Ding, Anshul Negi
