L'IA générative pour les ingénieurs logiciels ne se contente pas de compléter du code. La prochaine vague de gains de productivité viendra de la capacité à aider les ingénieurs à trouver du contexte, à gérer les incidents et à livrer en toute sécurité à travers les systèmes où le code réside réellement.
GitHub Copilot écrit déjà près de la moitié du code du développeur moyen — pourtant, une étude contrôlée récente a révélé que les développeurs expérimentés utilisant des outils d'IA mettaient 19 % de temps en plus pour accomplir leurs tâches, même s'ils pensaient que l'IA les avait rendus 20 % plus rapides.
Le goulot d'étranglement n'est plus la saisie. C'est le système de contexte autour du code, et la plupart des stacks d'ingénierie n'ont pas construit la couche qui le fournit.
En bref
- Les assistants de codage IA ont résolu un problème que les ingénieurs n'ont plus. Le véritable frein, c'est la reconstruction du contexte entre GitHub, Jira, Slack, les outils d'observabilité, les documents de conception et les wikis.
- Une stack d'IA à deux couches — les surfaces de codage au-dessus, une couche de contexte partagée en dessous — devient le modèle architectural qui distingue les équipes qui obtiennent un vrai ROI de celles qui multiplient les projets pilotes déconnectés.
- La confiance, la gouvernance et l'explicabilité comptent désormais autant que la qualité des modèles. 45 % du code généré par l'IA contient au moins une vulnérabilité de haute gravité.
- Les équipes qui obtiennent des résultats mesurables grâce à l'IA en ingénierie — notamment LinkedIn, Uber et deux des trois principales organisations spécialisées dans les assistants de codage — standardisent leur approche autour d'une couche de contexte partagée que chaque outil peut solliciter.
- Les responsables d'ingénierie qui évaluent des outils d'IA devraient se poser quatre questions : De quel contexte dispose l'outil ? Comment la confiance se gagne-t-elle ? Où vont les données ? L'outil s'intègre-t-il à la façon dont les équipes travaillent déjà ?
Le paradoxe de la productivité de l'IA en ingénierie
Trois lacunes reviennent sans cesse dans les conversations avec les responsables d'ingénierie, et ensemble elles expliquent pourquoi l'IA dans le cycle de développement logiciel donne l'impression qu'elle devrait mieux fonctionner qu'elle ne le fait.

La lacune de résultats. Dans un essai contrôlé randomisé mené auprès de développeurs open source expérimentés, les problèmes où les développeurs étaient autorisés à utiliser des outils d'IA ont pris 19 % de temps en plus à résoudre. Les développeurs s'attendaient au départ à être 24 % plus rapides.
Ils pensaient ensuite que l'IA les avait accélérés d'environ 20 %. L'assistant suggère constamment du code, donc le travail semble plus rapide — mais avec seulement un contexte au niveau du fichier ou du dépôt, il passe souvent à côté des contraintes issues des tickets, des conceptions et d'autres services. Le temps de saisie économisé revient plus tard sous forme de reprises et d'intégration.
La lacune de confiance. Au fil du temps, l'illusion de productivité crée un problème de confiance. Davantage de développeurs se méfient activement de la précision des outils d'IA qu'ils ne leur font confiance — environ 46 % contre 33 %. 66 % affirment que leur plus grande frustration réside dans les solutions d'IA qui sont « presque justes, mais pas tout à fait ». 45 % affirment que le débogage du code généré par l'IA prend souvent plus de temps que de l'écrire eux-mêmes. Lorsque l'assistant dispose d'un contexte limité, il produit du code plausible qui ne s'aligne pas tout à fait avec le système environnant, et les ingénieurs passent le temps économisé à traquer l'incohérence.
La lacune de sécurité. Les revues de sécurité font apparaître de réels risques. Dans certaines analyses, près de 45 % du code généré par l'IA contenait au moins une vulnérabilité de haute gravité, y compris des failles XSS ou d'injection SQL.
Sans garde-fous solides, sans contexte réel et sans schémas de revue clairs, l'IA peut discrètement accroître votre surface d'attaque tout en aidant à livrer des fonctionnalités plus rapidement. Le problème n'est pas l'IA dans le cycle de développement logiciel. Le problème, c'est que la couche autour de l'IA compte autant que l'IA elle-même.
Le schéma est le même pour ces trois lacunes. Les assistants de codage excellent dans la partie du travail qui était déjà mécanisée dans le cerveau de chacun. Ils sont moins utiles pour la partie qui exige de comprendre le reste du système — c'est-à-dire l'essentiel du travail.
Pourquoi le goulot d'étranglement est passé de la création de code à l'assemblage du contexte
Pendant des décennies, le facteur limitant pour livrer du logiciel était la vitesse à laquelle un ingénieur pouvait transformer une intention en code. Cette équation a changé.
Dans de nombreuses organisations — en particulier celles nativement conçues autour de l'IA — les ingénieurs seniors ont cessé d'écrire du code ligne par ligne. Ils définissent l'intention, fixent les contraintes et examinent les diffs pendant que les systèmes prennent en charge une grande partie du travail mécanique.
Le véritable goulot d'étranglement n'est plus la vitesse à laquelle quelqu'un peut produire du code. C'est la rapidité avec laquelle il peut assembler le bon contexte, les bons garde-fous et les bons workflows autour de ce code pour qu'il soit correct, sûr et aligné avec la bonne architecture.
Observez où va réellement le temps d'un ingénieur au cours d'une journée type.
Ouvrir un ticket Jira. Passer au document de conception lié dans le ticket.
Passer au fil Slack où les compromis ont été discutés.
Passer au runbook du service.
Passer à un post-mortem d'un incident passé.
Passer à GitHub pour trouver la dernière personne qui a touché à ce chemin de code.
Revenir à l'IDE pour écrire effectivement la modification. Puis revenir au fil de revue de la PR une fois la modification intégrée.
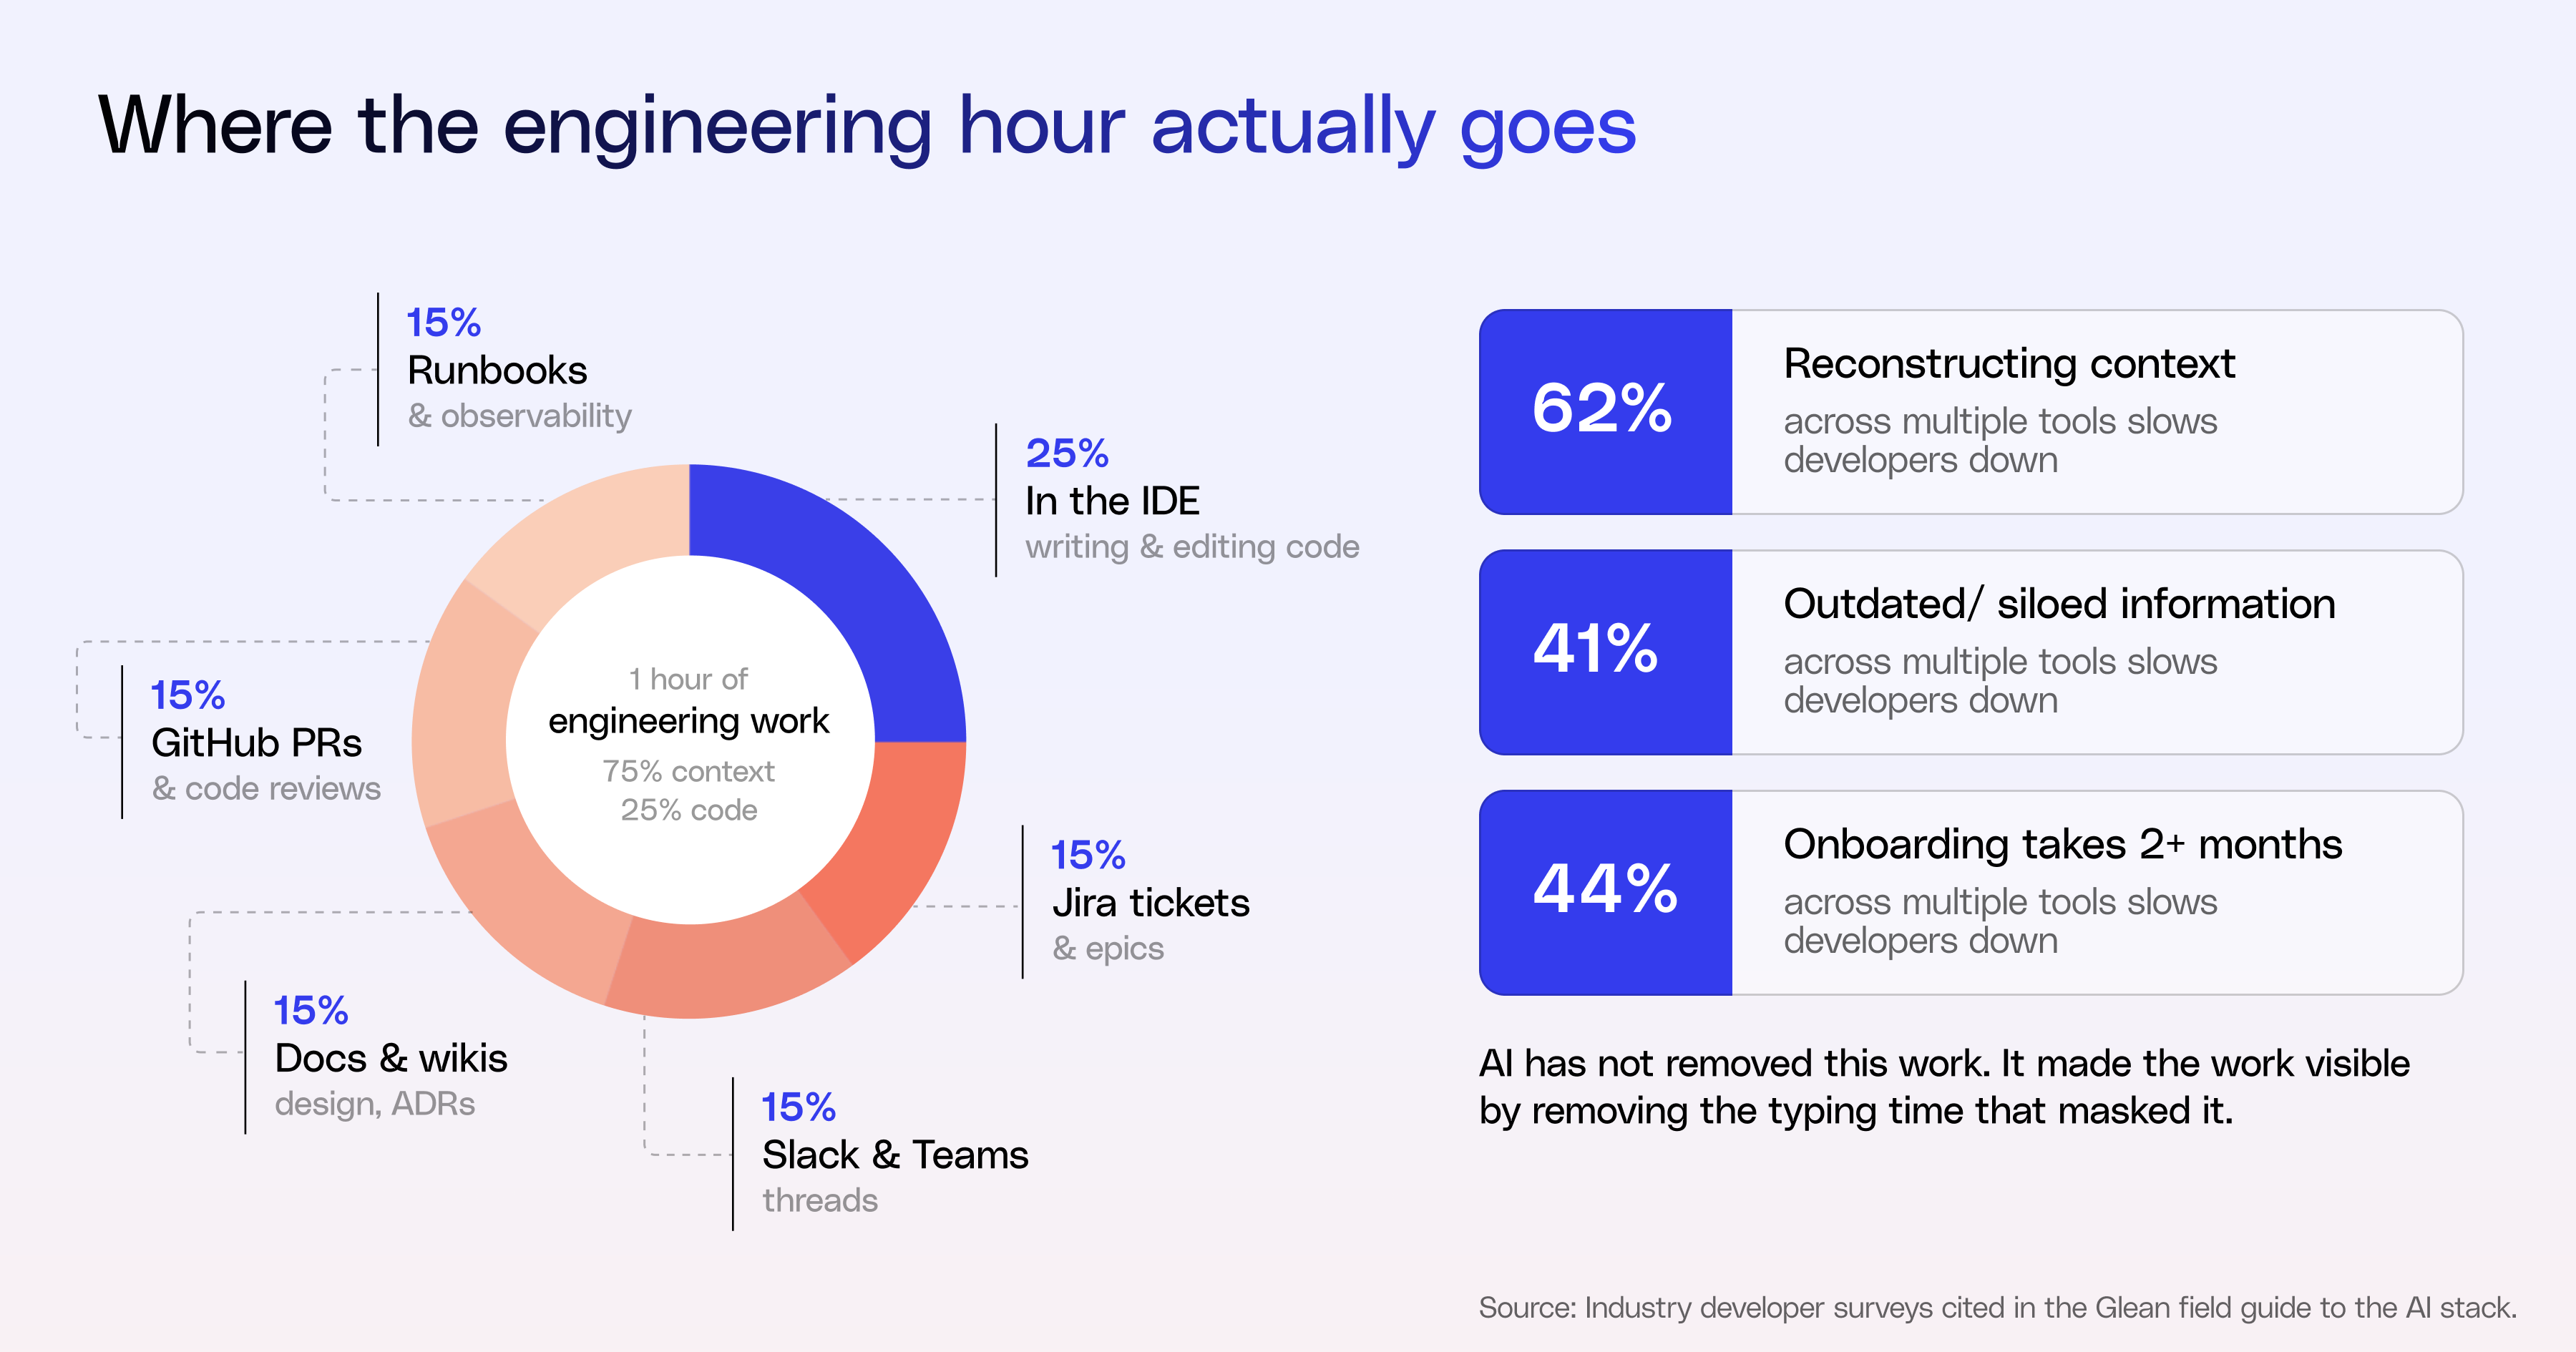
L'IDE n'est qu'un onglet dans une chaîne de cinq ou six. L'assistant de codage vit dans cet unique onglet. Il ne peut pas voir le reste de la chaîne. Lorsqu'il génère une suggestion de code, il raisonne à partir du fichier qui se trouve devant lui — et non du ticket qui explique pourquoi la modification existe, de la décision de conception qui a écarté trois autres approches, ou de l'incident du trimestre dernier qui explique un commentaire crucial dans le code hérité.
Cette lacune apparaît dans les données. 62 % des développeurs affirment que la reconstruction du contexte entre plusieurs outils les ralentit. 41 % identifient les informations obsolètes, incohérentes ou cloisonnées comme leur plus grand frein à la productivité. 44 % des organisations rapportent que l'intégration de nouveaux développeurs prend plus de deux mois, et ce temps est consacré presque entièrement à l'assemblage du contexte — trouver les bons documents, les bonnes personnes, les bonnes décisions passées.
L'IA n'a pas supprimé ce travail. Dans bien des cas, elle l'a rendu plus visible en éliminant le temps de saisie qui le masquait auparavant. Résultat : c'est la friction, et non les fonctionnalités, qui constitue le véritable frein.
Le modèle à deux couches : surfaces de codage et surfaces de contexte
Si vous observez l'ensemble des outils d'IA de la stack d'ingénierie moderne, un schéma se dégage.
Un premier groupe d'outils correspond à l'endroit où les ingénieurs réalisent leur travail. Les IDE, les hébergeurs de code, Jira, le chat, les environnements de codage par IA comme Cursor ou Claude Code. Ce sont les surfaces où l'intention devient du code modifié.
Un autre groupe se concentre sur la compréhension du travail. Ces outils rassemblent code, tickets, incidents, documents, logs et personnes en une image cohérente. Ils répondent à des questions telles que : comment nos services sont-ils reliés entre les équipes et les dépôts ? Quels incidents, tickets et documents de conception sont liés à ce changement ? Qui détient aujourd'hui ce système, et quelles contraintes avons-nous convenues ?
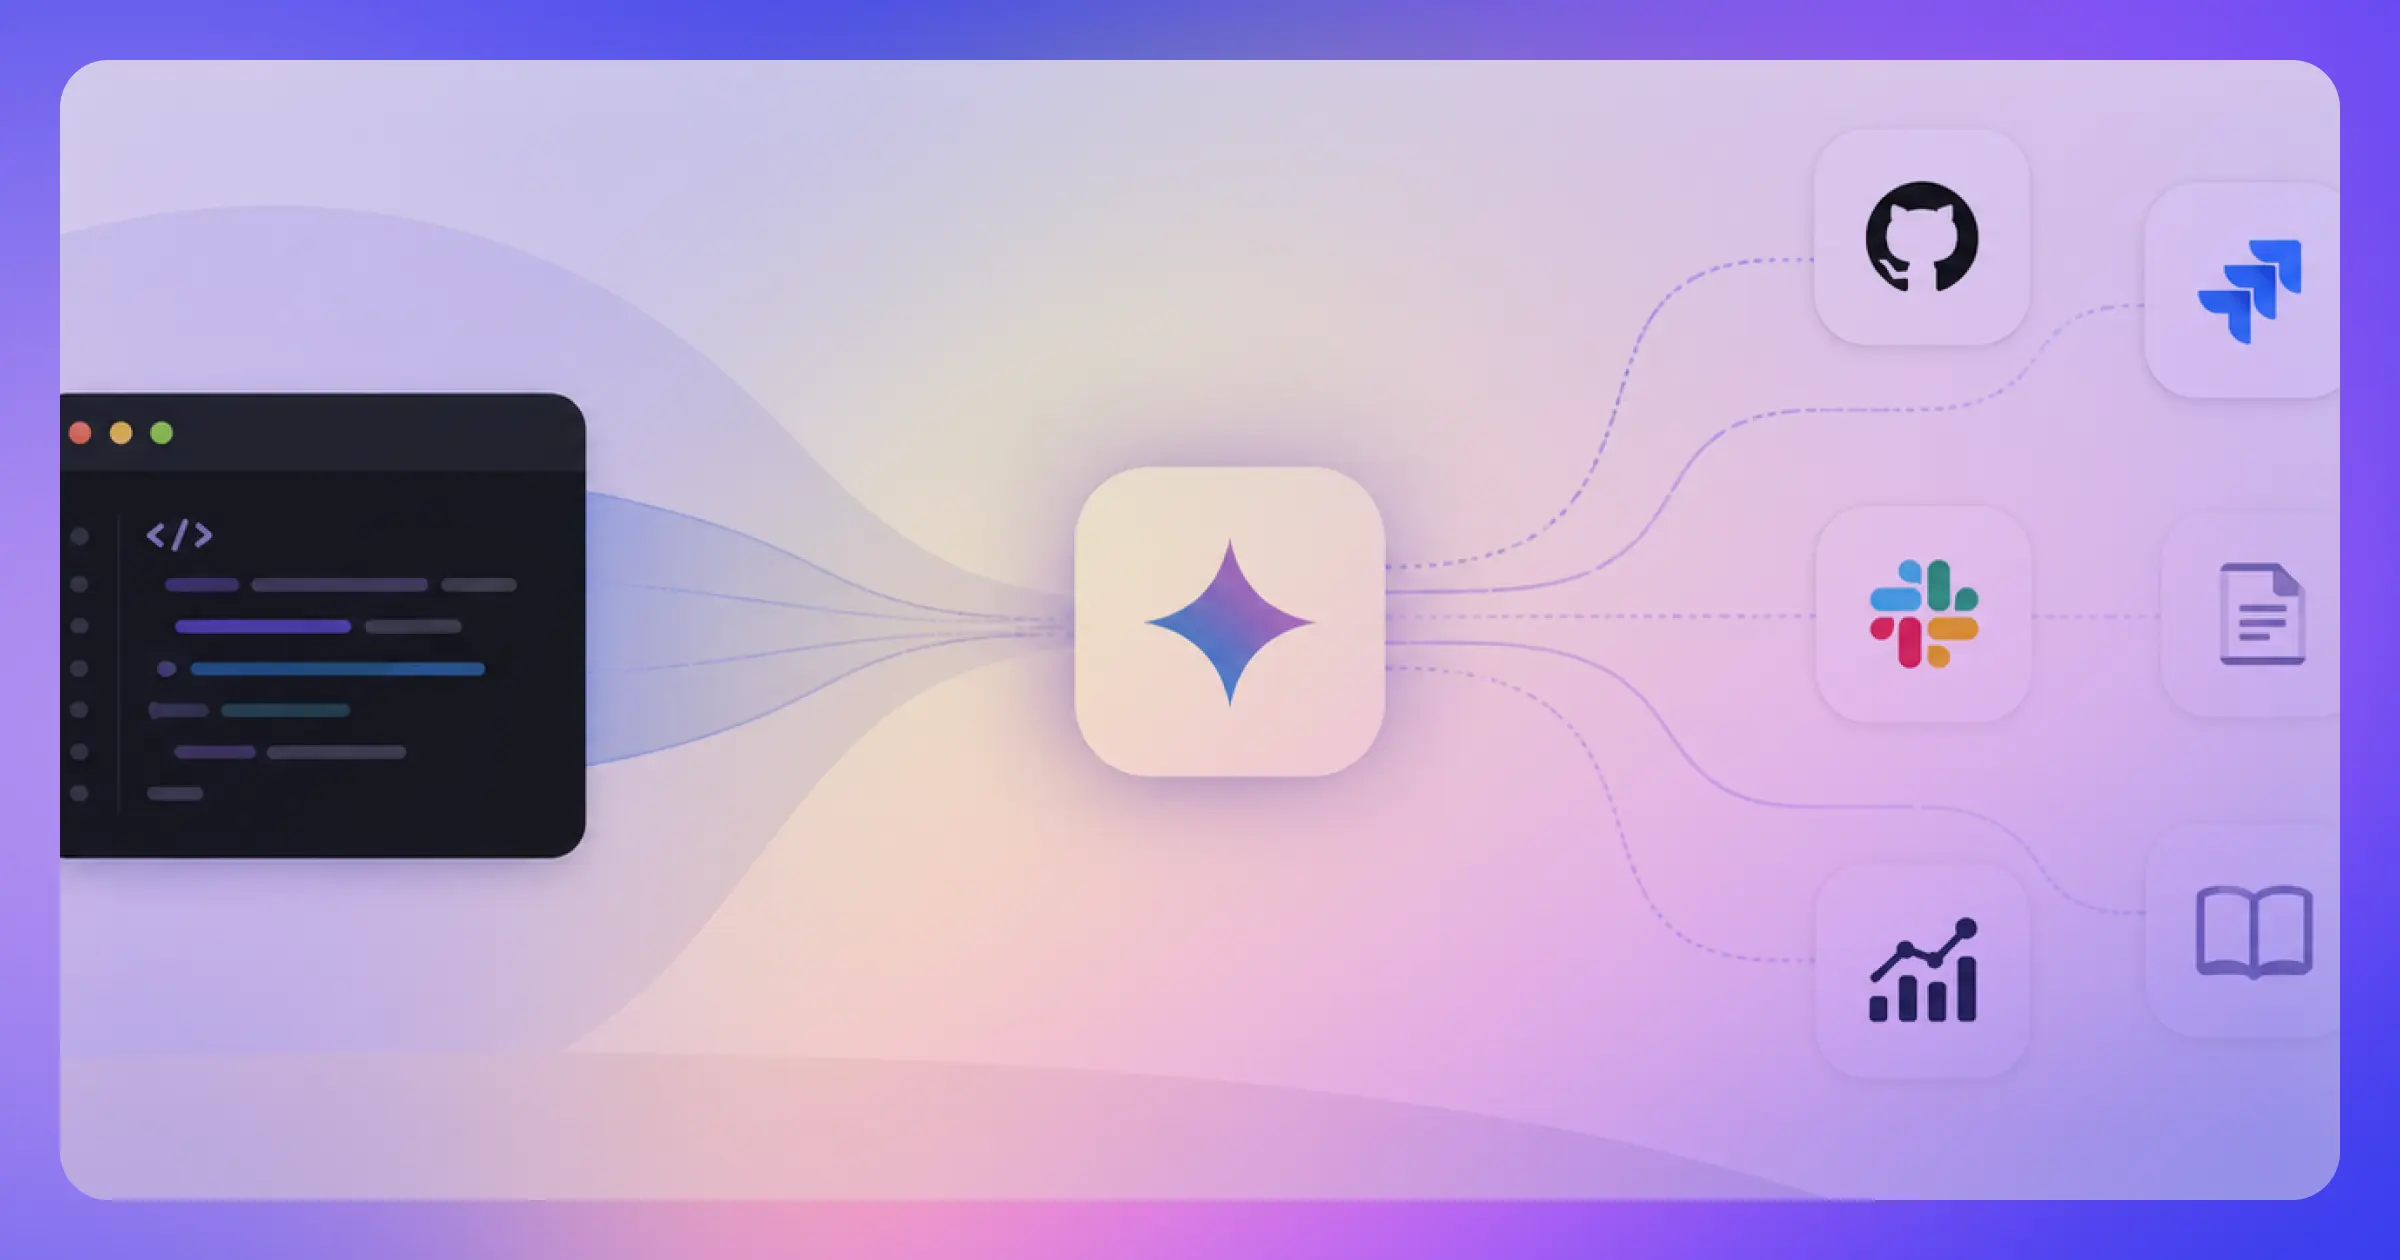
Pour de nombreuses équipes, cette répartition du travail conduit à la formation d'un modèle à deux couches : une couche de codage en surface, une couche de contexte en dessous.
La couche de contexte se connecte aux principaux systèmes
GitHub ou GitLab et d'autres hébergeurs, Jira, les outils d'incident, les plateformes d'observabilité, les wikis, les référentiels de documents, Slack ou Teams, et bien plus encore. Elle indexe le code et les documents grâce à une recherche hybride — lexicale et sémantique — afin de comprendre votre stack, vos conventions de nommage et votre jargon.
Elle construit un graphe d'entreprise qui relie services, API, incidents, tickets, propriétaires et artefacts de conception, au lieu de traiter tout comme du texte brut. Et elle respecte les frontières de sécurité et de gouvernance de bout en bout : ACL des systèmes sources, résidence des données, auditabilité.
La couche de codage est l'endroit où les ingénieurs passent l'essentiel de leur temps au quotidien.
Les IDE et les environnements de codage orientés IA, GitHub et d'autres hébergeurs de code, Jira et le suivi des tâches, Slack et Teams. Ces surfaces offrent des capacités et une automatisation puissantes, mais elles ne peuvent exploiter le contexte d'entreprise existant que si ce contexte est réapprovisionné et réinventé pour chaque requête.
Les plateformes conçues pour la couche de contexte — comme Glean — se connectent aux principaux systèmes d'ingénierie et exposent un graphe d'entreprise sensible aux autorisations que d'autres outils d'IA peuvent interroger. Deux des trois principales organisations d'assistants de codage s'appuient sur Glean pour alimenter la couche de contexte derrière leurs outils d'ingénierie.
Pourquoi cette distinction est-elle importante : les surfaces de codage excellent dans la génération et l'édition locales, mais elles sont construites autour du fichier ou du dépôt. Une couche de contexte dédiée permet aux équipes de conserver les éditeurs auxquels elles font déjà confiance tout en gagnant la compréhension inter-systèmes qui leur manque.
Vous indexez une seule fois. Vous réutilisez ce contexte sur tous les outils et toutes les surfaces.
Vous voulez le framework complet ? Le guide pratique de Glean sur la stack d'IA présente le modèle à deux couches, la grille d'évaluation à quatre questions et les cinq priorités pour les responsables de l'ingénierie qui déploient l'IA dans le SDLC.
Lire le guide pratique →
Comment se concrétise le modèle à deux couches : intégration, codage quotidien et incidents
Le modèle à deux couches n'est pas un cadre abstrait. Il transforme trois workflows où les ingénieurs passent l'essentiel de leurs heures.
Intégration et compréhension des services.
La propriété change en permanence. De nouvelles recrues arrivent, les équipes se réorganisent, les services survivent à leurs auteurs d'origine. Les informations dont un nouvel ingénieur a besoin pour monter en compétence sont généralement dispersées entre d'anciens documents de conception et ADR, des tickets et épopées Jira, des PR et des revues de code, des rapports d'incident et des runbooks, des fils de discussion Slack et des chaînes d'e-mails.
Près de la moitié des organisations déclarent que l'intégration prend plus de deux mois. Lorsque les développeurs utilisent des outils d'IA avec une véritable couche de contexte en dessous, 43 % affirment que le temps d'intégration tombe à moins d'un mois.
Avec Glean Search et Glean Chat reposant sur le Graphe d'entreprise, un nouvel ingénieur peut demander « donne-moi un aperçu du service de paiement et relie les principaux documents de conception » et obtenir une réponse assemblée à partir du code, des tickets, des incidents et de la propriété — et non uniquement à partir de ce qui correspond au mot-clé « paiement » dans les commentaires du code.
Codage quotidien et changements de routine.
Une grande partie du temps d'ingénierie se perd dans des tâches de routine : ajustements de configuration, corrections mineures de bugs, refactorisations incrémentales qui maintiennent les systèmes en bonne santé mais détournent l'attention de projets plus importants. Les assistants de codage intégrés aux IDE sont déjà performants dans ce domaine.
Associés à la recherche de code et à des agents capables d'écrire du code, ils peuvent même proposer des modifications ciblées directement à partir d'un ticket Jira ou d'un fil Slack, au lieu de partir d'un éditeur vierge. Les équipes qui obtiennent des résultats prêts pour la production font un pas de plus : elles définissent des classes de changements claires pour lesquelles l'IA est autorisée à proposer des modifications — changements de niveau de log, certaines mises à jour de configuration, refactorisations sans impact comportemental, documentation et tests — et elles traitent les commentaires, les documents de conception et les tickets liés issus de la couche de contexte comme des garde-fous.
Les suggestions correspondent aux exigences et contraintes réelles, et non à des schémas génériques que le modèle a déjà vus.
Incidents et support en production.
Pendant un incident, les ingénieurs jonglent entre alertes, tableaux de bord, logs, runbooks, Jira et Slack tout en essayant de répondre à trois questions fondamentales : qu'est-ce qui a changé, qu'est-ce qui est cassé et qui doit être impliqué. Le simple fait de changer de contexte ralentit tout.
79 % des équipes d'ingénierie explorent déjà l'IA pour les tâches de suivi des incidents. Avec une plateforme de contexte sous-jacente, Glean Agents peut synthétiser les alertes, traces et logs en un récit cohérent, rassembler les tickets associés, les modifications de code récentes, les incidents passés et les responsables dans une vue unique, et rédiger les premières versions de chronologies, de post-mortems et de communications aux clients à partir d'événements et d'artefacts réels.
La distinction entre les deux couches est ici la plus facile à percevoir. Les outils d'observabilité fournissent les signaux bruts — métriques, traces, logs. Les assistants de code aident à proposer et à appliquer des correctifs au niveau du code une fois que vous savez ce qui ne va pas. La couche de contexte relie les points entre les systèmes afin que l'assistant ne devine pas à partir des données d'un seul outil.
Dans ces trois workflows, l'assistant de code a son importance. Il en a encore plus lorsqu'il fait appel à une couche qui connaît déjà le reste du système.
Quatre questions à se poser avant d'ajouter un nouvel outil d'IA

Pour passer de l'expérimentation à une approche que vous pouvez standardiser, il est utile de disposer d'un ensemble commun de questions d'évaluation. Elles reviennent régulièrement dans les échanges avec les responsables de l'ingénierie.
1. De quel contexte dispose-t-il réellement ?
La plupart des outils affirment être « context-aware ». La vraie question est : un contexte portant sur quoi ?
Voit-il uniquement le dépôt ou le buffer actuel, ou peut-il aussi voir les tickets, incidents, documents de conception et runbooks associés ?
Peut-il suivre une chaîne comme alerte Slack → ticket d'incident → modifications de code pertinentes → responsables → incidents passés, ou faut-il encore que quelqu'un relie tout cela à la main ?
Comment se comporte-t-il avec les monorepos, plusieurs hôtes de code et les stacks polyglottes — a-t-il été testé à cette échelle, ou s'agit-il de « travaux futurs » ?
Si l'outil ne peut pas voir le même graphe que celui sur lequel raisonnent vos ingénieurs, il donnera des réponses superficielles ou trompeuses.
2. Comment la confiance se gagne-t-elle, plutôt que de se présupposer ?
Les ingénieurs ne feront pas confiance à un système qui se comporte comme une boîte noire, aussi soignée que soit l'interface. Les réponses sont-elles ancrées dans vos propres artefacts — code, tickets, logs — avec des liens permettant d'en inspecter la source ?
Les résultats sont-ils cités et explicables, ou ressemblent-ils à un mur de texte qu'il faut revalider manuellement ?
Que se passe-t-il en cas de mauvaise entrée ou de cas limites dans les workflows d'incident et de changement — échoue-t-il de façon sûre et visible, ou hallucine-t-il discrètement ?
Si les gens doivent refaire le travail pour le vérifier, vous n'obtiendrez pas une véritable adoption.
3. Où vont vos données, et qui peut agir dessus ?
Dès lors que l'IA peut lire le code, les logs et les tickets — et surtout dès qu'elle peut prendre des mesures —, vous prenez une décision de sécurité et de gouvernance, et pas seulement une décision d'outillage.
Où les index de code et de documents sont-ils hébergés : votre tenant, le multi-tenant du fournisseur, autre chose ?
Le code et les logs restent-ils au sein de votre VPC ou de votre compte cloud, et existe-t-il des contrôles d'egress stricts sur ce que les agents et les générateurs de code peuvent envoyer à des modèles externes ?
Toutes les requêtes et actions sont-elles journalisées d'une manière que votre équipe de sécurité peut exploiter pour la revue et la réponse aux incidents ? Si vous ne pouvez pas répondre clairement à ces questions, votre équipe de sécurité bloquera — ou devrait le faire.
4. S'intègre-t-il à la façon dont vos équipes travaillent déjà ?
Les meilleurs outils s'effacent dans les workflows existants. Les pires demandent aux ingénieurs de vivre dans un nouvel onglet. S'intègre-t-il proprement avec GitHub ou GitLab, Jira, votre stack d'observabilité et Slack ou Teams, ou n'est-ce qu'une interface déconnectée de plus ?
Peut-il coexister avec les copilotes d'IDE — via MCP ou un mécanisme similaire — en les utilisant pour l'édition tandis qu'il fournit la couche de contexte partagée ?
Ou faut-il tout remplacer ? Le serveur MCP de Glean est conçu pour ce modèle de coexistence : Cursor, GitHub Copilot et Claude Code peuvent faire appel à la même couche de contexte gouvernée sans que les ingénieurs quittent leur éditeur. Si la réponse à « où les ingénieurs y toucheraient-ils au quotidien ? » n'est pas claire, l'outil finira comme un pilote, et non comme un élément de votre SDLC.
Ces quatre questions valent pour les assistants de code, les modules complémentaires d'observabilité, les frameworks d'agents et les plateformes de contexte. C'est une façon de tester si un outil améliorera réellement la façon dont vos systèmes sont construits et exploités — ou s'il ajoutera simplement une couche de complexité supplémentaire.
La prochaine course n'est pas à plus de copilotes. C'est à la couche sous-jacente.
Il y a un an, la conversation dans la plupart des organisations était : « avons-nous de l'IA dans l'IDE ? » Dans la plupart des cas, la réponse est oui — à plusieurs reprises. Cursor, GitHub Copilot, Claude Code et d'autres sont désormais la norme. La nouvelle conversation est différente. Elle est : « le reste du système prend-il en charge ce que ces outils font ? »
Pour les équipes qui obtiennent un véritable ROI, la réponse converge vers une couche de contexte partagée située sous les surfaces de code. Glean est conçu pour cette couche. Il unifie le code, les tickets, les logs, les docs, les incidents et les discussions issus d'outils comme GitHub, GitLab, Jira, les plateformes d'observabilité, les wikis, les référentiels de documents et Slack ou Teams au sein d'un unique Enterprise Graph, respectueux des permissions et toujours à jour.
Ce graphe est accessible depuis l'éditeur — via la recherche, Glean Chat, Glean Agents et les outils compatibles MCP — de sorte que les assistants de code peuvent faire appel à la même source de vérité que vos équipes de sécurité et de plateforme ont approuvée. Les résultats clients confirment ce modèle. LinkedIn économise 2,4 M$ par an grâce à un agent Threat-bot propulsé par Glean. Les équipes d'Uber livrent du code 20 % plus vite après avoir placé Glean sous leurs workflows d'ingénierie.
Un exemple concret :
Un grand distributeur de produits de bricolage a mesuré une hausse de 5,3 % de la productivité des développeurs. Un seul agent déployé au sein de l'équipe d'ingénierie de Glean a permis de récupérer plus de 17 000 heures d'ingénierie par an et un ROI de plus de 1,7 M$. Ce ne sont pas des chiffres au stade pilote. C'est ce qui se produit lorsque l'IA est intégrée à une base stable de contexte et de sécurité plutôt que greffée sur des outils individuels.
La répartition des tâches devient simple. Les assistants de code restent concentrés sur l'édition et la génération locales au sein de l'IDE. La couche de contexte fournit la vue gouvernée, à l'échelle de l'organisation, de l'environnement d'ingénierie, accessible depuis l'éditeur lorsque c'est nécessaire.
Dans la pratique, cela ressemble à un Glean Agent transformant un bug Jira ou un fil Slack en une PR d'implémentation ciblée que les développeurs affinent et enrichissent avec leur assistant de code préféré. Ou au débogage d'un problème en production dans Cursor ou Claude Code, l'assistant appelant Glean via MCP pour intégrer les incidents récents, les tickets Jira, la propriété et les documents de conception, puis proposant un correctif tenant compte du contexte sans quitter l'éditeur.
C'est ce qui donne à l'IA l'impression de faire partie de la stack plutôt que d'un module annexe : une base stable de contexte et de sécurité sur laquelle plusieurs assistants et agents peuvent s'appuyer, tout en laissant les développeurs libres de conserver les outils auxquels ils font déjà confiance.
Pour les responsables d'ingénierie souhaitant prendre une longueur d'avance, cinq priorités méritent attention lors de la mise en œuvre de l'IA.
- Commencez à mesurer l'impact en termes de temps de cycle et de qualité, et non simplement du nombre de développeurs ayant installé un assistant de code.
- Concentrez les investissements en IA sur la réduction des transferts et des reprises entre systèmes, et pas uniquement sur une génération de code plus rapide dans un seul outil.
- Priorisez la sécurité, la gouvernance et la transparence avant la mise en œuvre et l'adoption. La confiance et la sûreté sont des prérequis pour l'IA, et non une réflexion après coup à corriger.
- La prolifération du SaaS est arrivée en premier. La prolifération de l'IA suivra. Gardez l'évolutivité à l'esprit lorsque vous recherchez des solutions. Recherchez des plateformes ouvertes qui vous permettent d'appliquer du contexte, de maintenir la visibilité et de faire respecter les politiques sur l'ensemble de vos outils d'IA actuels et futurs.
- Reliez le contexte élargi et votre organisation dans son ensemble au travail que vous réalisez. Rassembler les bonnes données est la clé d'une meilleure création de code. Trouvez des systèmes de contexte adaptés à votre SDLC et à votre stack.
La course n'est plus « à quelle vitesse pouvons-nous ajouter un autre outil d'IA ? ». Elle est désormais : « pouvons-nous concevoir une stack d'IA qui corresponde à la façon dont nos ingénieurs travaillent réellement, qui nous laisse le contrôle de nos systèmes et de nos données, et qui offre à chaque outil la même vue fiable de notre environnement ? ».
{{richtext-banner-component}}
Questions fréquentes
Quel est le plus grand frein à la productivité des ingénieurs logiciels utilisant des outils d'IA ?
Le plus grand frein n'est pas la lenteur de la génération de code — c'est la reconstruction du contexte entre plusieurs outils. 62 % des développeurs citent cela comme un ralentissement majeur, et 41 % désignent des informations obsolètes, incohérentes ou cloisonnées comme leur principal frein à la productivité. Les assistants de code ne comblent pas ce manque, car ils ne voient que le fichier ou le dépôt affiché devant eux.
Pourquoi les développeurs sont-ils plus lents avec les assistants de code IA dans certaines études ?
Lors d'un essai contrôlé, des développeurs expérimentés utilisant des outils d'IA ont été 19 % plus lents sur des tâches qu'ils s'attendaient à accomplir 24 % plus vite. L'assistant propose du code en permanence, de sorte que le travail paraît plus rapide, mais les suggestions passent souvent à côté de contraintes issues des tickets, des designs et d'autres services. Le temps de frappe économisé revient plus tard sous forme de reprises et d'efforts d'intégration.
Qu'est-ce que la stack d'IA à deux couches pour l'ingénierie logicielle ?
Le modèle à deux couches divise la stack d'IA d'ingénierie en surfaces de codage — IDE, hébergeurs de code, Jira, chat et environnements de codage IA — et une couche de contexte sous-jacente qui relie code, tickets, incidents, documents, logs et personnes en un graphe unique tenant compte des autorisations. La couche de codage gère la génération locale. La couche de contexte gère la compréhension inter-systèmes.
Comment Glean s'intègre-t-il avec des outils comme GitHub Copilot, Cursor et Claude Code ?
Glean est conçu pour fonctionner aux côtés des assistants de code que les ingénieurs utilisent déjà, et non pour les remplacer. Les assistants de code restent concentrés sur l'édition et la génération locales au sein de l'IDE. Glean fournit la couche de contexte gouvernée, à l'échelle de l'organisation — accessible depuis l'éditeur via la recherche, Glean Chat, Glean Agents et un serveur MCP — afin que les assistants puissent intégrer tickets, incidents, propriété et documents de conception sans quitter l'IDE.