






Pour créer des agents capables d'agir de manière fiable en entreprise, il faut des systèmes qui reflètent la façon dont les humains donnent du sens à l'information — en reliant ce qu'ils lisent aux personnes, processus, outils, projets et stratégies qui les entourent. Ces associations viennent naturellement aux humains ; c'est ainsi que nous décortiquons la complexité et les informations contradictoires pour prendre des décisions. Pour que les LLM fassent de même, ils doivent non seulement raisonner comme des humains, mais aussi utiliser les connaissances comme des humains. C'est pourquoi le socle de tout grand moteur agentique est un graphe de connaissances qui fournit aux modèles le bon contexte.
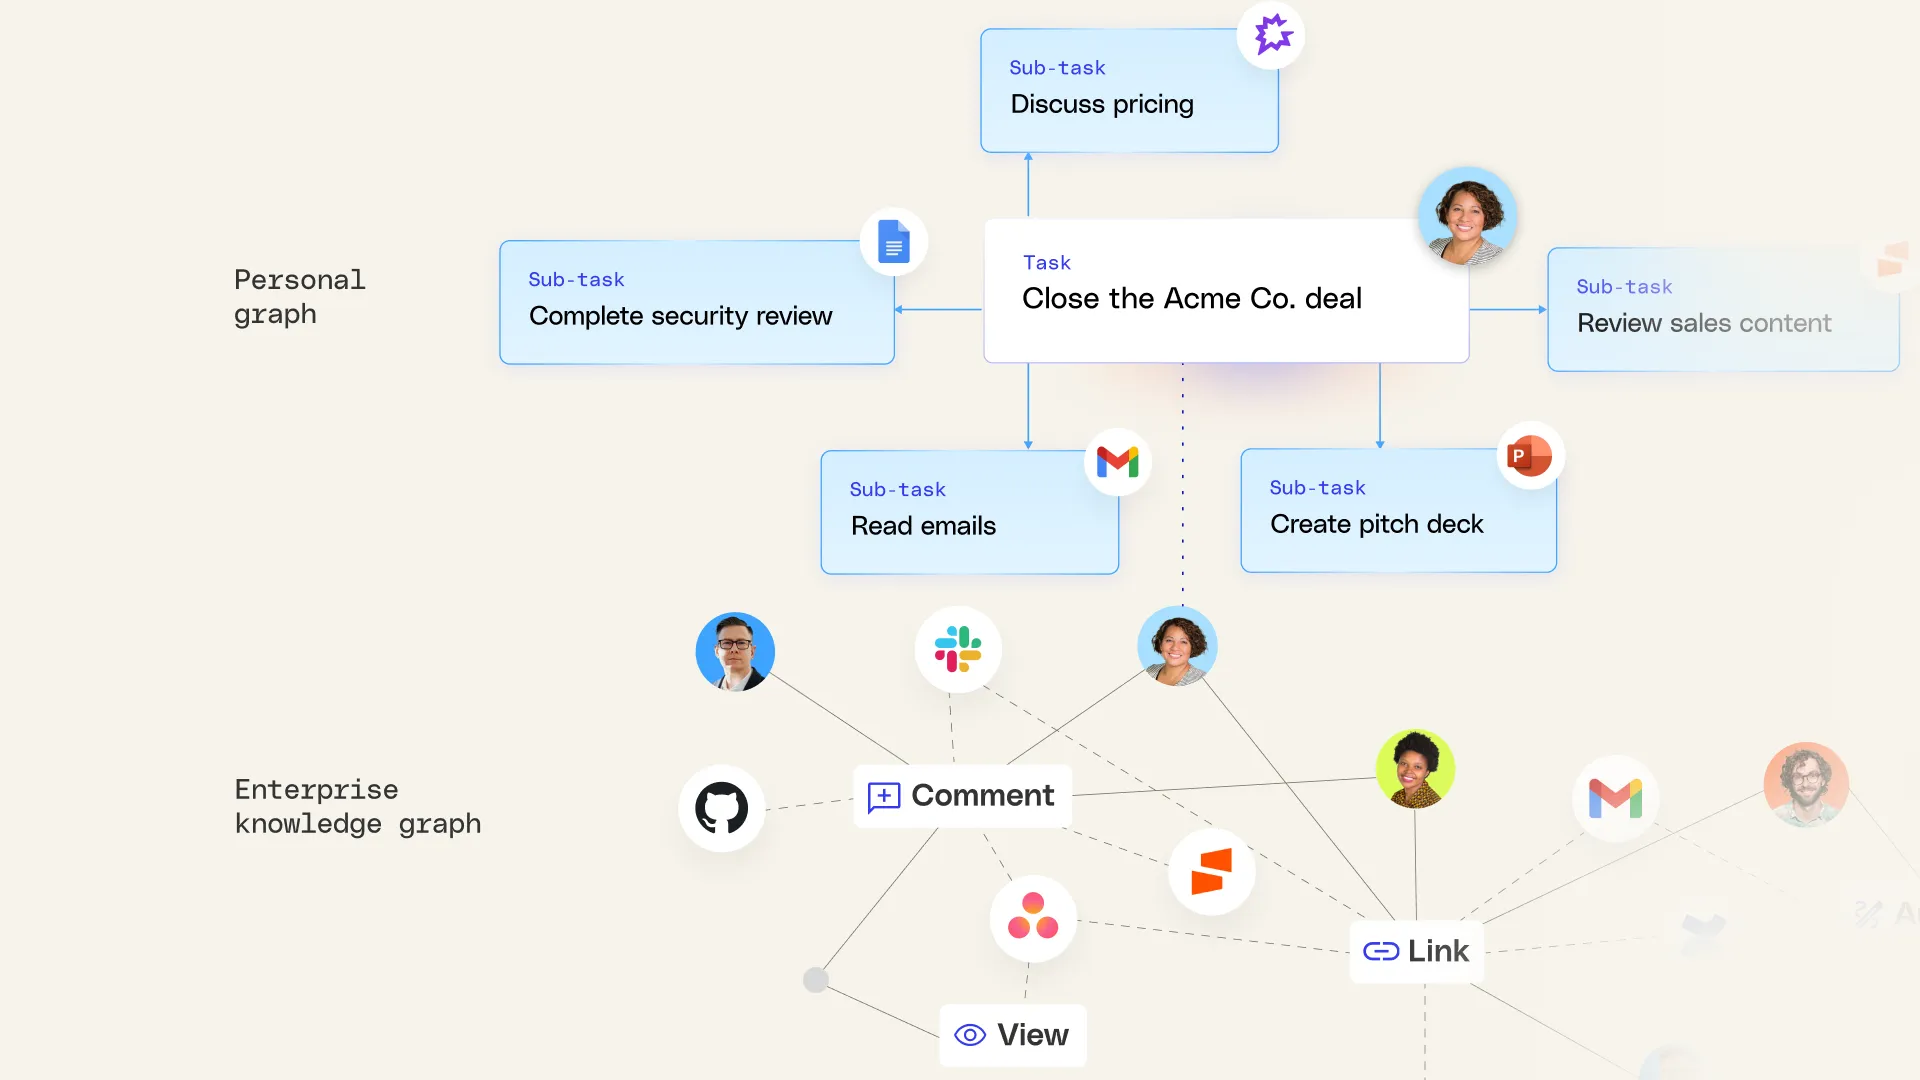
Chez Glean, nous avons enrichi notre graphe de connaissances d'une nouvelle couche — un graphe personnel — qui comprend mieux le contexte humain au travail. Il va au-delà de l'historique des conversations en comprenant votre approche des différents types de travail et en adaptant l'IA en conséquence. Ensemble, ces graphes, associés à l'architecture de recherche hybride de Glean, forment le système de contexte : un reflet du mode de fonctionnement de chaque organisation qui permet à l'IA de mieux servir chacun de ses membres.
Qu'est-ce qu'un graphe de connaissances ?
Un graphe de connaissances est une représentation structurée de l'information qui capture les entités et les relations entre elles dans un format lisible par machine. Dans le contexte de l'entreprise, les graphes de connaissances constituent une couche d'abstraction fondamentale qui relie des données fragmentées — couvrant les personnes, documents, outils, projets et systèmes — en un réseau cohérent. Contrairement aux index de recherche, les graphes de connaissances se concentrent non seulement sur le contenu, mais aussi sur les relations, comme celles entre les clients et les tickets d'assistance, ce qui les rend particulièrement adaptés pour ancrer les systèmes d'IA d'entreprise dans une connaissance contextuelle.
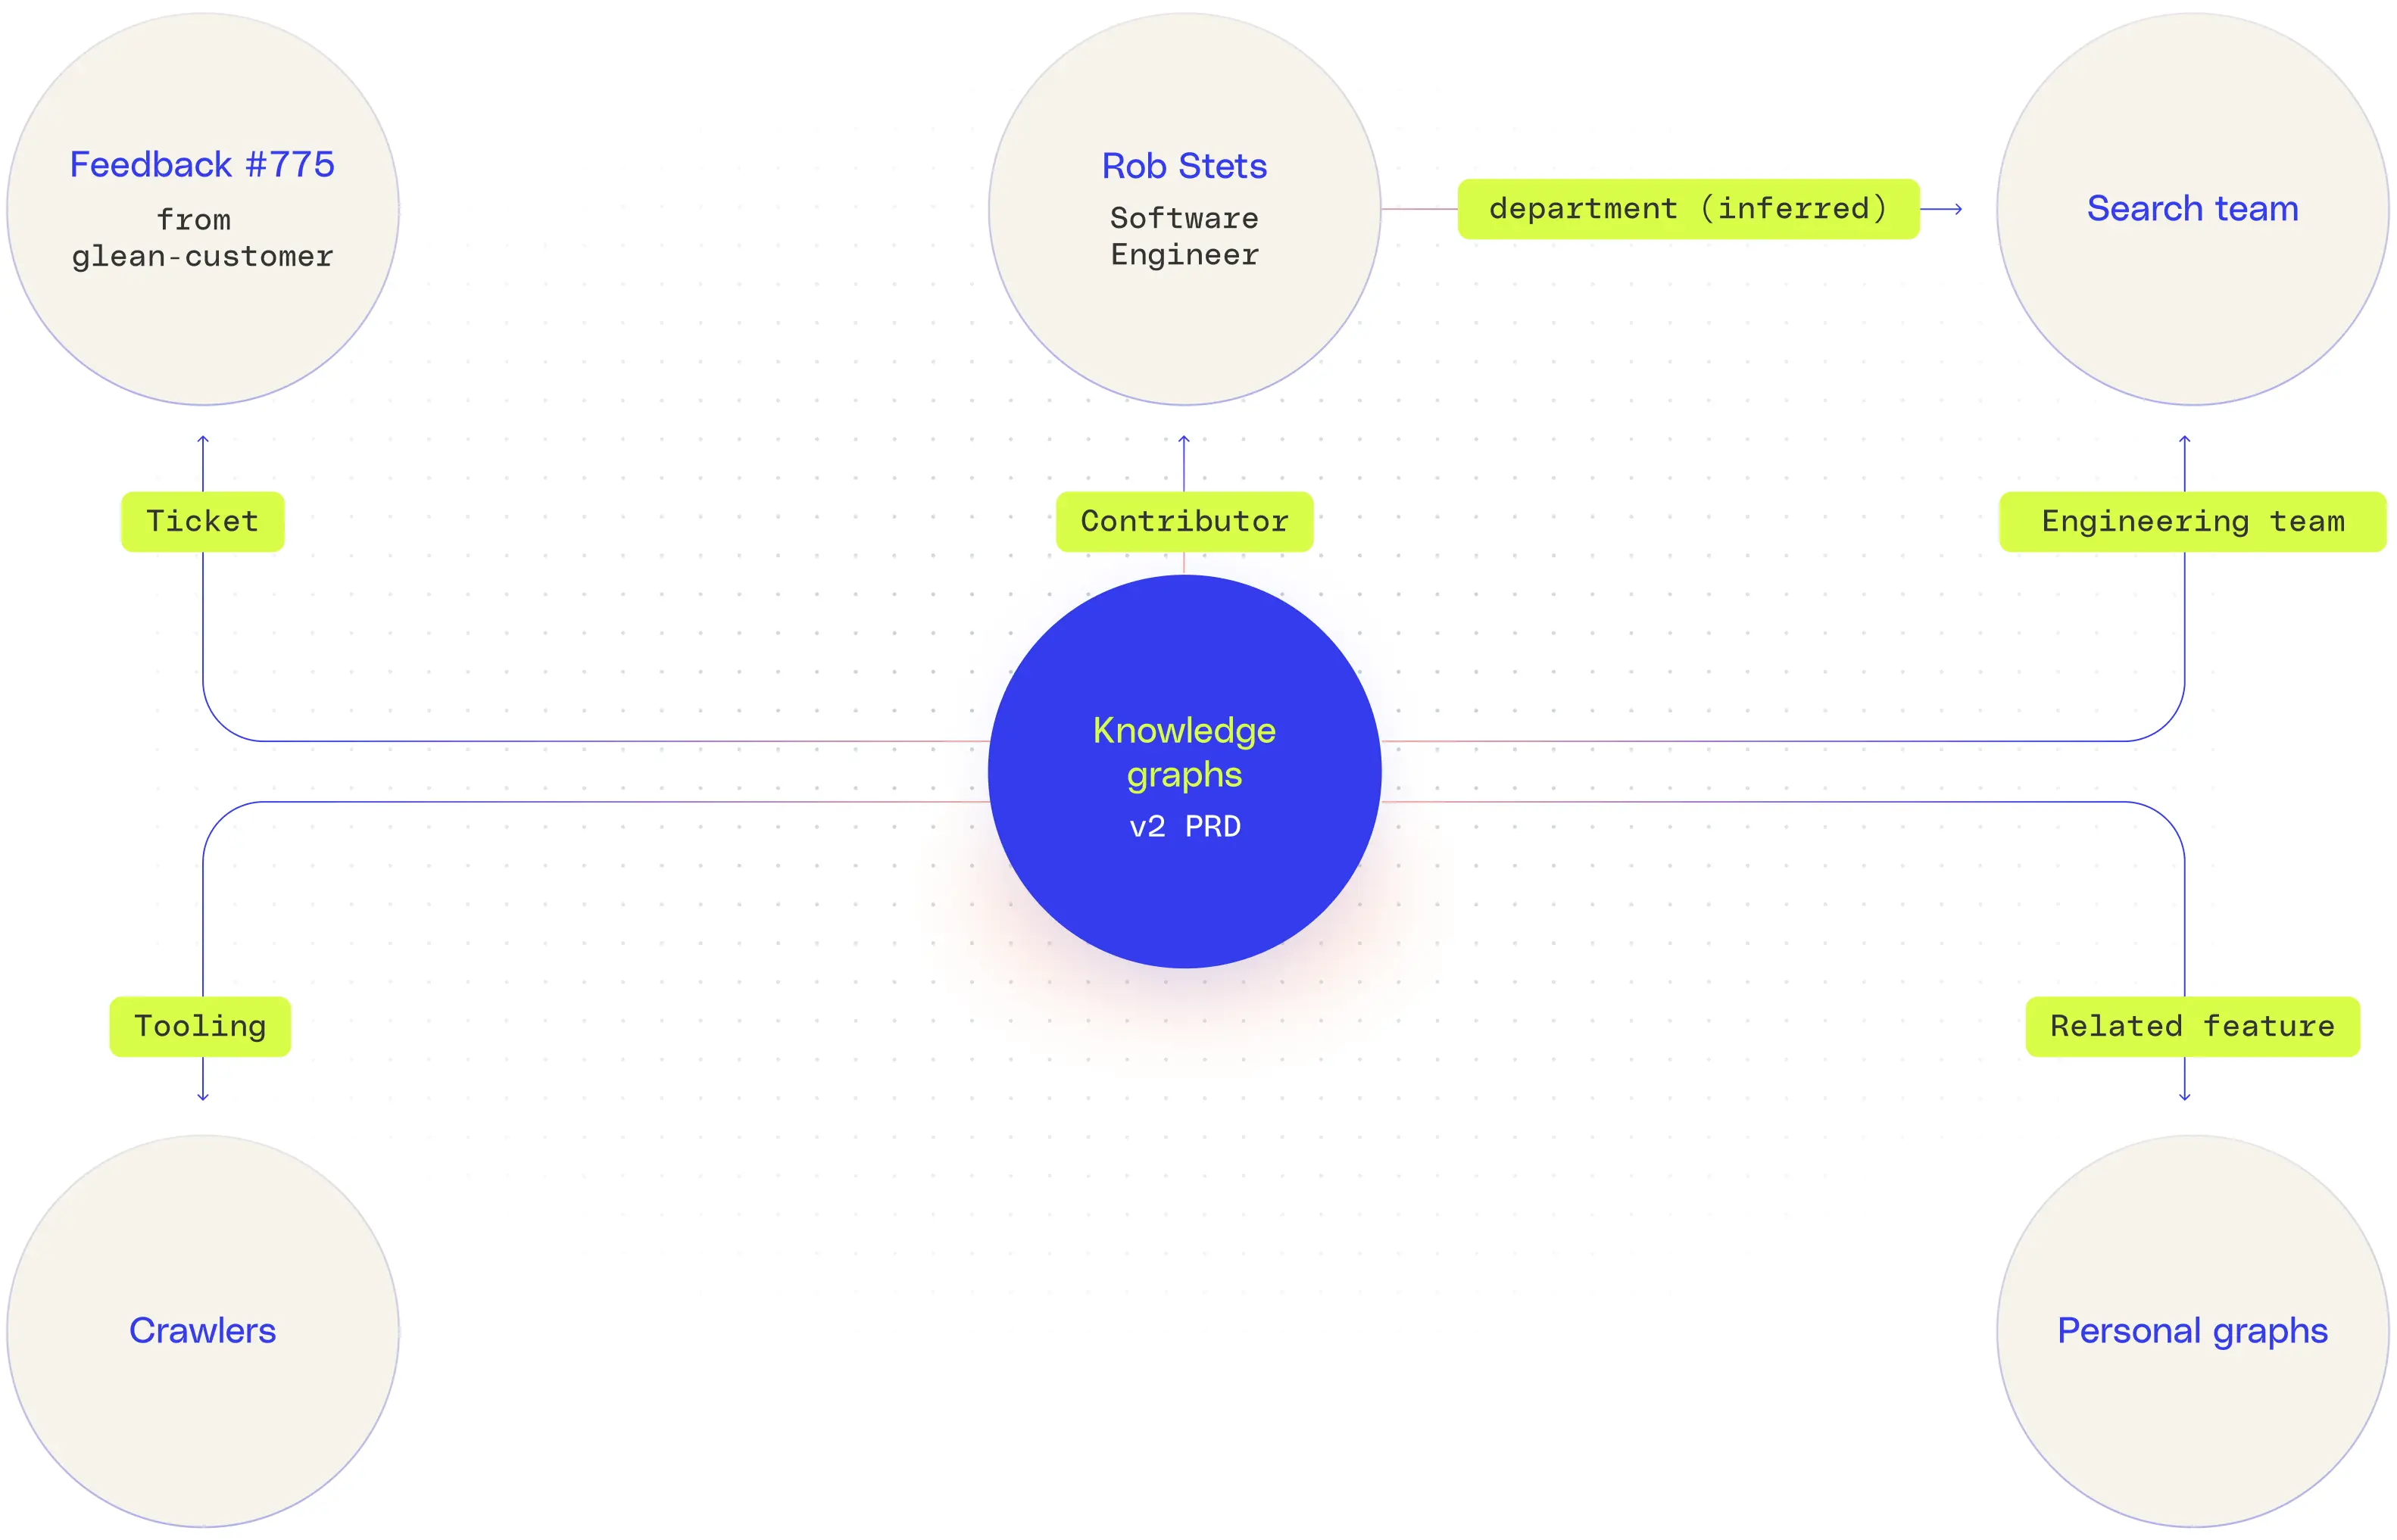
Au cœur d'un graphe de connaissances se trouve la structure en triplet : (sujet, prédicat, objet). Celle-ci encode des faits ou des relations spécifiques, tels que (Ingénieur A, possède, Ticket Jira B) ou (Document X, référence, Projet Y). Ces triplets sémantiques forment les arêtes d'un graphe, que l'on peut parcourir pour déduire des connaissances supplémentaires ou résoudre des requêtes complexes. Dans les scénarios d'entreprise, cela permet de faire émerger des informations nuancées à travers les silos organisationnels — comme identifier comment le lancement d'un produit est lié aux documents de feuille de route, aux contributeurs, aux cas d'assistance et aux retours clients.
L'expressivité d'un graphe de connaissances inclut des faits supplémentaires en plus des relations. Des propriétés d'arête — telles que les horodatages, le contrôle d'accès, les scores de confiance ou la provenance — peuvent être attachées à chaque relation, permettant aux systèmes de raisonner avec des métadonnées essentielles pour la gouvernance d'entreprise. Par exemple, le graphe peut non seulement représenter que (Employé A, rend compte à, Manager B), mais aussi suivre le moment où cette relation hiérarchique a commencé, ou si l'information a été déduite d'un calendrier, d'un annuaire ou d'un fil d'e-mails. L'ensemble du graphe dans Glean est conçu avec des contrôles d'accès à granularité fine, de sorte que les employés ne peuvent voir que les données qui leur sont déjà partagées dans le système source.
En pratique, les graphes de connaissances d'entreprise permettent la recherche d'informations à travers les silos de données et évitent les hallucinations courantes dans la recherche sémantique. Ils servent de tissu conjonctif de l'intelligence contextuelle — permettant aux agents et assistants IA de comprendre comment les données sont liées entre elles.
Comment fonctionnent les graphes de connaissances
La création d'un graphe de connaissances en entreprise commence par l'extraction et l'identification d'entités significatives à partir d'un texte en langage naturel. Prenons l'exemple du mot « Reddit ». Bien qu'il puisse sembler simple, « Reddit » pourrait désigner des entités entièrement différentes selon le contexte. S'il est mentionné par un responsable de compte dans l'organisation des ventes, il s'agit probablement d'un client. Dans une conversation marketing, il pourrait renvoyer aux dépenses publicitaires sur le réseau social « Reddit ». Pour désambiguïser ces significations, il faut une annotation tenant compte du contexte, qui prend en considération le rôle de l'utilisateur, son intention et le contenu environnant afin d'identifier et de cartographier correctement l'entité dans le graphe de connaissances.
Une fois l'entité annotée, l'étape suivante consiste à comprendre l'intention derrière la requête. Cela implique de traduire la requête en langage naturel en une représentation structurée pouvant être exécutée de manière programmatique. Traditionnellement, cela était réalisé par apprentissage semi-automatisé. Des opérateurs humains amorçaient des modèles de requêtes connus — tels que « trouver un label Jira » — et les utilisaient pour identifier des intentions courantes. Ces requêtes d'amorçage étaient ensuite élargies en analysant les journaux de requêtes afin de découvrir d'autres formulations correspondant à la même intention. Ce processus ressemble à de la reconnaissance de motifs à grande échelle, où l'intention est reliée à des entités connues et à des types de requêtes en fonction de structures récurrentes dans le langage.
La troisième phase consiste à prendre l'intention structurée et à exécuter l'action appropriée, souvent en interrogeant le graphe de connaissances. Par exemple, une requête structurée telle que « trouver les labels Jira utilisés par Reddit » peut être émise pour récupérer les informations pertinentes. C'est à cette étape de réalisation que la structure du graphe se révèle essentielle : elle permet au système de récupérer des informations précises en parcourant les relations entre les entités du graphe.
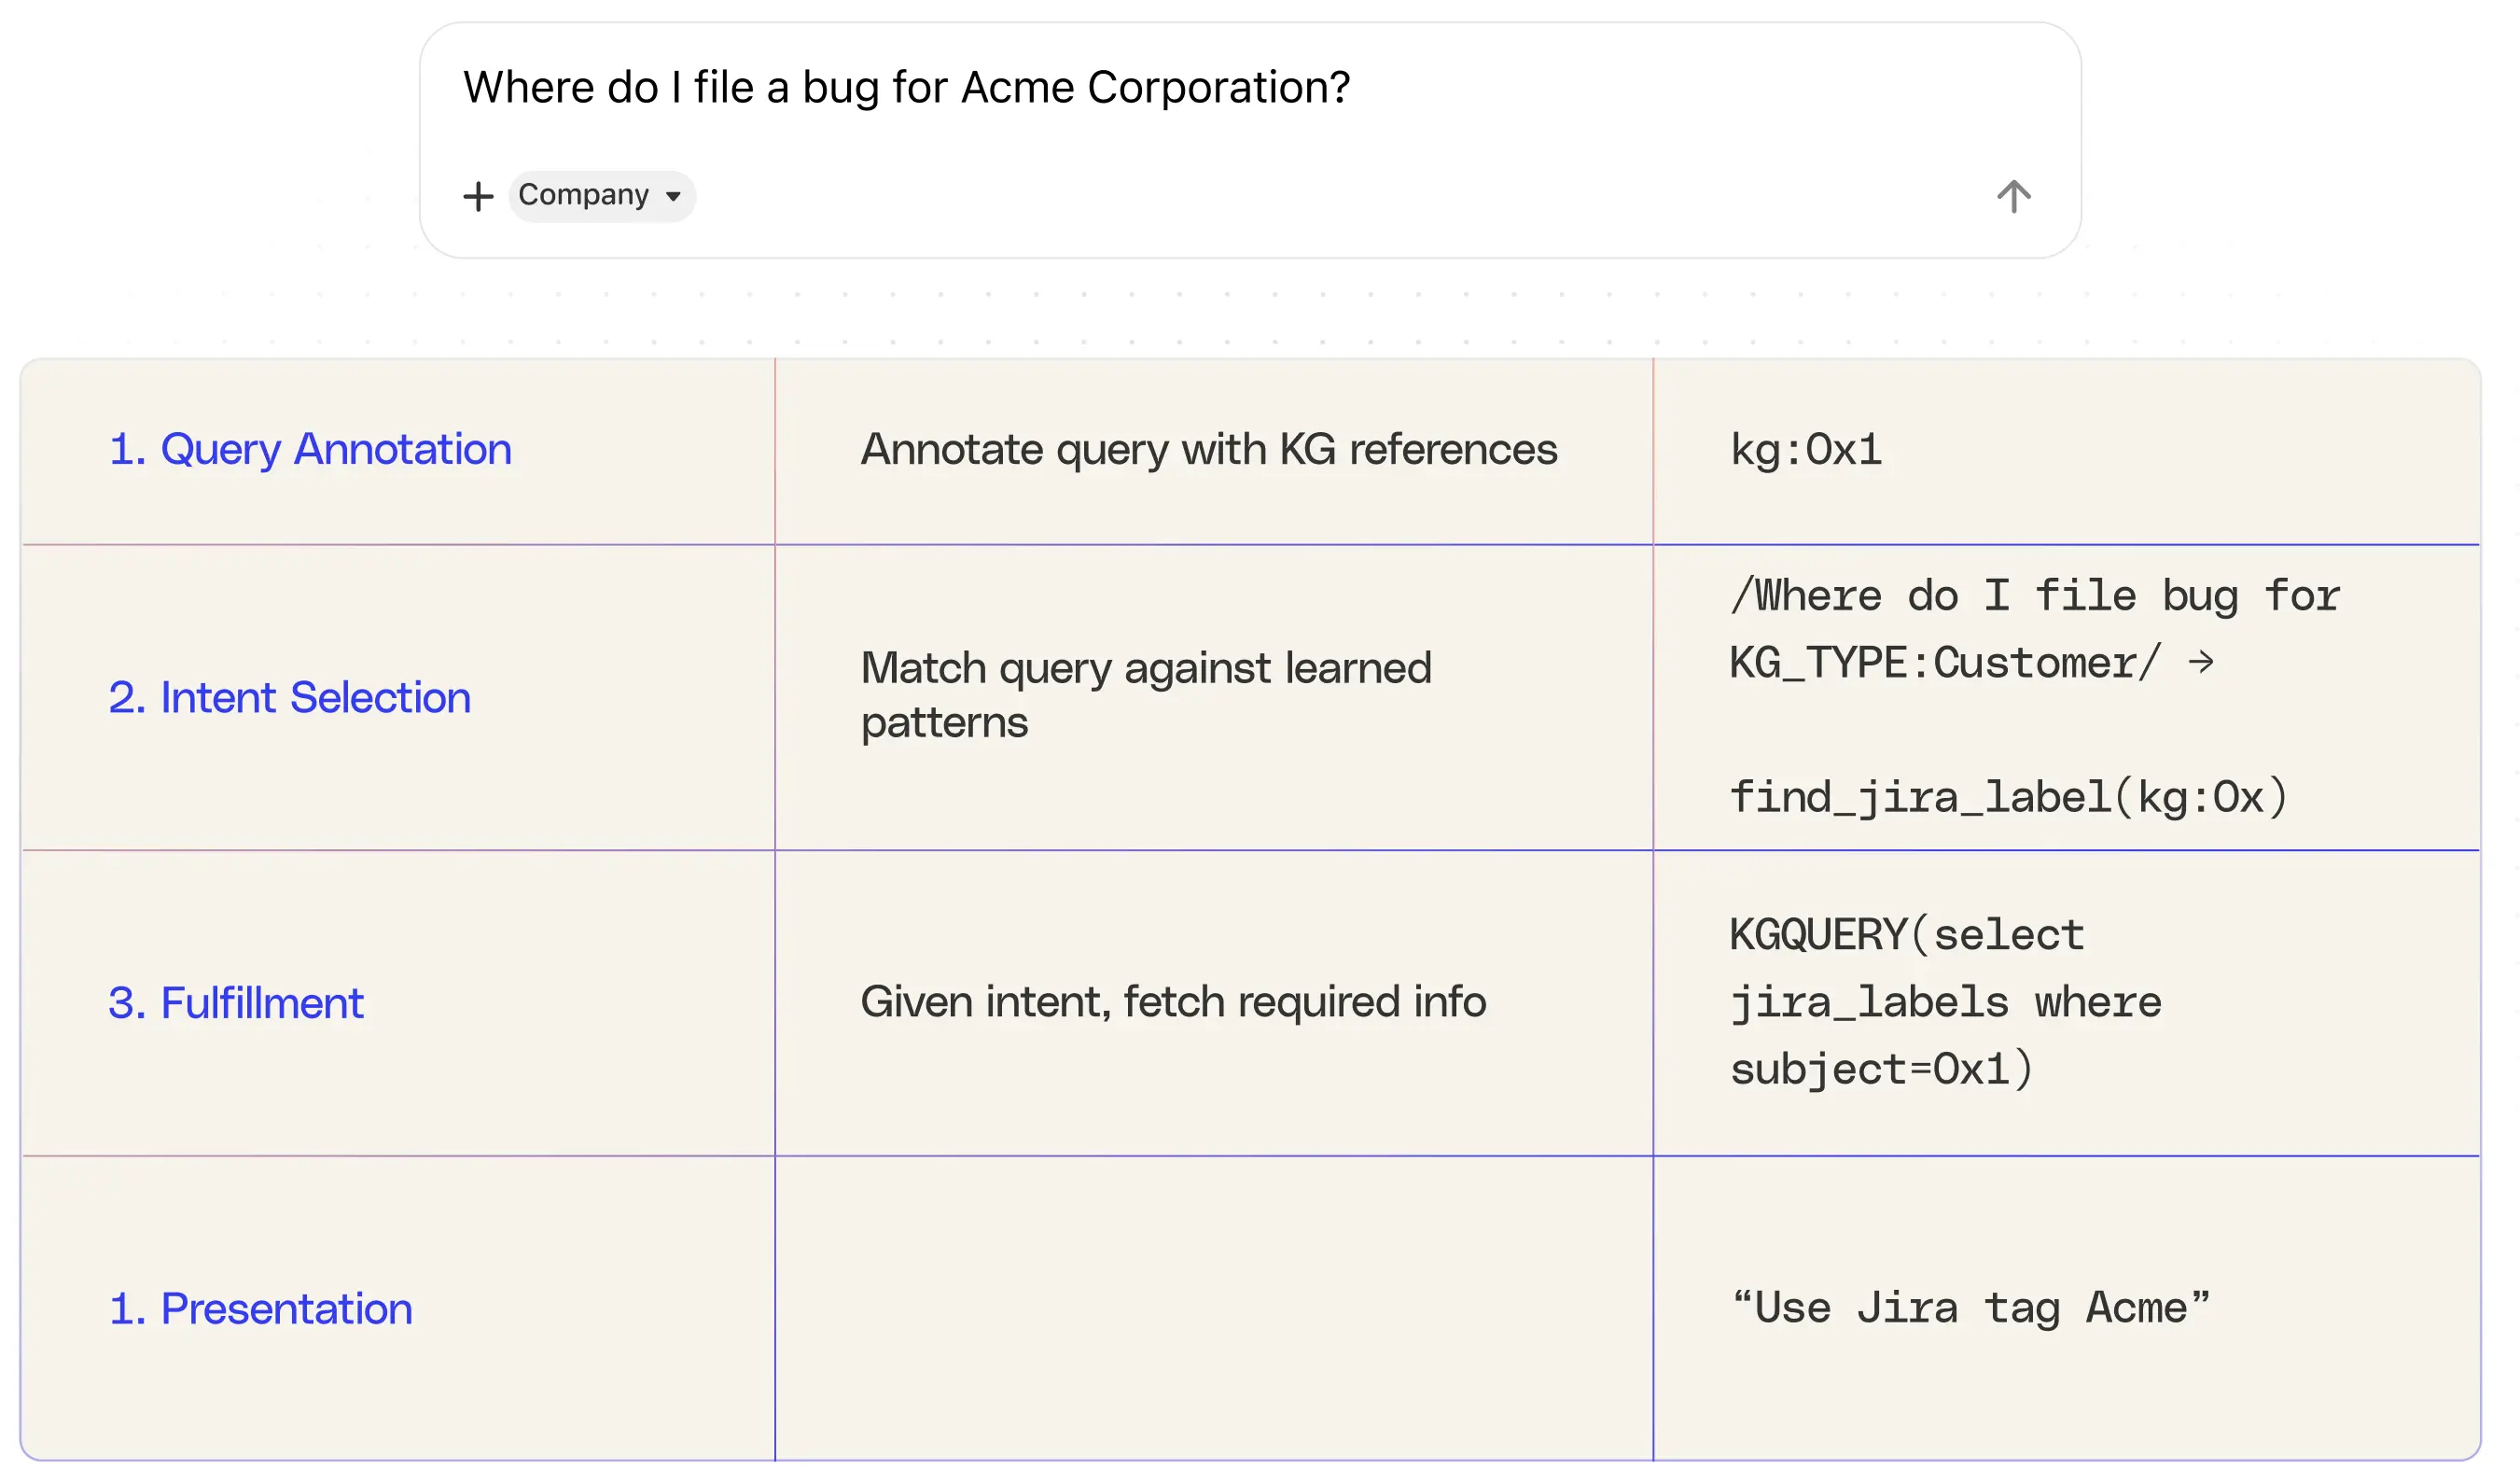
Avec l'arrivée des LLM, les deux premières phases — l'annotation des entités et la reconnaissance des intentions — sont devenues nettement plus puissantes et automatisées. Les LLM excellent dans l'analyse du langage naturel, réduisant le besoin de création manuelle de motifs et de désambiguïsation basée sur des règles.
Chez Glean, nous avons enrichi notre graphe pour qu'il prenne en charge des milliers d'arêtes grâce aux LLM. Même avec les LLM, les graphes de connaissances ne sont pas simples à créer. Nous y reviendrons plus loin.
Les limites des LLM dans les cas d'usage de l'IA d'entreprise
Les LLM sont efficaces pour capturer de larges associations sémantiques au sein de leur fenêtre de contexte, mais ils peinent avec le raisonnement multi-sauts, le langage propre à l'entreprise et la compréhension des processus ou des schémas d'utilisation. Par conséquent, l'extraction de données basée sur les LLM a tendance à être intrinsèquement lacunaire.
Seuls, les LLM ont du mal à restituer des faits précis et à accomplir des tâches nécessitant une énumération, comme répondre à « Qui a contribué au Projet X ? » ou « Lister tous les labels Jira du client ABC ». De plus, les LLM peuvent mal interpréter le langage naturel ou mal classifier l'intention de l'utilisateur, des problèmes liés à des erreurs de NLP. C'est là qu'interviennent les graphes de connaissances : en ancrant les réponses dans des relations structurées et des entités vérifiées, ils aident à réduire l'ambiguïté et à améliorer la fiabilité.
Les LLM (sur)pondèrent la proximité des termes
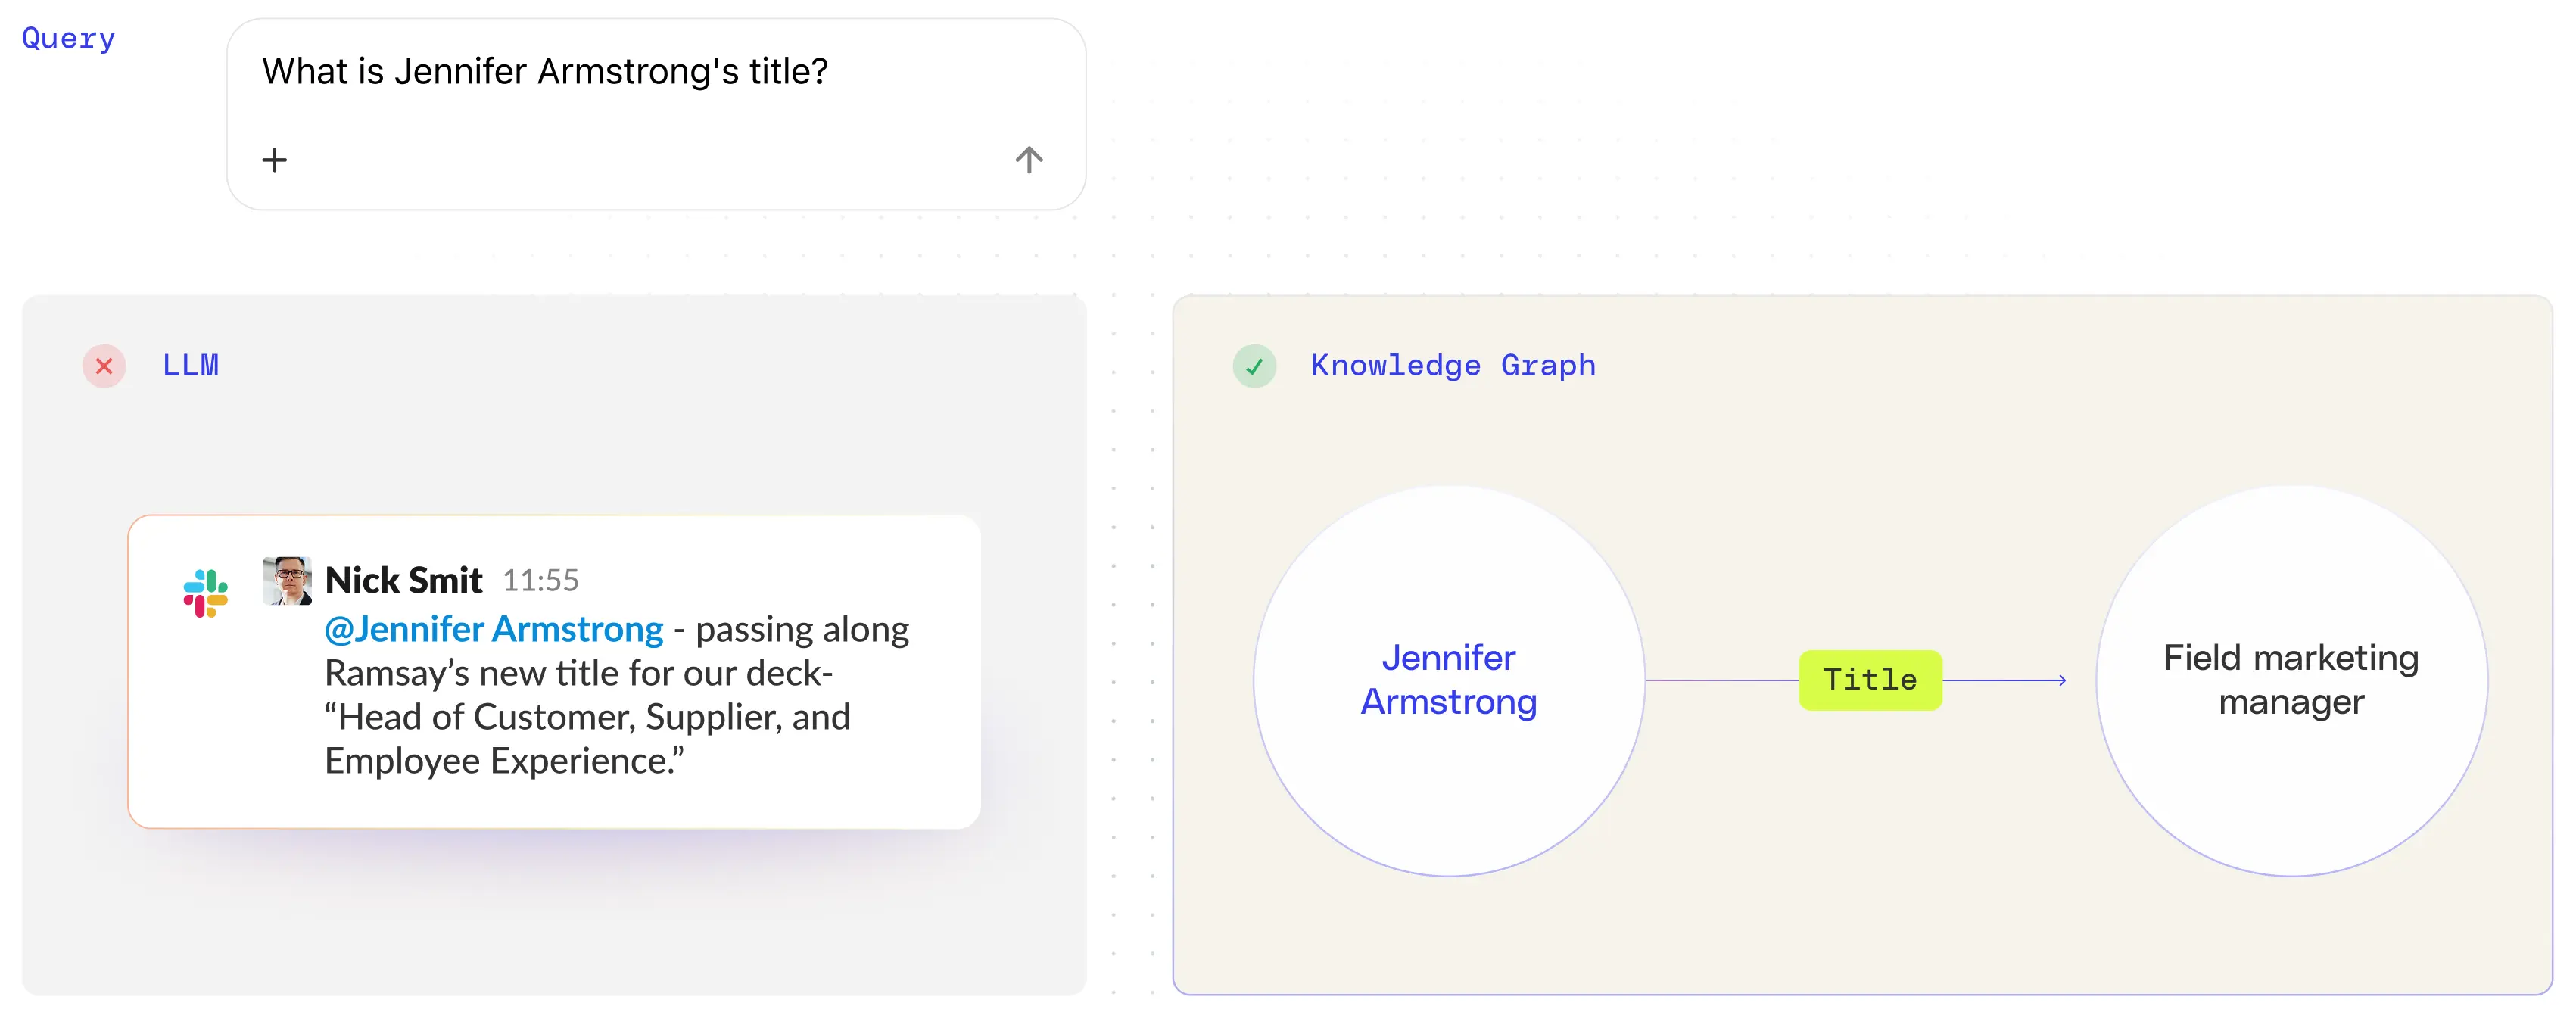
Dans les environnements d'entreprise, les LLM ont souvent du mal à atteindre la précision, surpondérant la proximité des termes. Prenons l'exemple d'une utilisatrice fictive, Jennifer Armstrong, responsable du marketing terrain. Lors d'une récente requête, Jennifer a été incorrectement identifiée comme responsable de l'expérience client, fournisseur et employé. En remontant à la source du problème, le LLM avait mal interprété un message Slack concernant un événement qu'elle avait organisé, lui attribuant un titre erroné.
Les LLM confondent des entités aux noms similaires
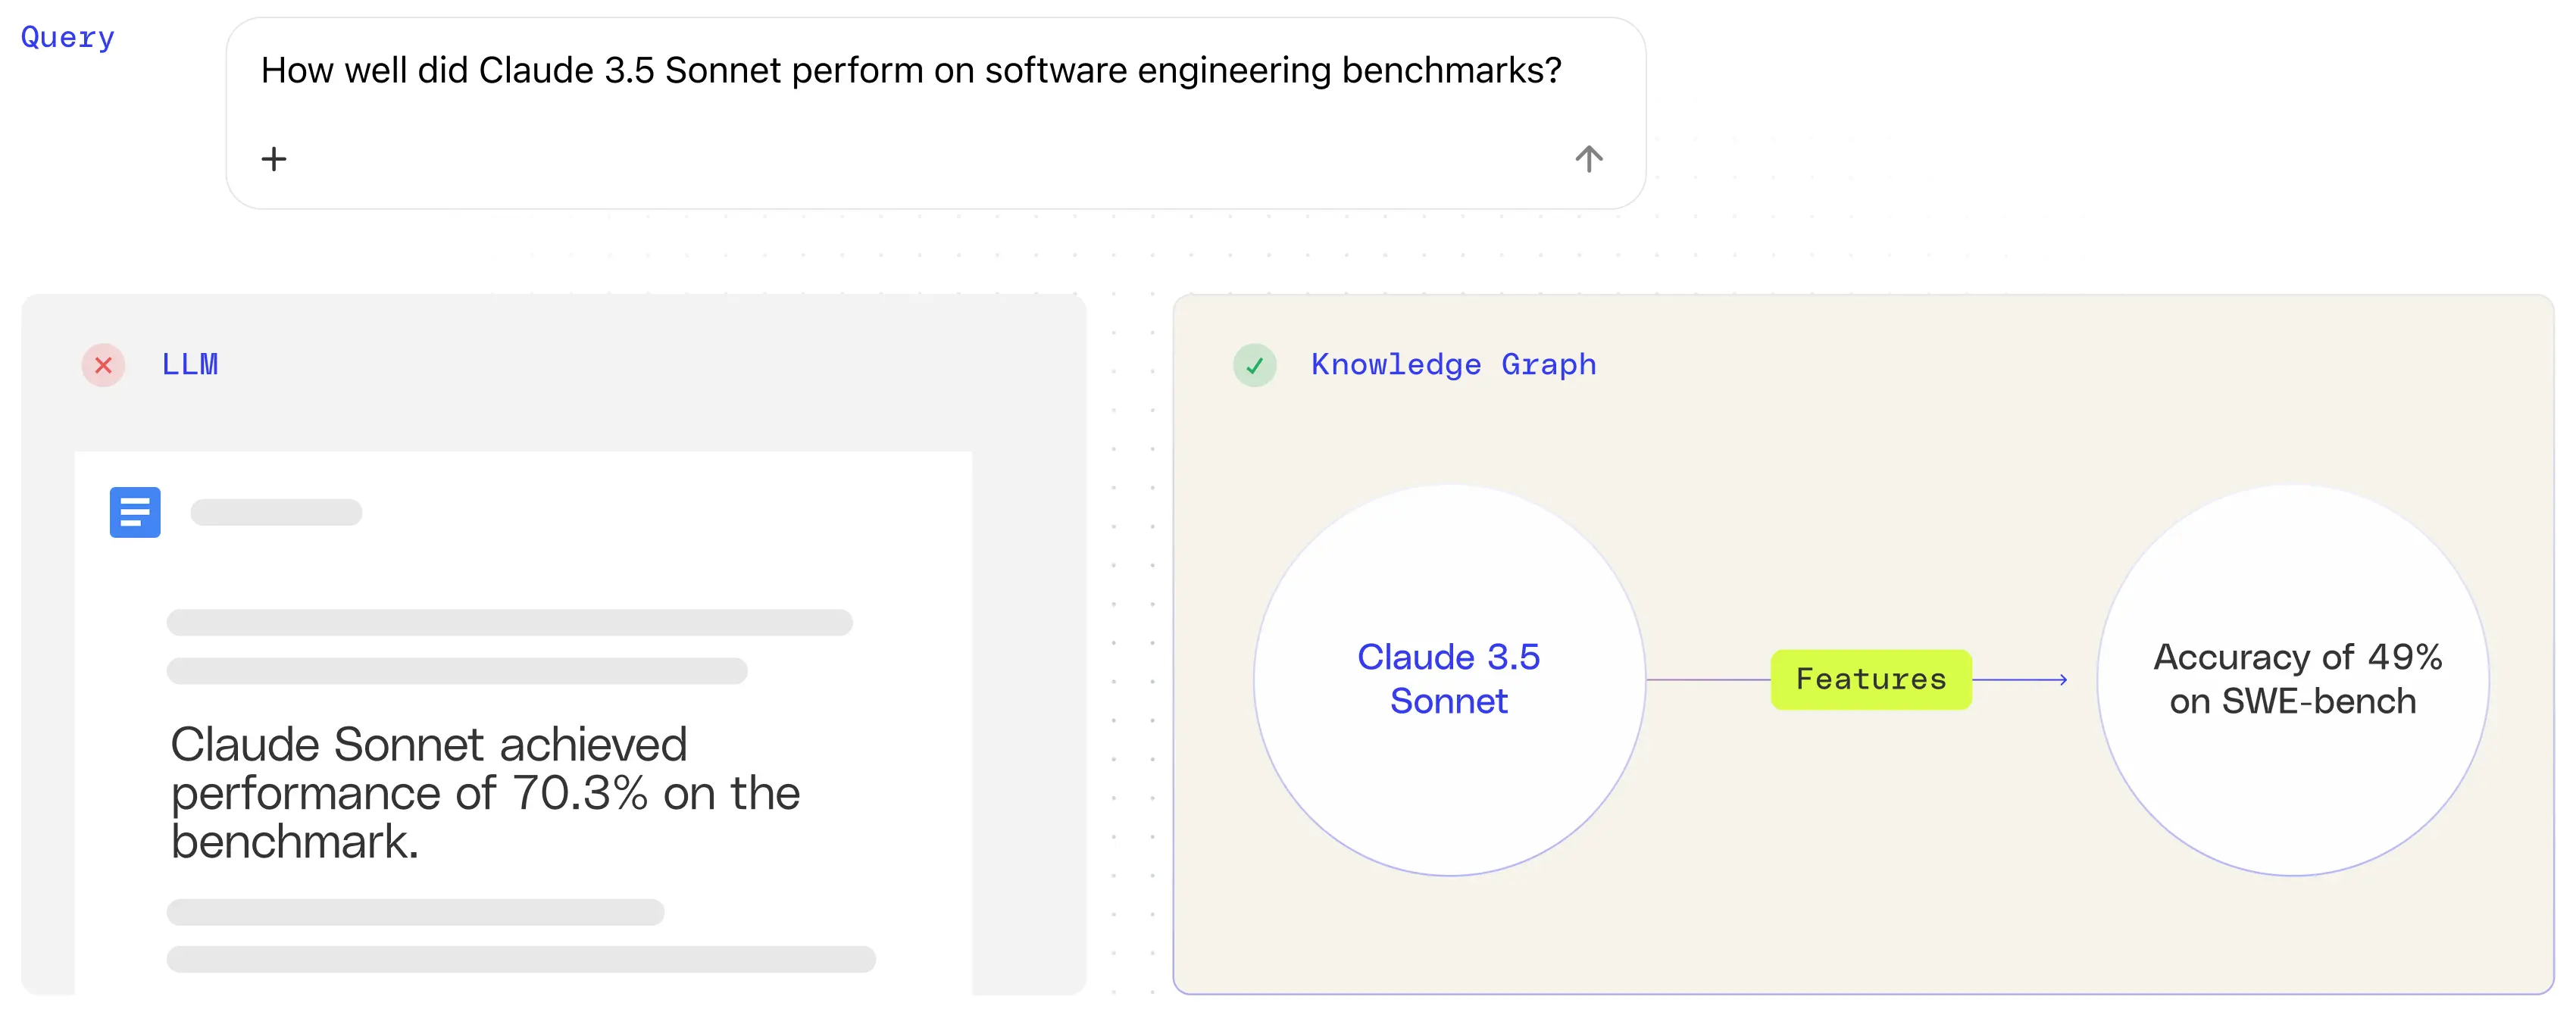
Un problème similaire se produit avec le nommage des produits. Claude 3.7 Sonnet et Claude 3.5 Sonnet v2 sont des modèles distincts, mais les LLM confondent fréquemment les deux, fusionnant leurs fonctionnalités ou leur documentation en une seule réponse incorrecte. Sans désambiguïsation structurelle, même les différences subtiles entre les versions de modèles sont faciles à mal représenter.
Les LLM peinent avec les requêtes déterministes
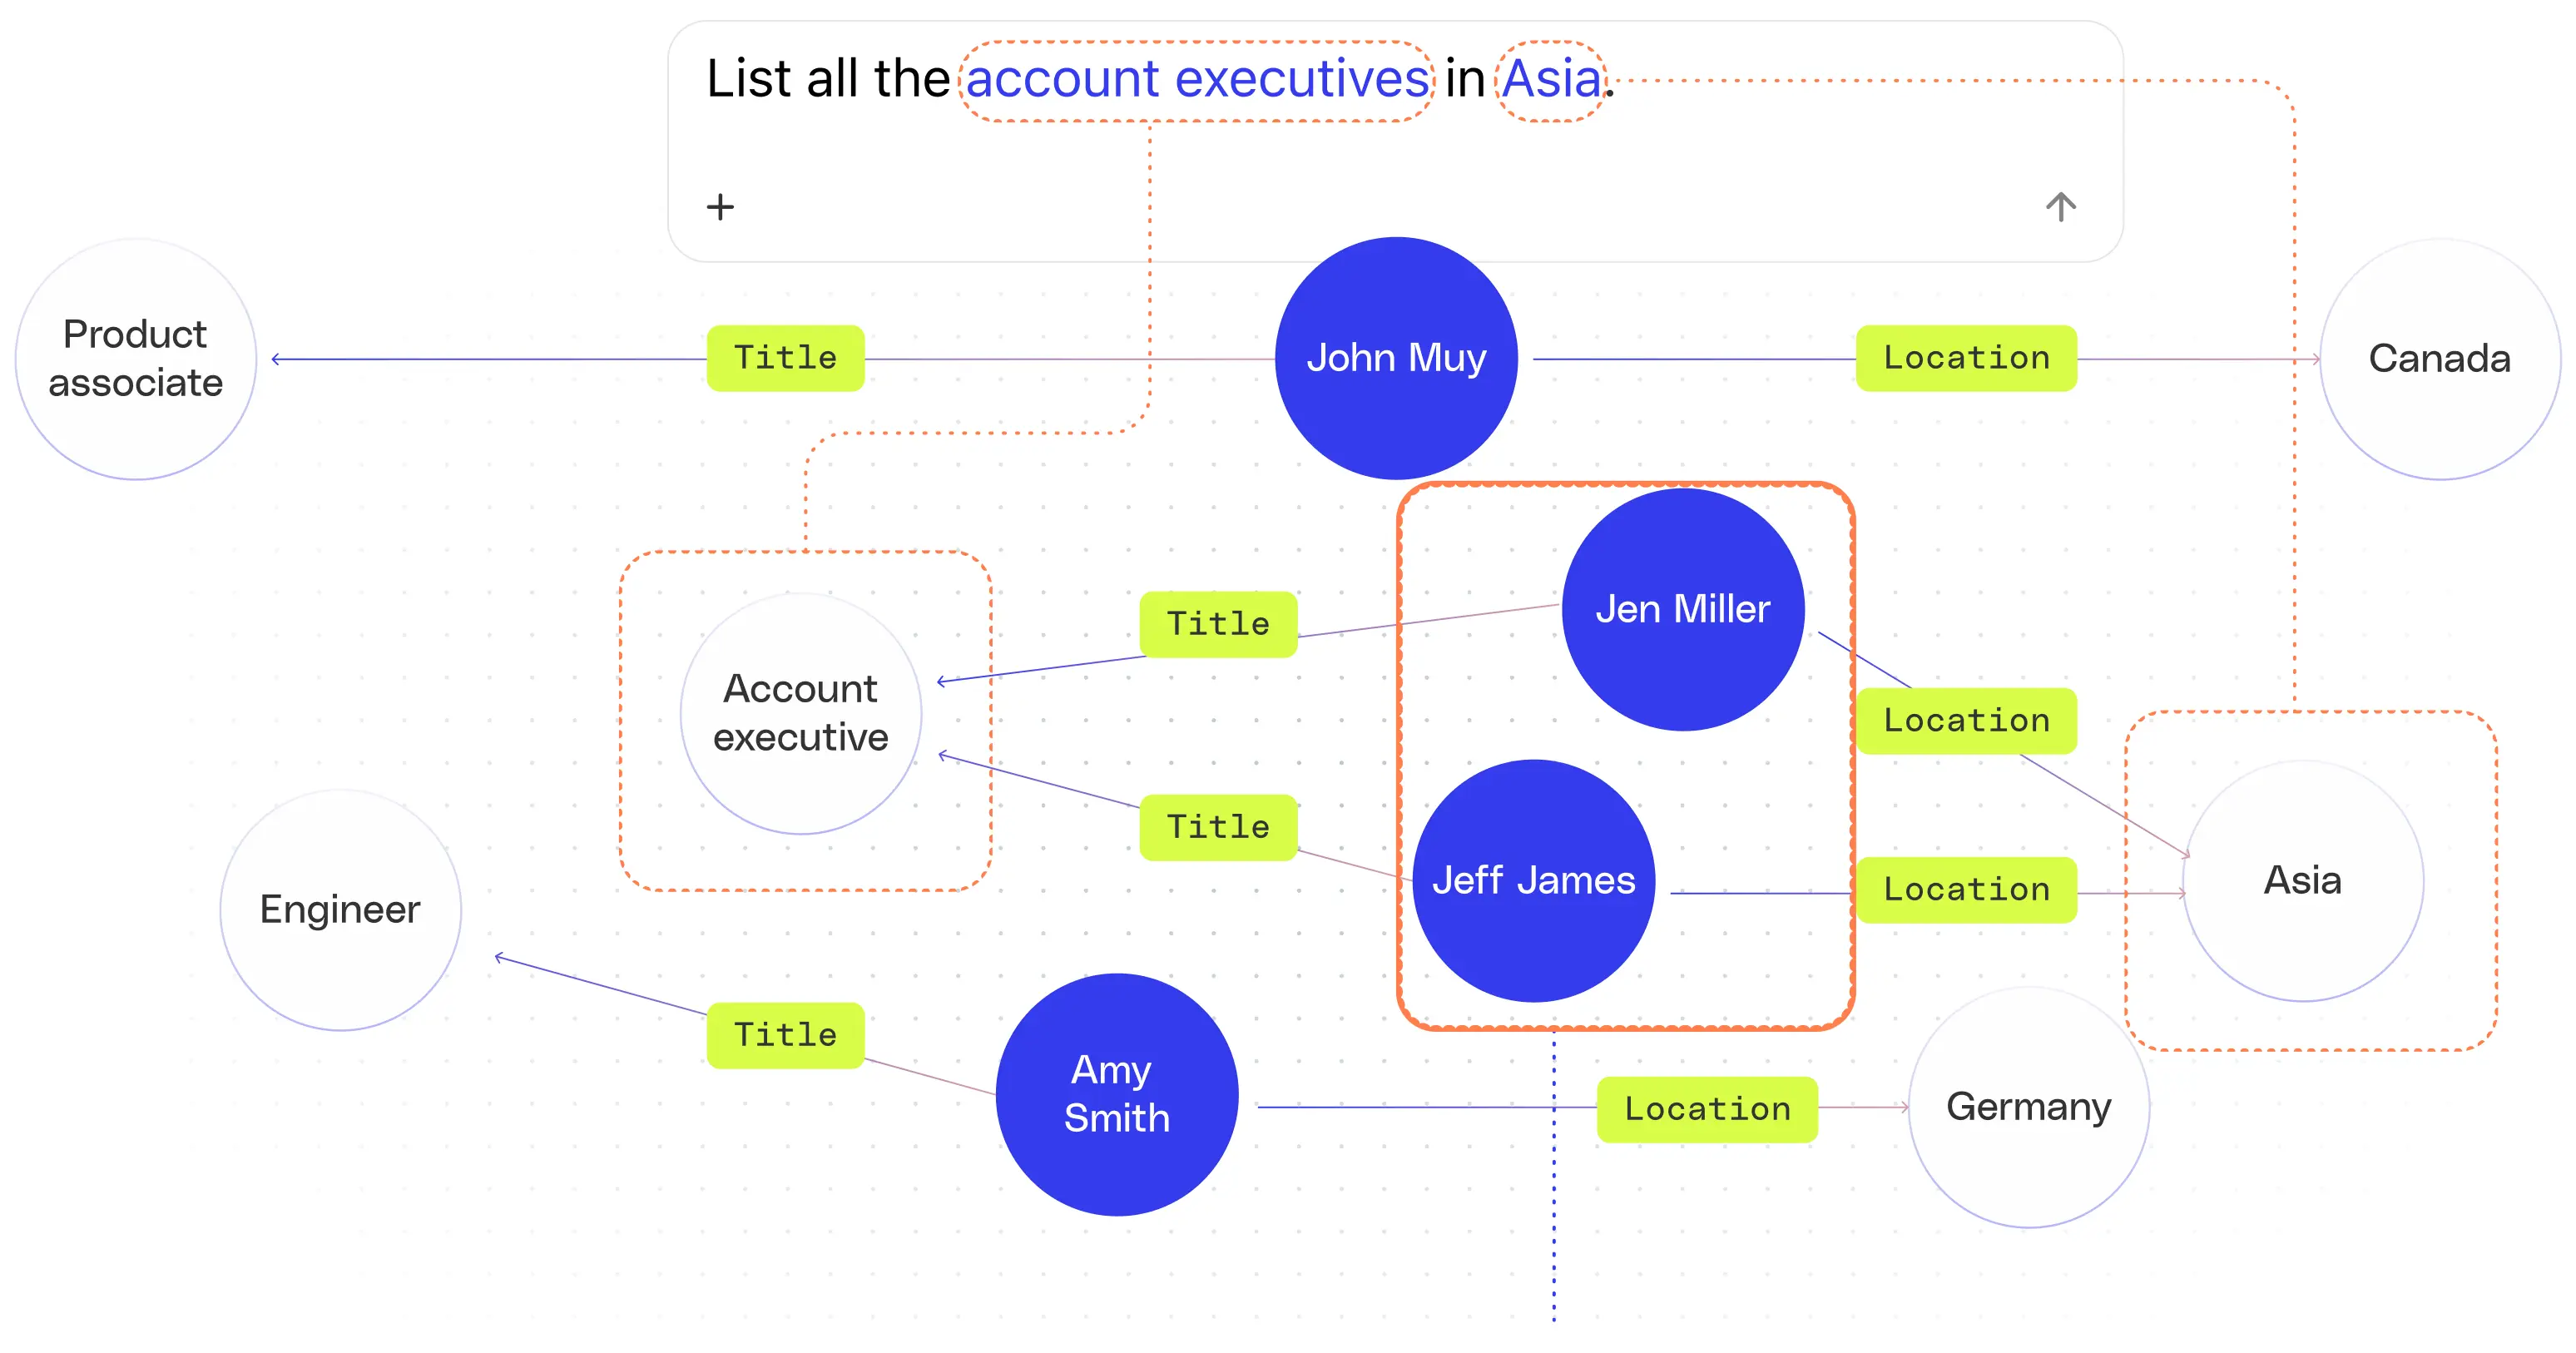
Les graphes de connaissances aident à atténuer ces problèmes en ancrant les requêtes dans des entités connues et structurées. Comme l'illustre le diagramme suivant, lorsqu'on demande de « Lister tous les account executives en Asie », le graphe de connaissances peut identifier les termes de la requête « account executives » comme une fonction spécifique, par opposition à une description générale, et « Asie » comme un emplacement. Avec cette information, le système peut alors effectuer une requête structurée exhaustive et déterministe pour tous les employés ayant le rôle d'Account Executive et localisés en Asie. C'est quelque chose que les LLM seuls peinent à faire de manière cohérente.
Les LLM ont du mal avec les relations inter-entités
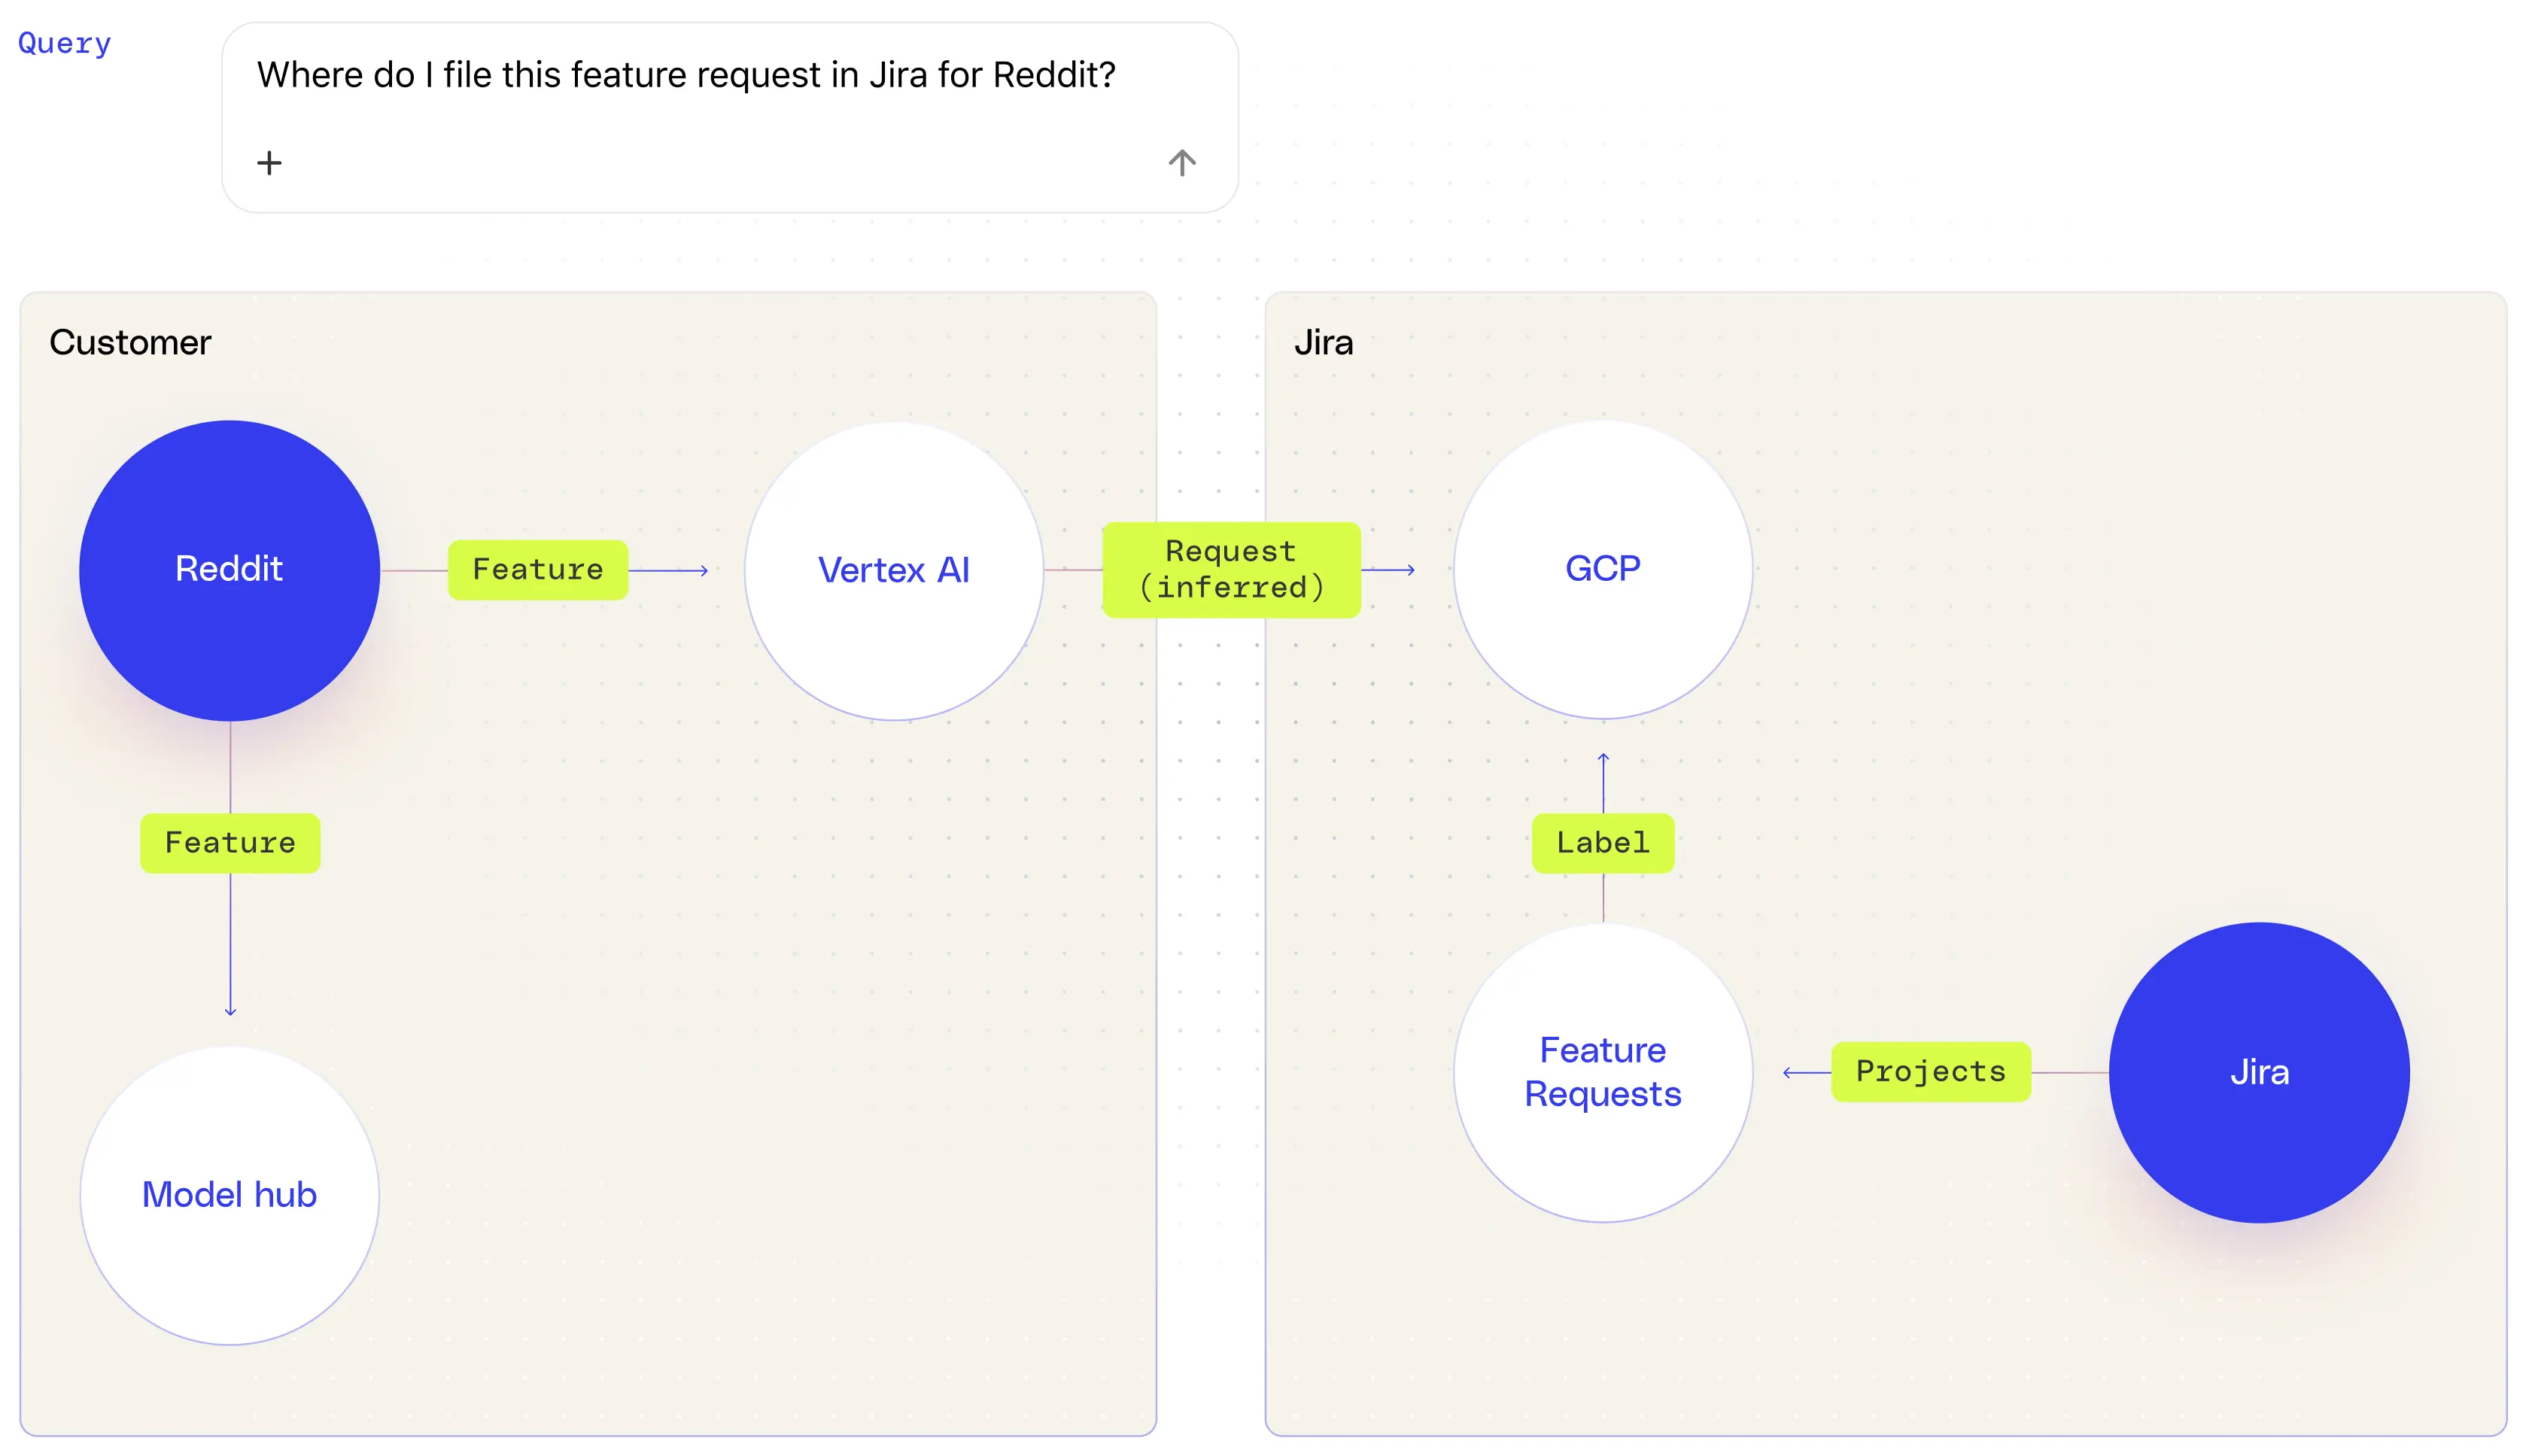
Pour des tâches plus complexes, comme répondre à « Où dois-je déposer les demandes de fonctionnalités pour Reddit ? », les LLM doivent distinguer Reddit la plateforme sociale de Reddit le client d'entreprise, reconnaître que le processus implique Jira, et enchaîner ces compréhensions dans un flux de travail cohérent. Ce niveau de raisonnement relationnel et d'inférence multi-sauts est difficile à atteindre de manière fiable sans un graphe de connaissances lisible par machine qui relie ces entités, rôles et systèmes.
Il existe un continuum de fiabilité dans les LLM. Pour la restitution de faits simples, les LLM peuvent fournir des réponses fiables et correctes, parfois 100 % du temps, surtout lorsque la réponse est explicite et proche dans un contexte accessible. Pour des inférences plus complexes, multi-sauts ou indirectes (« Montrer toutes les bases de code des projets dirigés par X qui ont été livrés au T1 2025 »), les LLM deviennent moins fiables. Parfois, ils peuvent répondre correctement, si tout s'aligne, mais ils hallucinent souvent ou manquent des connexions. Il existe une longue traîne de questions difficiles ou nuancées qui échappent à la zone où les LLM sont robustes : c'est là que les performances chutent brutalement et où les graphes de connaissances règnent.
Transformer le travail avec les graphes de connaissances
L'une des questions les plus difficiles mais fréquentes que tout dirigeant doit résoudre est : « Comment le Projet X progresse-t-il par rapport à ses OKR ? » Il s'agit d'une question à forte valeur et à forte intention, difficile à traiter dans la plupart des systèmes, en particulier dans un contexte d'ingénierie. Pour y répondre avec précision, le système doit corréler plusieurs sources de données, notamment les contributions au code, et les mettre en correspondance avec les objectifs et résultats clés définis pour un projet donné. Cette corrélation permet d'évaluer si un projet est en rouge, jaune ou vert.
Le défi consiste à déterminer quels changements de code sont pertinents pour quels OKR. Les LLM peinent ici, car il ne s'agit pas d'une tâche impliquant l'interprétation d'un langage narratif. Le code est concis, structuré et manque souvent d'annotations directes qui le relient aux projets ou aux objectifs métier. Le volume de changements est également considérable : des milliers de commits peuvent exister à travers une base de code, et seule une petite fraction peut concerner une initiative spécifique.
Si les LLM excellent à résumer les progrès ou à générer de la prose une fois les bons signaux identifiés, ils ne sont pas bien adaptés à faire émerger ces signaux en premier lieu. Pour cela, il faut un système capable de mettre en correspondance les artefacts de code — comme les répertoires, fichiers ou composants — avec des projets spécifiques. Cela implique des processus hors ligne, des métadonnées de projet et des heuristiques comme la structure des répertoires (par exemple, un dossier docubuilder/) — autant d'éléments essentiels qui alimentent un graphe de connaissances.
Une fois ces associations établies, les relations structurées qui en résultent doivent être mises à disposition dans le chemin de service pour une utilisation à l'exécution. C'est là que le graphe de connaissances devient essentiel ; il fournit une représentation structurée qui peut être rapidement interrogée à l'exécution.
Pour vous aider à imaginer davantage l'impact des graphes de connaissances dans l'IA d'entreprise, voici quelques exemples supplémentaires :
Ventes : Quelles transactions à forte valeur risquent de nous échapper à cause de lacunes dans les fonctionnalités produit ou d'escalades répétées de support P1 avec ces comptes ?
Cette question s'appuie sur un raisonnement multi-sauts pour analyser les données clients, les fonctionnalités produit et les tickets de support.
IT : Quelle panne système déclenche plusieurs alertes redondantes dans nos services, et comment réduire le bruit ?
Cette question comprend les outils d'infrastructure et le planning d'astreinte, associe les logs à différents services et identifie les redondances pour limiter le bruit.
Ressources humaines : Fournissez-moi une liste personnalisée et à jour des activités d'intégration des employés.
Les graphes de connaissances peuvent accélérer l'intégration en capturant les activités d'une équipe ainsi que le contexte clé — comme les outils, les procédures et la documentation — et en exploitant ces informations pour aider un LLM à générer une liste de tâches d'intégration priorisée et toujours à jour.
Personnel : Aidez-moi à rédiger mon auto-évaluation pour mon entretien de performance.
Les graphes de connaissances peuvent faire remonter une liste complète des activités d'un employé — avec un contexte important comme l'équipe, les objectifs et les collaborateurs. Associés aux LLM, ils peuvent accélérer considérablement la rédaction et l'affinage d'une auto-évaluation de grande qualité.
Les aspects complexes des graphes de connaissances d'entreprise
En entreprise, construire un graphe de connaissances de grande qualité est fondamentalement différent — et à bien des égards plus complexe — que de construire des graphes de connaissances comme ceux de Google ou Bing. Les principaux défis sont la sensibilité en matière de confidentialité, le besoin d'algorithmes évolutifs et la difficulté d'identifier les entités et faits clés lorsqu'on ne dispose que d'un ensemble relativement restreint de documents — et que la révision manuelle n'est pas une option.
Contrairement aux données publiques du web, les informations d'entreprise contiennent souvent du contenu sensible, confidentiel ou réglementé qui ne peut pas être librement consulté, révisé manuellement ou exposé à une équipe d'annotateurs humains (comme c'est courant dans les projets de graphes publics). Chaque étape de l'extraction d'entités doit respecter les limites organisationnelles, contractuelles et légales en matière de confidentialité. Le graphe doit être structuré de manière à permettre aux employés d'obtenir différents niveaux d'accès aux données, ce que les graphes grand public n'ont pas besoin de prévoir. Dans les contextes publics, les équipes peuvent organiser manuellement des faits importants en parcourant de vastes quantités de données publiquement accessibles.
En entreprise, « mettre les mains dans les données » via une révision manuelle est soit interdit, soit impraticable à grande échelle en raison de la confidentialité et du volume. La construction manuelle de graphes ne peut pas s'adapter à des milliers de clients d'entreprise variés, chacun ayant ses propres données, son vocabulaire et ses sensibilités en matière de sécurité. Une méthode algorithmique et automatisée est essentielle pour traiter les corpus de tous les clients sans intervention humaine et pour s'adapter dynamiquement à l'arrivée de nouvelles données. Le processus d'extraction, sans inspection directe, comprend les étapes suivantes dans l'IA d'entreprise :
- Extraction automatisée de noms : Commencer par exécuter des algorithmes (par ex. l'extraction de syntagmes nominaux par NLP) sur le corpus pour en extraire toutes les entités potentielles — automatiquement et sans révision humaine des données.
- Filtrage par fréquence et importance : Tous les termes fréquemment mentionnés ne sont pas importants. Après l'extraction initiale, les termes courants (« table », « espagnol ») sont filtrés à l'aide de méthodes statistiques et heuristiques.
- Preuve de l'importance d'une entité : Pour élever une entité au rang du graphe de connaissances, des signaux supplémentaires sont utilisés pour déterminer son importance, notamment :
- La présence dans les titres de documents clés
- Les liens fréquents entre ressources populaires
- La présence dans les fichiers les plus partagés ou consultés
- Extraction sélective de propriétés et identification de prédicats : Pour chaque entité identifiée, les algorithmes extraient des termes descriptifs et des relations possibles (prédicats), en priorisant à nouveau les faits pour lesquels il existe des preuves solides et reproductibles (par ex. « document rédigé par une personne », « projet dirigé par »).
- Affinage algorithmique continu : Comme aucun humain ne lit les données privées, le système améliore de manière itérative ses filtres pour réduire le risque de surinclusion (fuite ou saturation du graphe avec des entités à faible valeur) et s'adapter aux nouvelles structures de données ou signaux de chaque entreprise.
Chez Glean, nous avons construit une architecture de crawler en temps réel qui alimente à la fois la recherche sémantique et lexicale, en ingérant en continu le contenu et les métadonnées de l'entreprise. Cette même infrastructure alimente notre graphe de connaissances — nous offrant une base solide. Au cours des six dernières années, nous avons affiné ce graphe à l'aide d'algorithmes conçus sur mesure pour prendre en charge des raisonnements de plus en plus complexes et les flux de travail d'entreprise requis par les agents.
Enrichir le graphe de connaissances avec le graphe personnel
Nous avons récemment ajouté une nouvelle dimension au graphe de connaissances d'entreprise : le graphe personnel, qui capture l'activité des employés pour comprendre ce sur quoi les individus travaillent et l'impact de leurs efforts. L'objectif est de modéliser le travail réel — identifier les projets actifs, les schémas de collaboration et les tâches en cours — afin que Glean puisse commencer à offrir une assistance proactive, comme faire remonter les priorités, mettre en évidence les conflits et aider les utilisateurs à rester organisés.
Mais le graphe personnel va au-delà du simple réglage de la pertinence ou de la capture de l'historique des interactions au sein de Glean. Il sert de fondation à la personnalisation de l'expérience Glean — alimentant les réponses de l'Assistant et orientant les agents contextuels. Contrairement aux systèmes de mémoire des outils de chat IA classiques qui reposent sur l'historique de session, le graphe personnel examine de manière holistique l'activité numérique d'un individu, à travers les outils, les systèmes et le temps.
Pour cela, nous avons étendu notre infrastructure de crawling, capturant des données bien plus granulaires, y compris le comportement de lecture et les signaux de consommation passive, afin de générer des flux denses d'activité numérique en temps réel. Cela constitue la base pour comprendre le contexte de travail d'un utilisateur au moment où il se déroule.
L'une des principales raisons pour lesquelles nous pouvons désormais construire des graphes personnels est l'avancée du raisonnement des LLM. Le machine learning classique peinait à unifier les signaux d'activité en raison de l'absence d'identifiants directs entre des sources disparates (relier une invitation de calendrier aux modifications d'un document connexe). Les LLM peuvent traiter des flux d'activité chronologiques et raisonner dessus pour regrouper les actions connexes en unités logiques : tâches, projets ou groupes de travail thématiques — même en présence de signaux clairsemés et de changements de tâches.
Chez Glean, nous regroupons chaque action atomique (« a créé le document X », « a assisté à la réunion Y », « a exécuté l'outil interne Z ») en sous-tâches, qui sont ensuite rassemblées en tâches de plus haut niveau avec des étiquettes contextualisées comme « a rédigé un brief produit » ou « a répondu à une demande juridique ». Le système agrège en outre les tâches connexes par thème — comme plusieurs documents liés au lancement d'un produit — et les relie aux objectifs organisationnels tels que les OKR. En analysant les schémas de collaboration (interactions récurrentes dans les commentaires, canaux Slack partagés), le graphe personnel révèle non seulement ce qui est fait, mais aussi qui travaille ensemble et comment — afin de générer une image plus complète des dynamiques de travail au sein de l'entreprise.
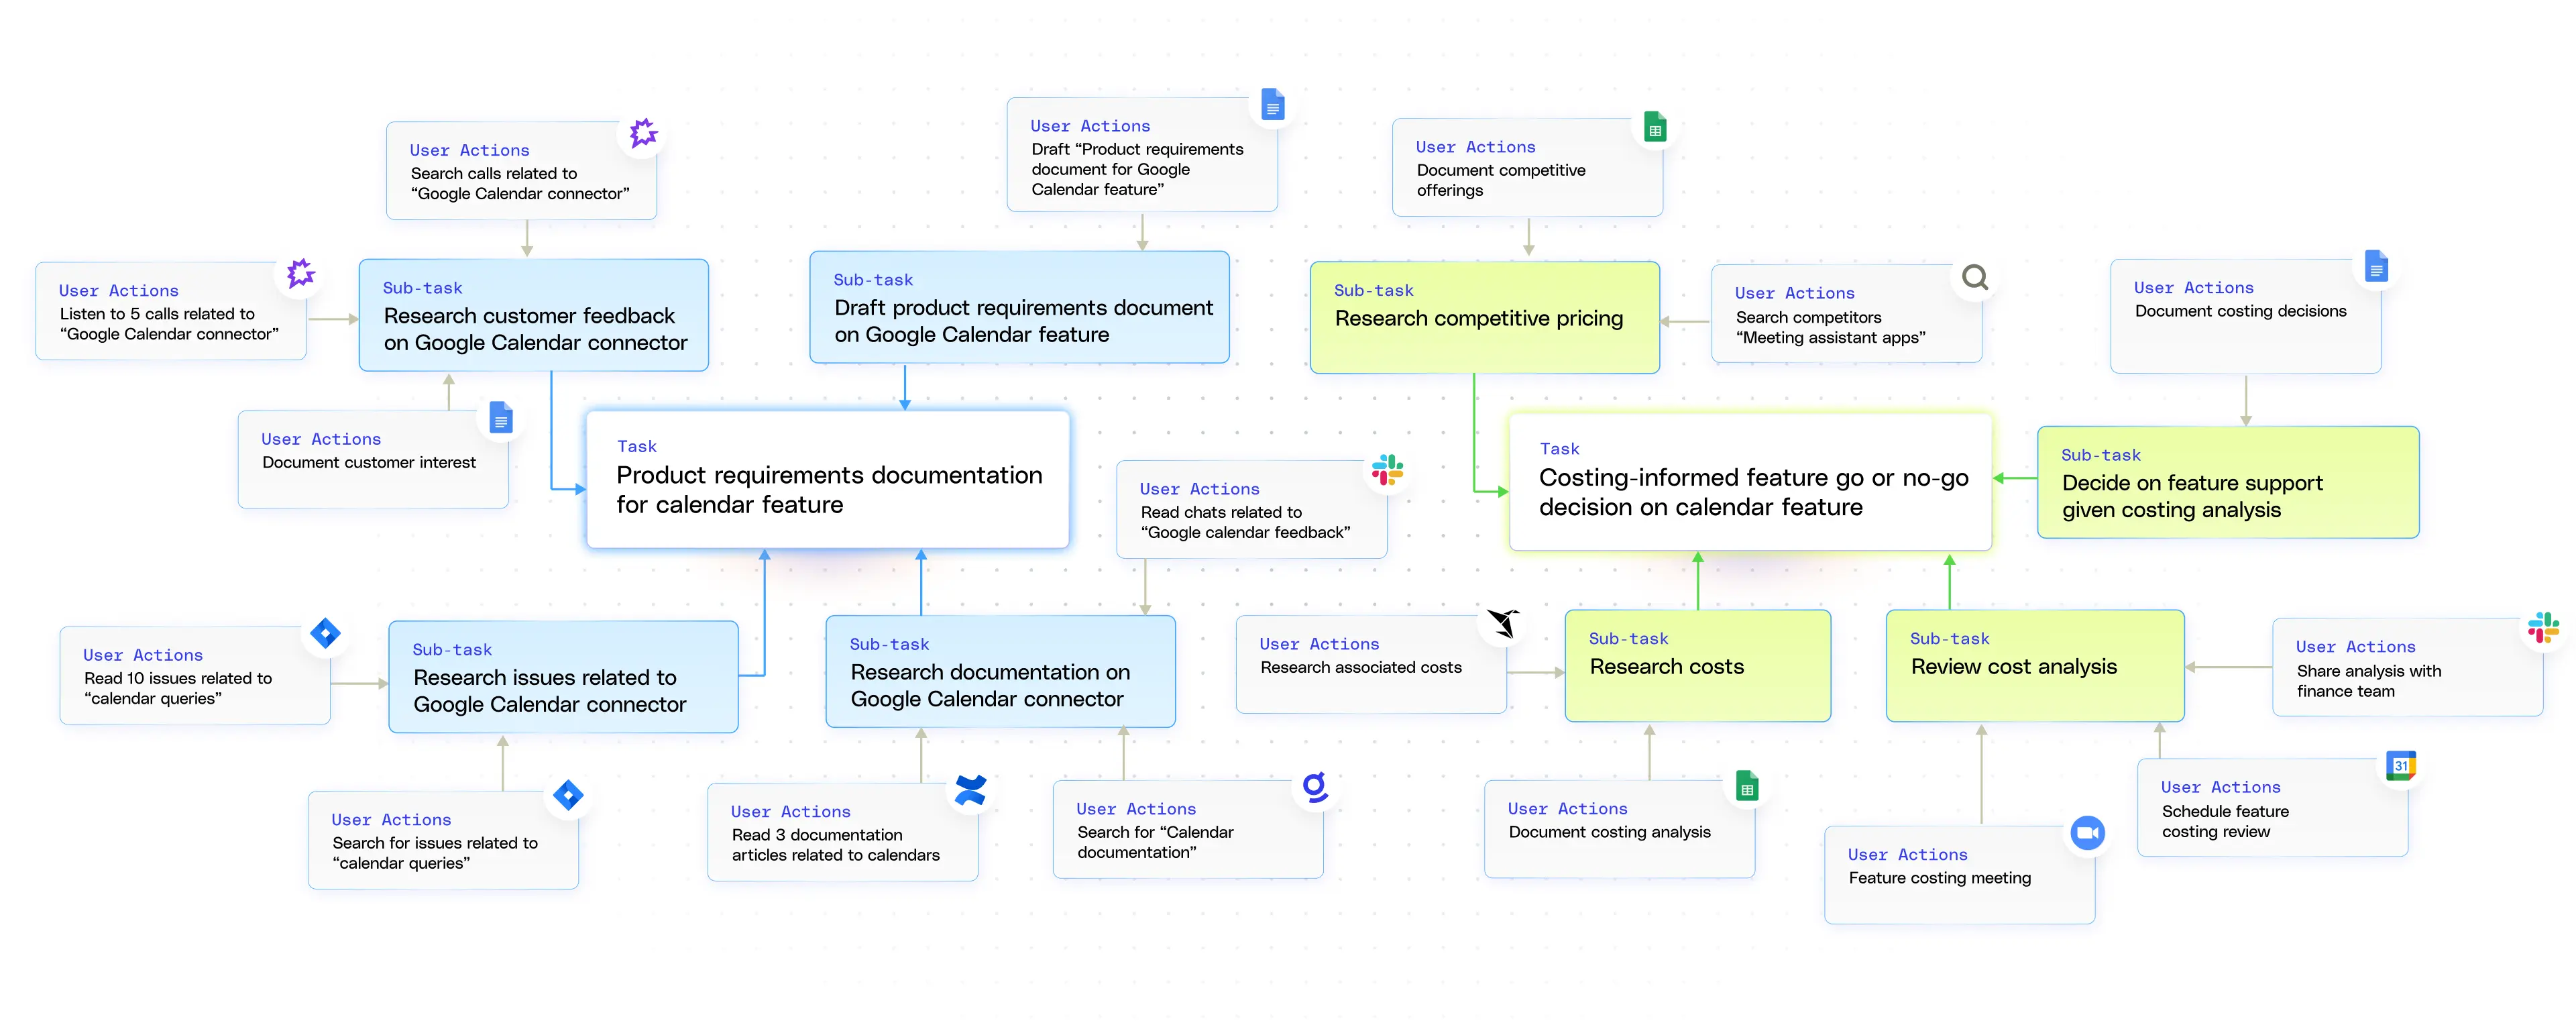
Construire le graphe personnel n'a rien de trivial. D'une part, tout travail significatif n'est pas numérique (réunions et discussions en présentiel). Même parmi l'activité numérique, inférer l'intention réelle (la modification d'un document est-elle un brouillon majeur, une correction ou une finition ?) n'est parfois possible que si l'utilisateur la signale explicitement (« Premier brouillon » dans le titre du document). Cela peut rendre difficile l'obtention des bons signaux lors de la construction du graphe personnel.
Notre architecture de crawler nous donne ici une longueur d'avance déterminante. En effet, chaque source de données possède son propre schéma (ce que signifie « commentaire » diffère entre Jira, GDocs, l'e-mail, etc.). Créer un langage commun, indépendant des sources, et une base de données chronologique est indispensable pour rendre possible le raisonnement multi-sources dans l'entreprise. Cela n'est possible qu'en indexant d'abord vos données ; la recherche fédérée ne fournit ni la structure ni les signaux nécessaires pour relier les points entre les sources.
Nous mettons déjà le graphe personnel à profit chez Glean — avec des agents de démarrage rapide qui peuvent aider les utilisateurs à résumer ce sur quoi ils ont travaillé la semaine dernière ou à préparer leurs évaluations de performance. Ces agents nous offrent une boucle de rétroaction qui nous permet d'itérer en continu sur le graphe personnel.
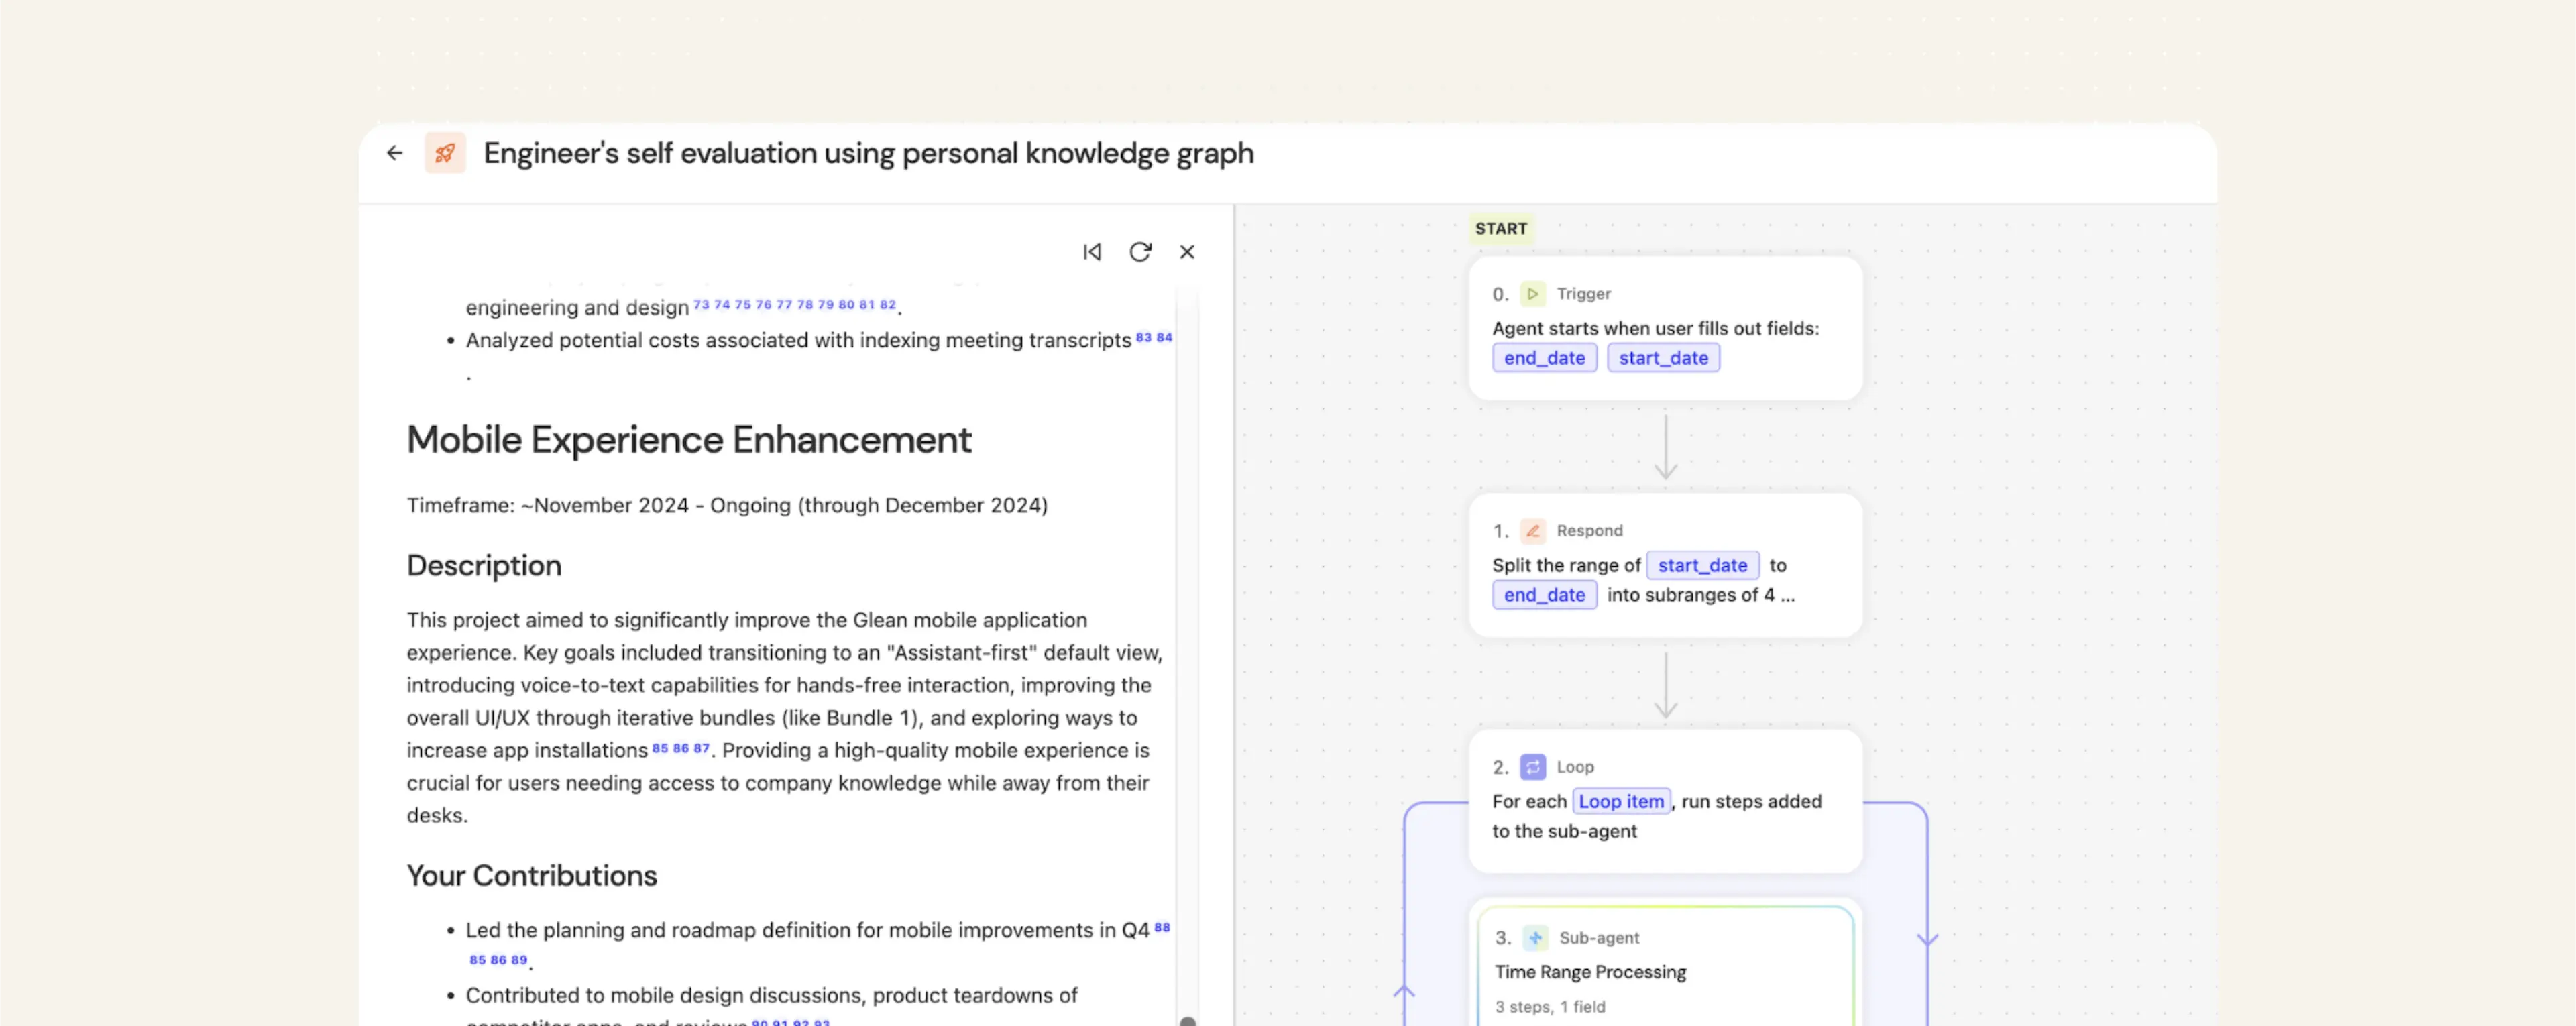
La vision plus large du contexte offerte par Glean est ce qui nous permet de déployer l'IA de manière transversale dans toute l'entreprise. Glean ne se contente pas de répondre à des questions — il apprend votre façon de travailler et s'adapte à vos côtés pour devenir votre assistant IA expert et personnalisé, ainsi que votre plateforme d'agents.
Le système de contexte dans l'IA d'entreprise
Lorsque nous réunissons le graphe d'entreprise et le graphe personnel, nous ne sommes pas seulement capables de soutenir des décisions complexes et à forts enjeux — nous pouvons le faire d'une manière qui semble personnelle, tant pour l'organisation que pour les individus qui la composent.
Quand nous pensons à l'avenir des assistants et des agents dans l'entreprise, la personnalisation ne peut pas se limiter à adapter les réponses. Ces systèmes doivent anticiper les besoins — lever les obstacles avant qu'ils ne deviennent des problèmes, faire remonter les initiatives au point mort — et accompagner activement les utilisateurs vers leurs objectifs. C'est là que nous nous dirigeons.
Jusqu'à présent, nous nous sommes concentrés sur deux couches clés : les données de l'entreprise et les personnes — sans doute les actifs les plus importants de toute organisation. Mais il existe une troisième couche : le processus — la façon dont le travail s'accomplit réellement, à la fois par les personnes et, de plus en plus, par les agents.
Les processus peuvent être profondément personnels, façonnés par les personnes qui les conçoivent. Mais beaucoup fonctionnent aussi en arrière-plan, détachés de tout individu. Nous apprenons des deux. En observant la manière dont les personnes travaillent avec les données, les systèmes et les outils, et la façon dont les agents sont utilisés, nous commençons à faire émerger et à modéliser ces processus comme partie intégrante du système lui-même.
Cette image en évolution crée une nouvelle couche de contexte — une couche qui ne se tient pas à l'écart des données et des personnes, mais qui s'appuie sur elles. Une fois que vous voyez cette toile en mouvement, vous réalisez que le système de contexte ne consiste pas seulement à organiser l'information — il s'agit d'orchestrer l'intelligence contextuelle. Les données sont le point de départ, mais ce qui en émerge est un réseau qui s'adapte, apprend en continu et apporte le bon contexte à chaque interaction avec l'IA.
Vu sous cet angle, cela devient évident : les LLM ne sont pas la seule puissance cognitive dans les systèmes d'agents. Le système de contexte l'est aussi.
