






Aujourd'hui, la recherche fédérée connaît un regain d'intérêt, stimulée par de nouveaux connecteurs d'OpenAI, Google Agentspace, et par des protocoles ouverts comme le Model Context Protocol (MCP). De nombreuses entreprises se posent désormais la question : les LLM ont-ils trouvé un raccourci pour ancrer les agents dans le contexte d'entreprise, modifiant ainsi fondamentalement le besoin d'un index ?
Lorsque nous avons lancé Glean, la recherche grand public était arrivée à maturité, fruit de décennies de progrès en recherche d'information et en machine learning à grande échelle. La recherche d'entreprise, en revanche, demeurait un problème non résolu. Les connaissances organisationnelles étaient fragmentées entre des centaines d'applications SaaS, chacune dotée de son propre modèle de données et de ses propres schémas d'accès. Délivrer de la pertinence nécessitait souvent un réglage laborieux, qui produisait malgré tout des résultats de faible qualité.
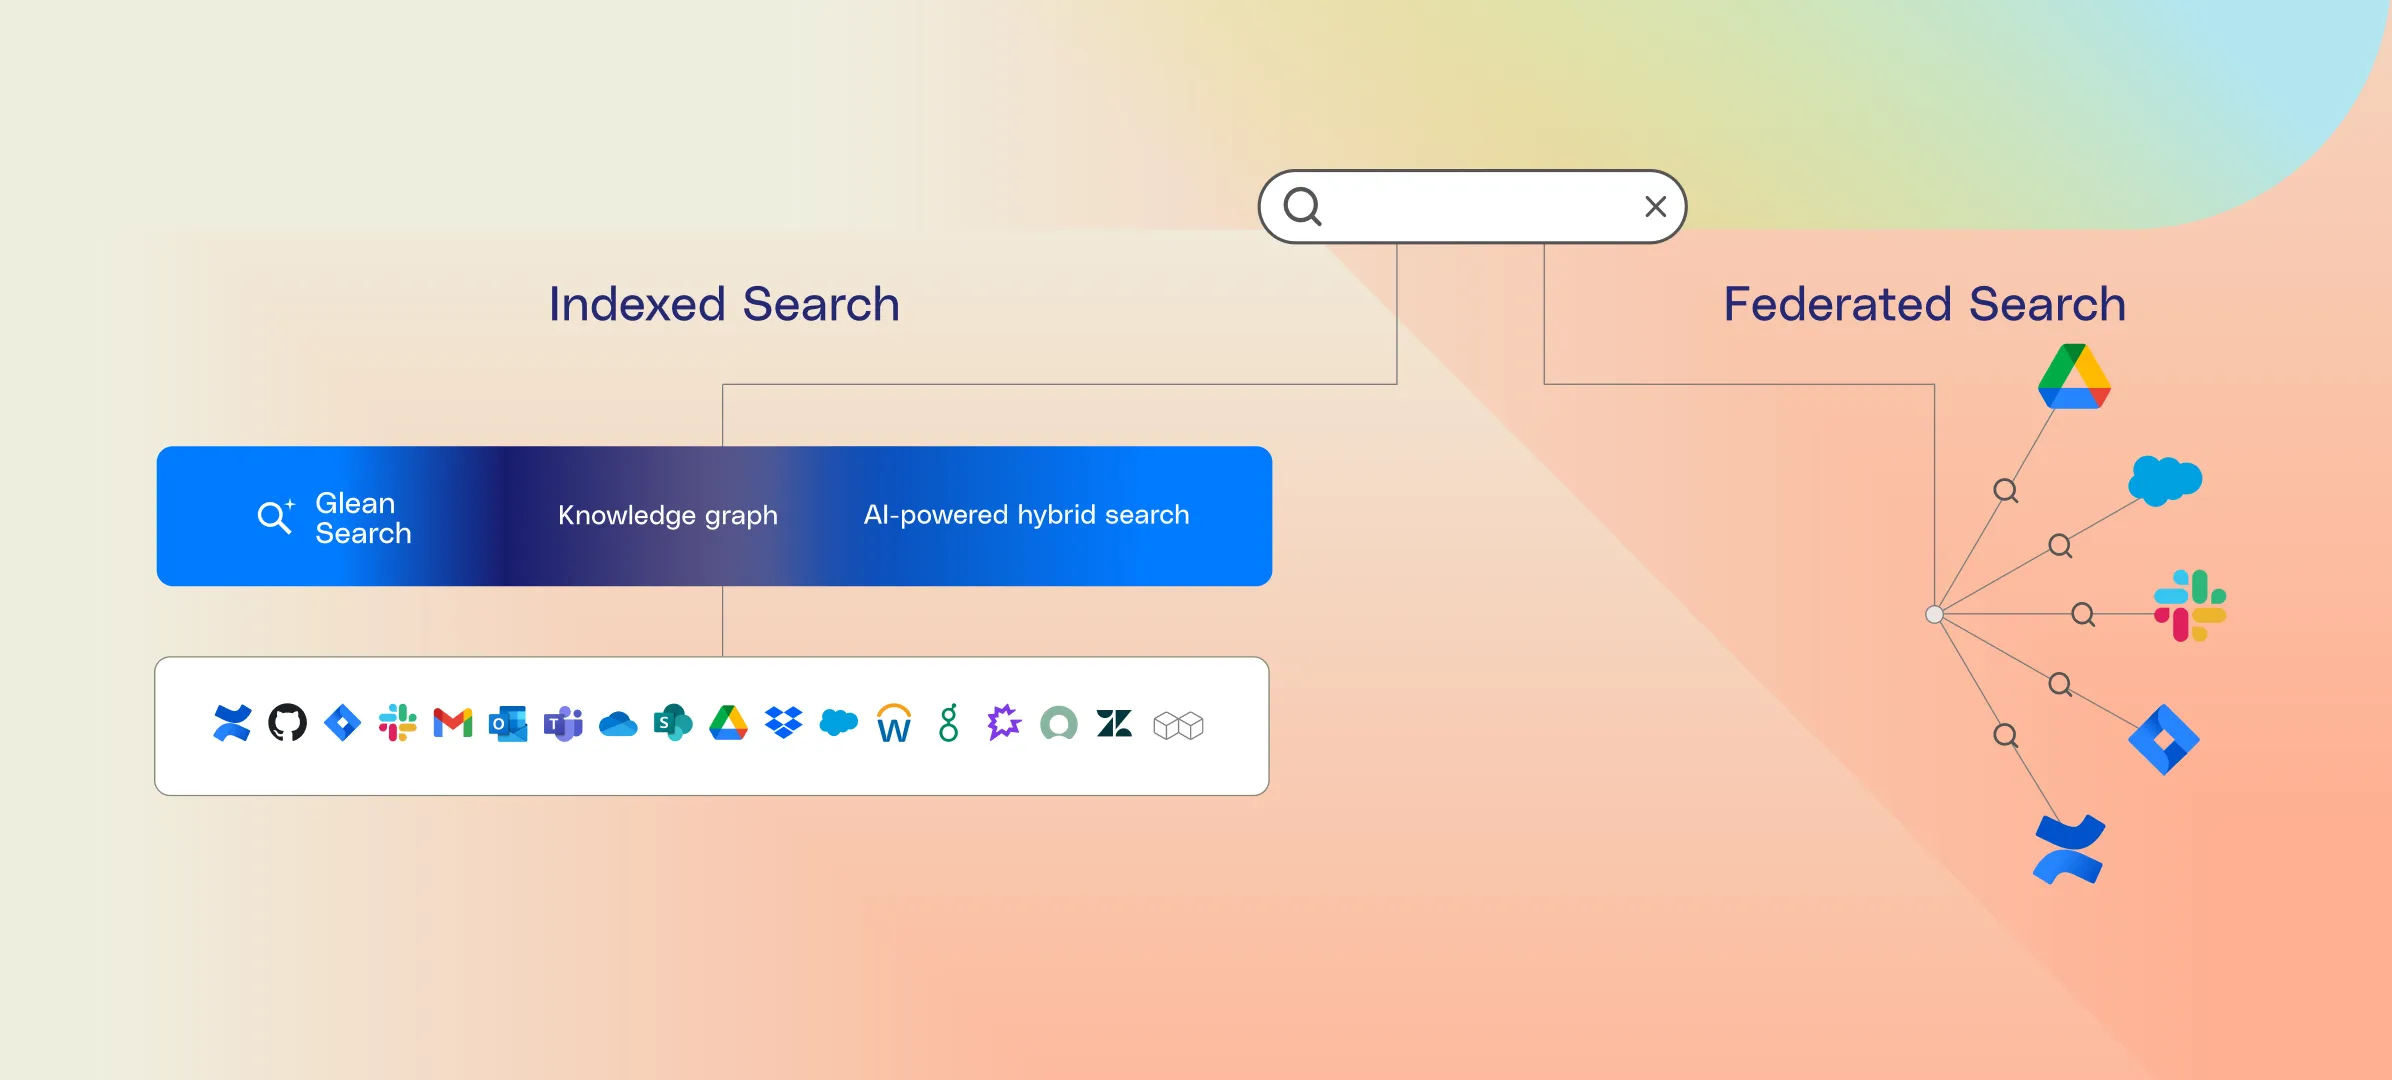
Dès le départ, nous étions convaincus que les utilisateurs en entreprise méritaient une recherche à la hauteur de la rapidité, de la précision et de l'intuitivité de la recherche grand public. Cependant, nous avons compris que ce niveau ne pouvait pas être atteint avec la recherche fédérée. La recherche fédérée produit des résultats partiels et sujets à la latence, du fait des incohérences entre modèles de données et de l'absence d'un classement unifié.
Au contraire, une véritable recherche d'entreprise exige une infrastructure fondamentale et du machine learning appliqué : des connecteurs, des robots d'exploration, une normalisation des données, des index tenant compte des autorisations, des graphes de connaissances et un moteur de classement adapté au contexte d'entreprise.
Au fil des années, Glean a massivement investi dans la construction de cette pile technologique — menant des centaines d'expériences A/B, adaptant son architecture pour prendre en charge de nouvelles modalités de données et l'évolution des limites de débit des API, et montant continuellement en charge face à la complexité croissante des écosystèmes SaaS modernes.
Les LLM ont transformé notre façon d'interagir avec l'information, mais, loin de rendre les index obsolètes, ils les ont rendus encore plus essentiels. Les index continuent d'offrir le moyen le plus rentable et le plus performant d'ancrer les systèmes intelligents dans les connaissances de l'entreprise.
Les inconvénients de la recherche fédérée
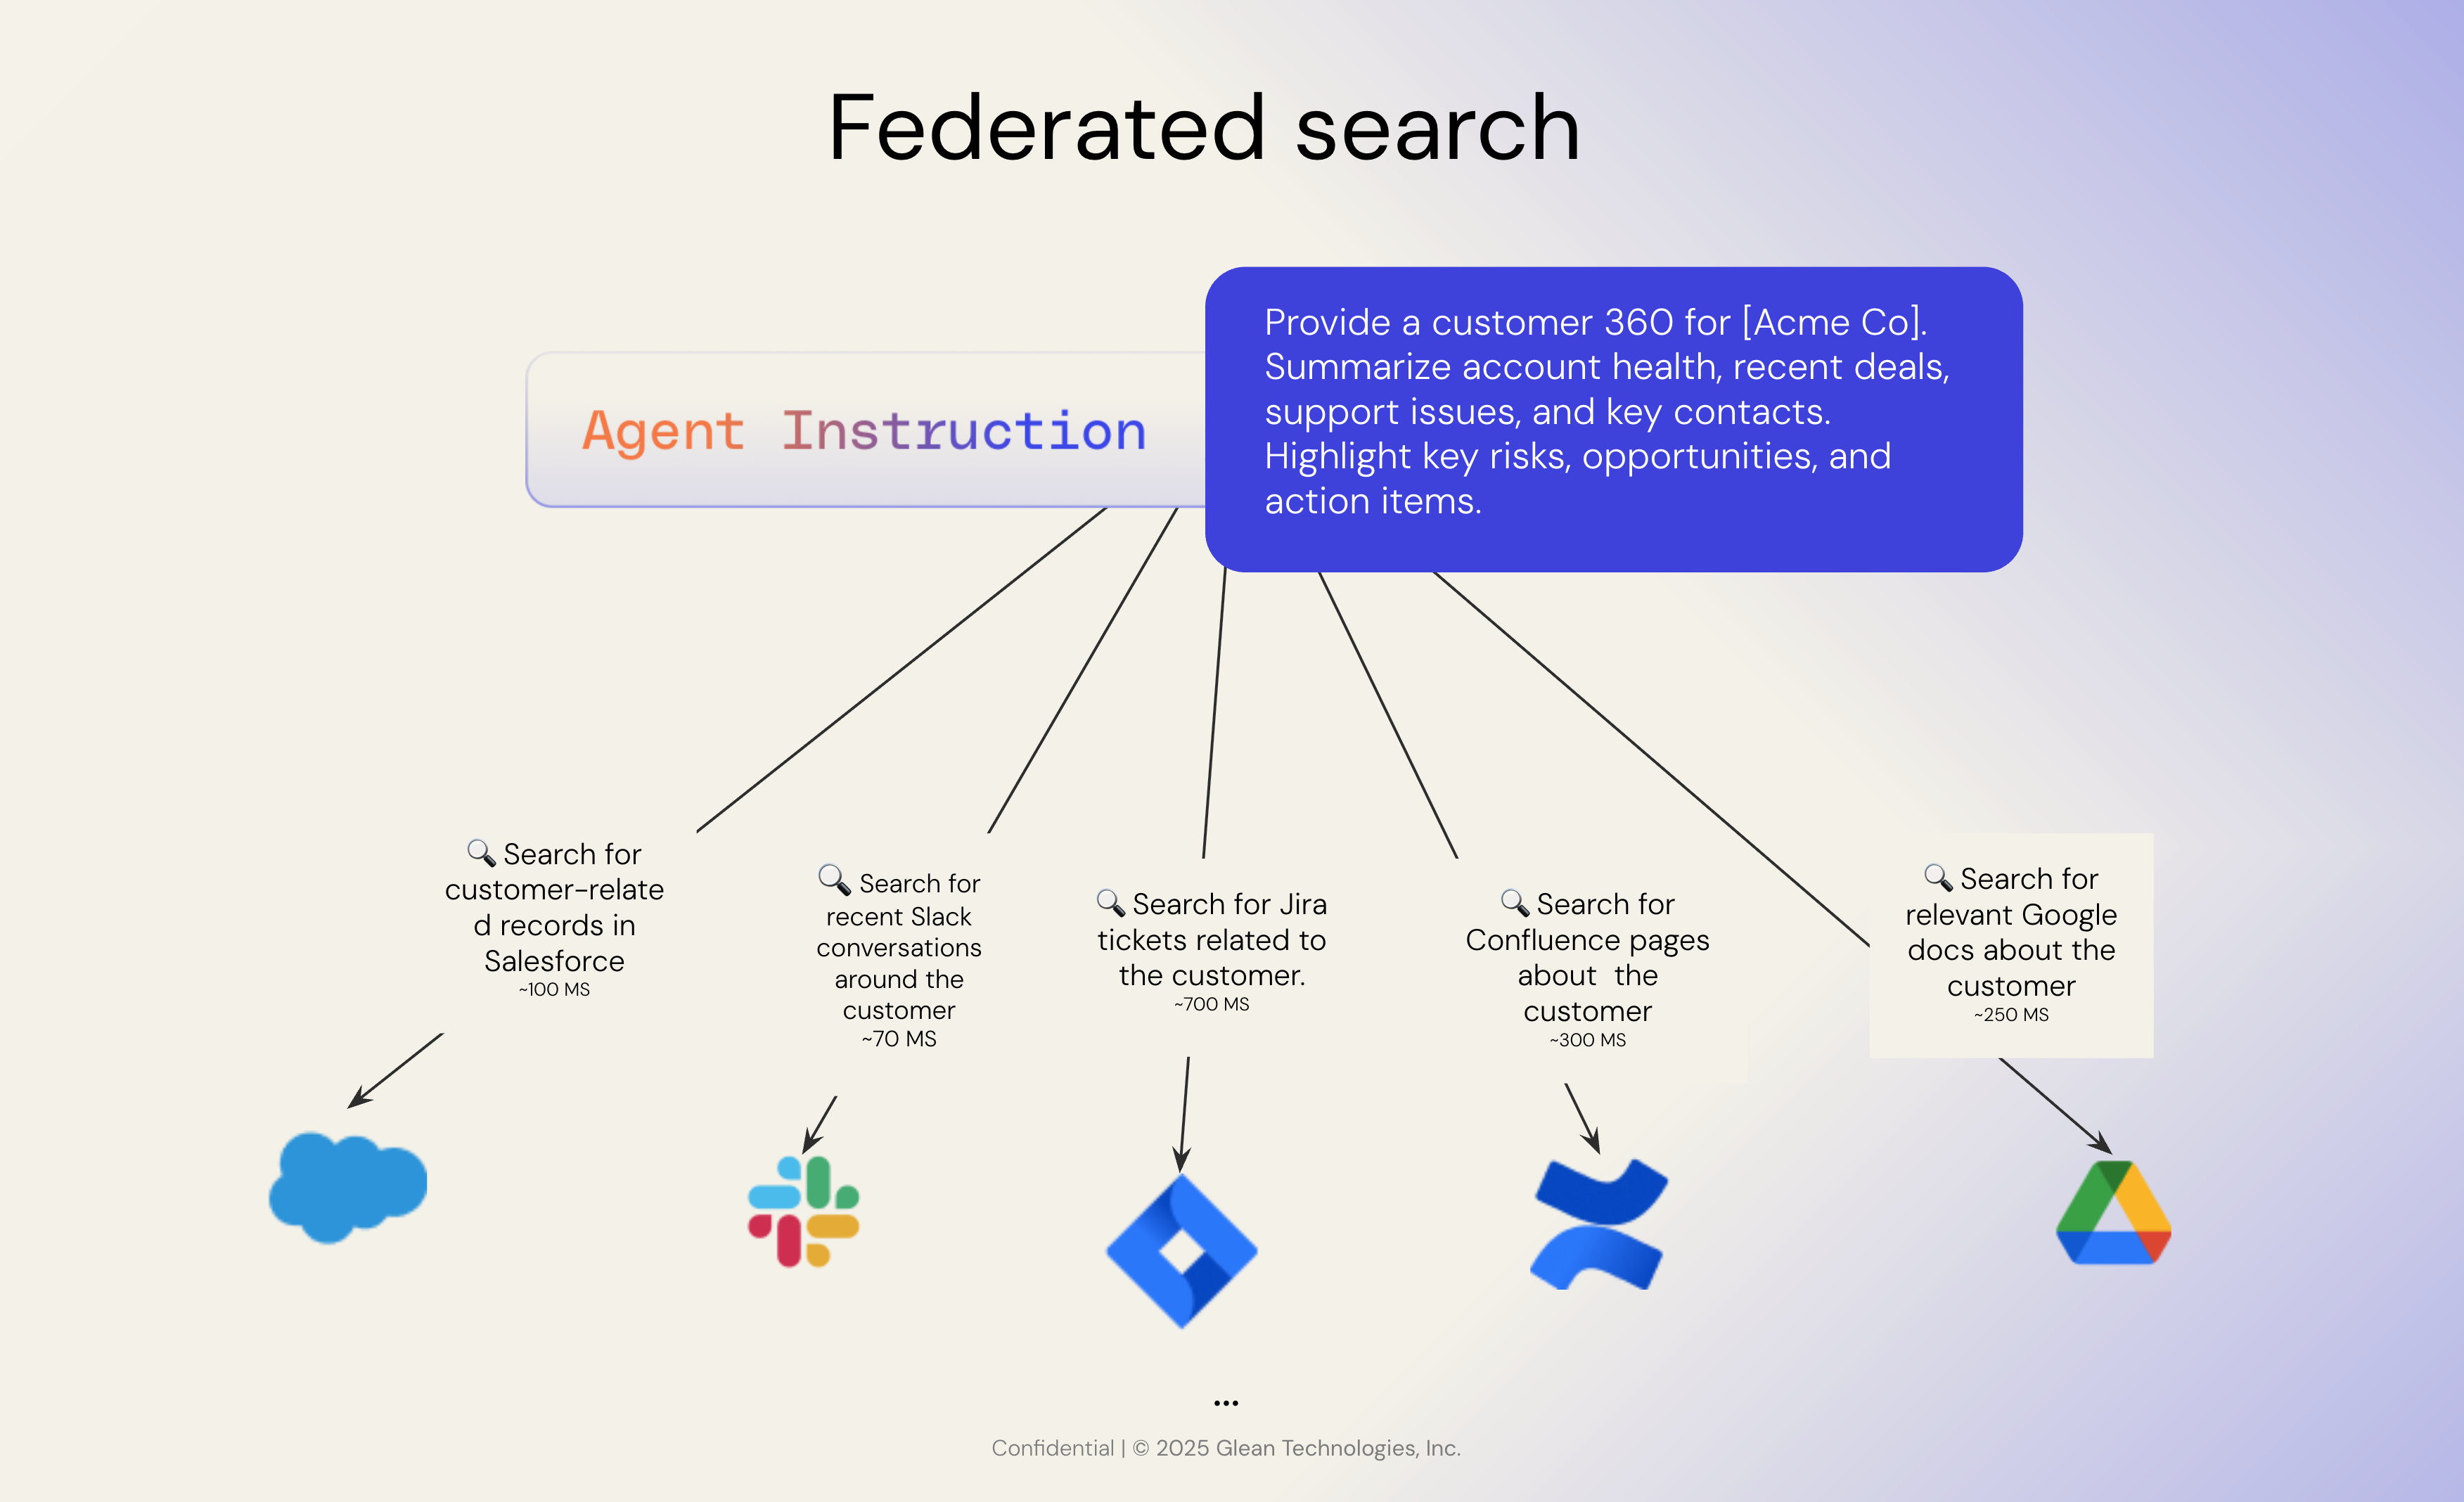
La recherche fédérée envoie les requêtes des utilisateurs à de multiples sources de données externes — comme Google Drive, Jira ou Salesforce — en temps réel. Chaque source exécute la requête de manière indépendante et renvoie des résultats distincts. Enfin, le système fédéré agrège ces résultats en une seule liste pour l'utilisateur. Cela paraît simple, mais c'est une solution sous-optimale dans les grands environnements d'entreprise.
1. De multiples appels d'API, tous à des vitesses différentes
La recherche fédérée nécessite d'appeler chaque application individuellement en parallèle, puis d'attendre que toutes les réponses reviennent avant d'afficher les résultats. En entreprise, cela peut signifier interroger des dizaines de sources. Comme chaque API répond à son propre rythme, vous êtes aussi rapide que le système le plus lent. Cela conduit à une expérience de recherche saccadée et incohérente.
2. Limitée aux données authentifiées par l'utilisateur
La plupart des systèmes fédérés ne renvoient que les résultats que l'utilisateur actuel est autorisé à consulter via l'API. Cela signifie que vous êtes souvent limité à la part de données personnelles de cet utilisateur, en passant à côté du contexte organisationnel plus large qui donne toute sa valeur à la recherche — comme la popularité des documents, les signaux de collaboration et l'identité des autres personnes de l'entreprise qui interagissent avec ce contenu. Sans ces métadonnées, le contenu manque de pertinence. L'avantage de l'authentification par utilisateur est qu'elle permet une recherche facilement gérée par autorisations ; l'inconvénient, c'est qu'il lui manque un contexte essentiel.
3. Des API de recherche incohérentes et de faible qualité
Chaque application tierce possède sa propre API, souvent conçue pour une récupération basique et non pour une recherche de niveau entreprise. Beaucoup sont lentes, incomplètes ou mal entretenues. Ces API ne sont pas optimisées pour la pertinence de recherche ; elles sont souvent fournies par commodité, et non comme un produit central. La plupart des éditeurs SaaS ne prétendent pas être des experts de la recherche, et certaines API se résument à une simple recherche par mots-clés.
4. Un classement simple, basé sur des règles
Comme il n'existe pas d'index centralisé, les systèmes fédérés ne peuvent pas normaliser les données entre les sources. Il devient alors impossible d'appliquer un modèle de classement cohérent. Vous êtes ainsi contraint d'utiliser une logique simpliste, basée sur des règles, incapable de raisonner sur des formats de données hétérogènes. Vous pouvez choisir de privilégier certaines sources de données par rapport à d'autres, en vous appuyant sur de simples heuristiques fondées sur les schémas de requêtes.
Dans l'exemple de recherche fédérée, je pourrais choisir de pondérer les résultats uniquement en fonction de leur source de données. Mais cela risque d'exclure des résultats hautement pertinents — simplement parce qu'ils proviennent d'une source de moindre priorité — ce qui signifie qu'ils pourraient ne pas intégrer la fenêtre de contexte du LLM lors de la génération d'une réponse.
5. Le filtrage pâtit du plus petit dénominateur commun
Si l'un des systèmes connectés ne prend pas en charge un filtre spécifique — par exemple, le filtrage par date de dernière modification — alors ce filtre ne peut pas être appliqué à l'ensemble des résultats. Cela crée un effet de plus petit dénominateur commun, où les limitations de l'API la plus faible définissent les capacités de votre expérience de recherche.
Si la recherche fédérée suscite un regain d'intérêt grâce à MCP, qui simplifie la connexion entre les systèmes, elle n'améliore pas réellement la qualité des résultats de recherche — ce qui est pourtant essentiel lorsque ces résultats sont transmis aux LLM. MCP est un protocole de communication — une sorte de « port USB-C » pour les applications d'IA, qui permet l'interopérabilité — mais il ne traite pas de la pertinence. Chez Glean, nous voyons MCP comme un moyen puissant d'étendre notre système de contexte aux agents conçus partout, en les ancrant de manière sécurisée dans les données d'entreprise. C'est pourquoi nous avons investi dans des serveurs MCP hébergés et adopté l'interopérabilité des agents — afin de rendre notre moteur de recherche et de raisonnement disponible partout où les agents s'exécutent.
Comment les index font la différence
L'analogie la plus simple pour un index, c'est l'index à la fin d'un livre : il associe des termes à des emplacements, facilitant la recherche d'information. C'est le fondement de la recherche traditionnelle par mots-clés — et il joue encore un rôle essentiel. Mais avec l'avènement de modèles de langage comme BERT, la recherche d'entreprise a évolué. Ces modèles ont introduit une compréhension plus profonde du langage en encodant le sens dans des vecteurs de grande dimension — nous faisant passer de la correspondance exacte à la compréhension sémantique.
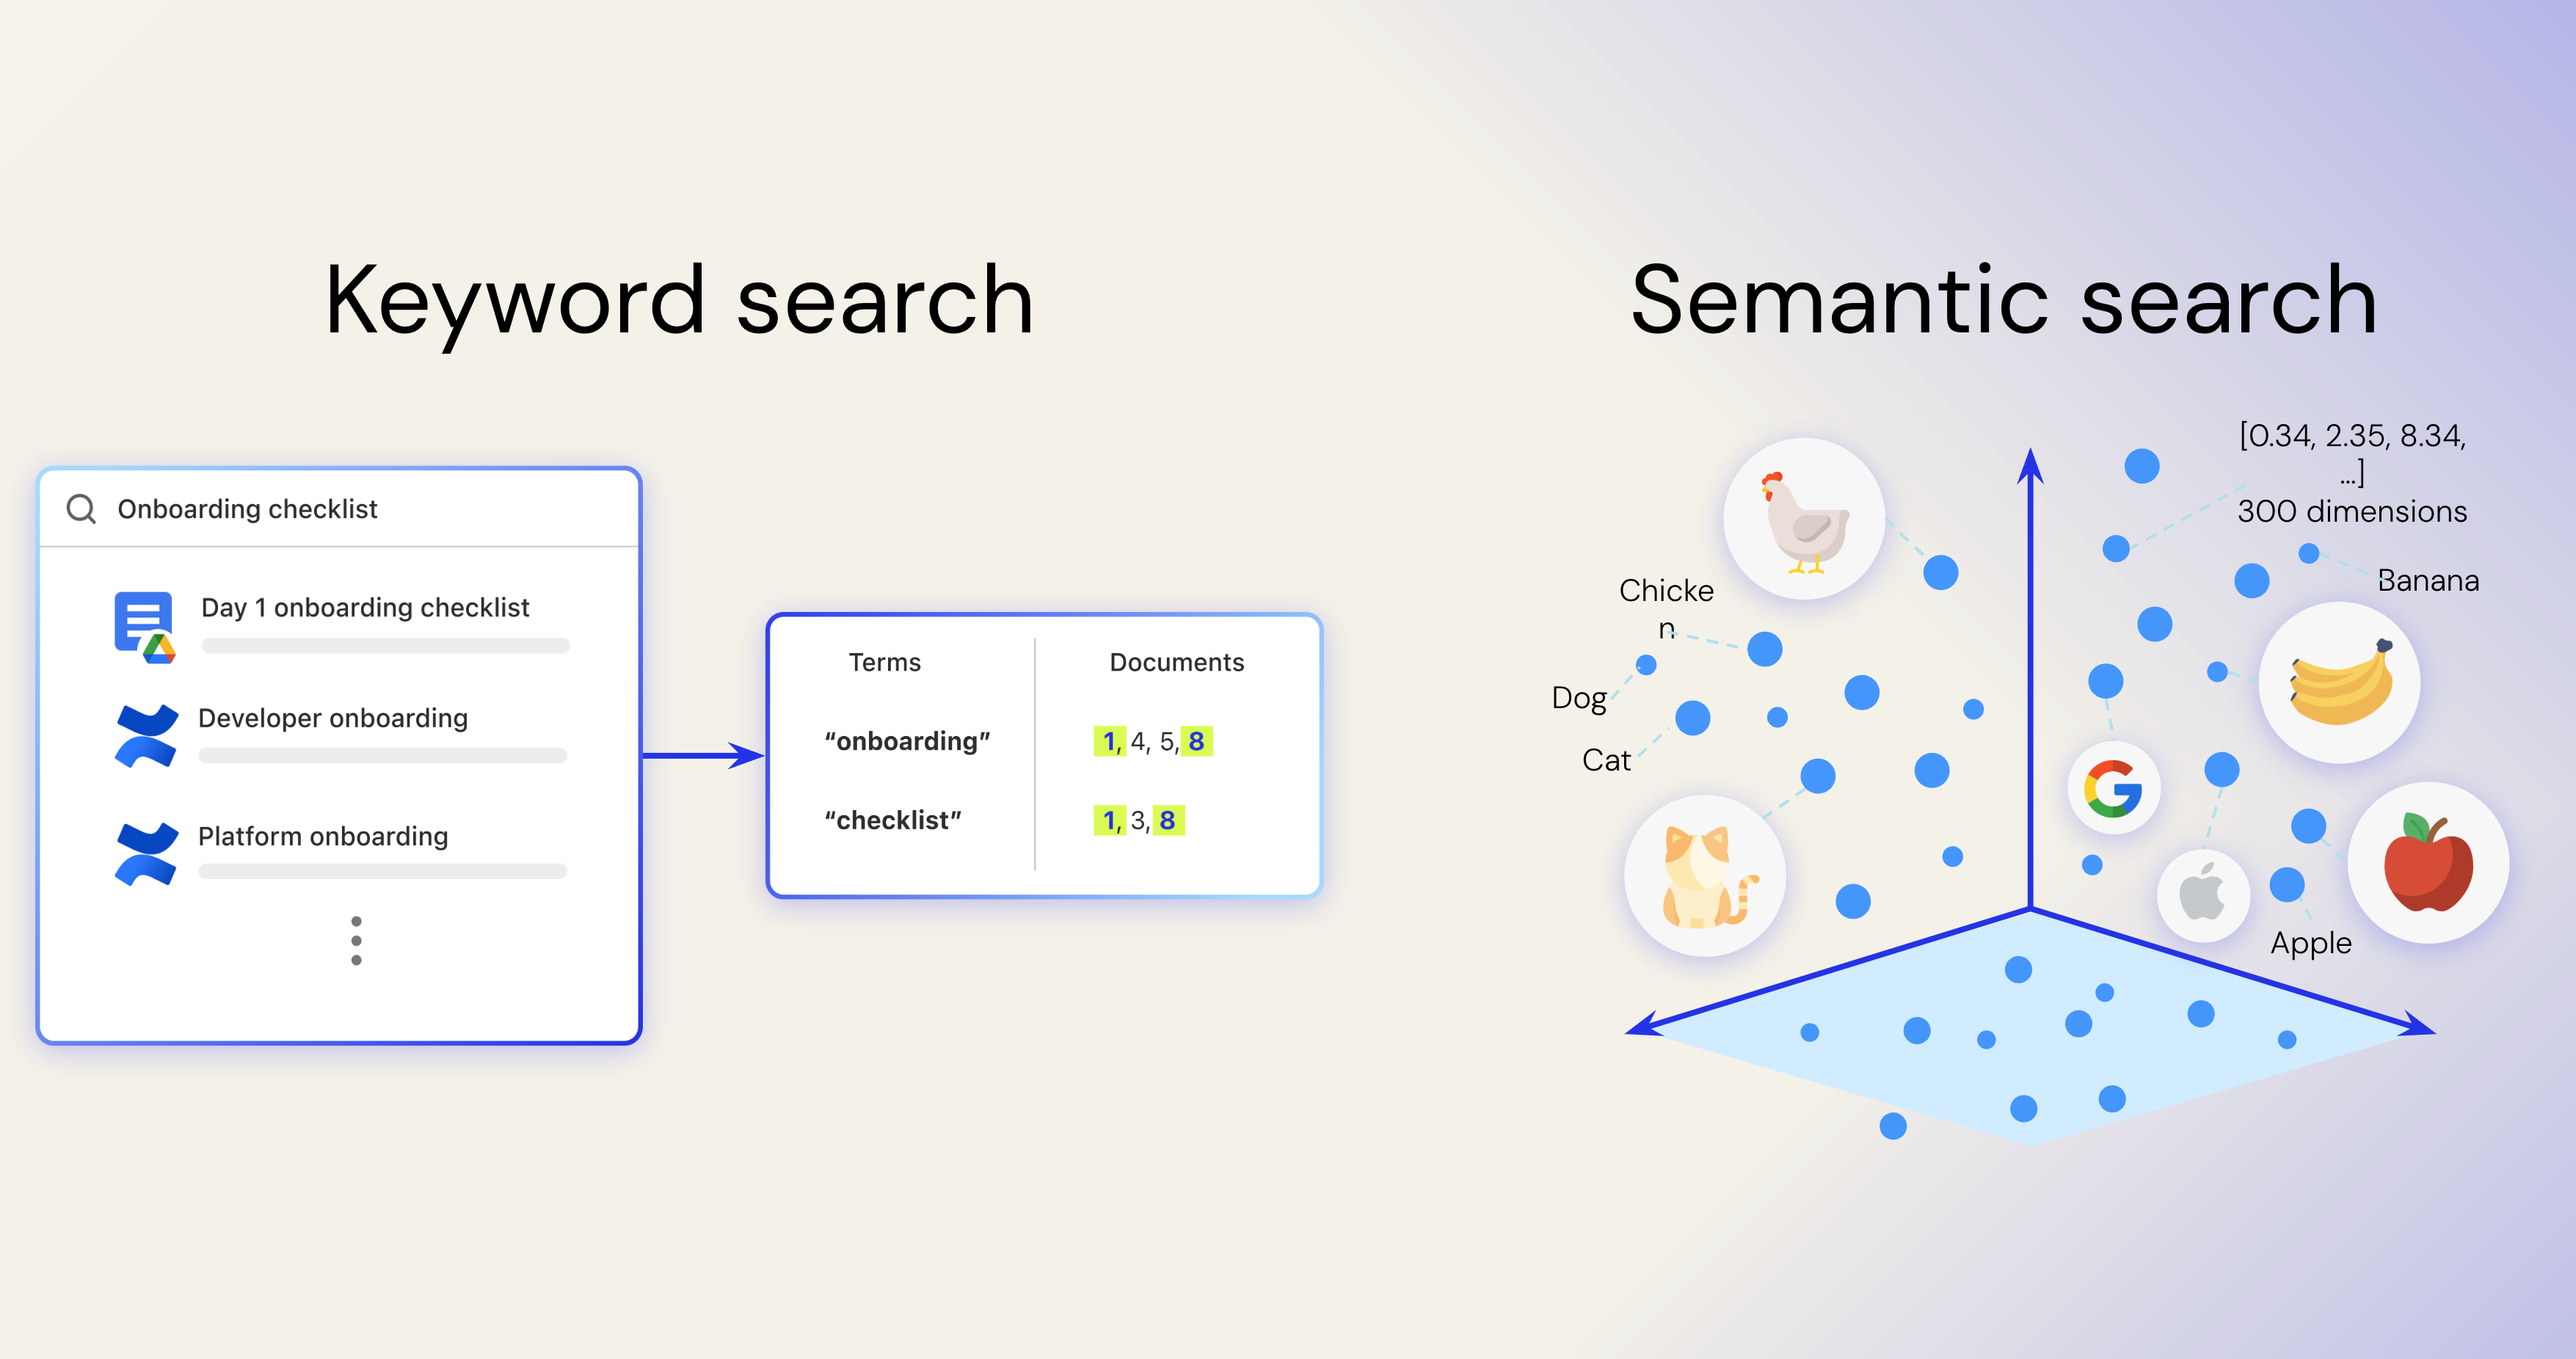
Comme toute structure de données, les index nous permettent de comprendre et d'exploiter les données sous-jacentes pour une récupération rapide et efficace.
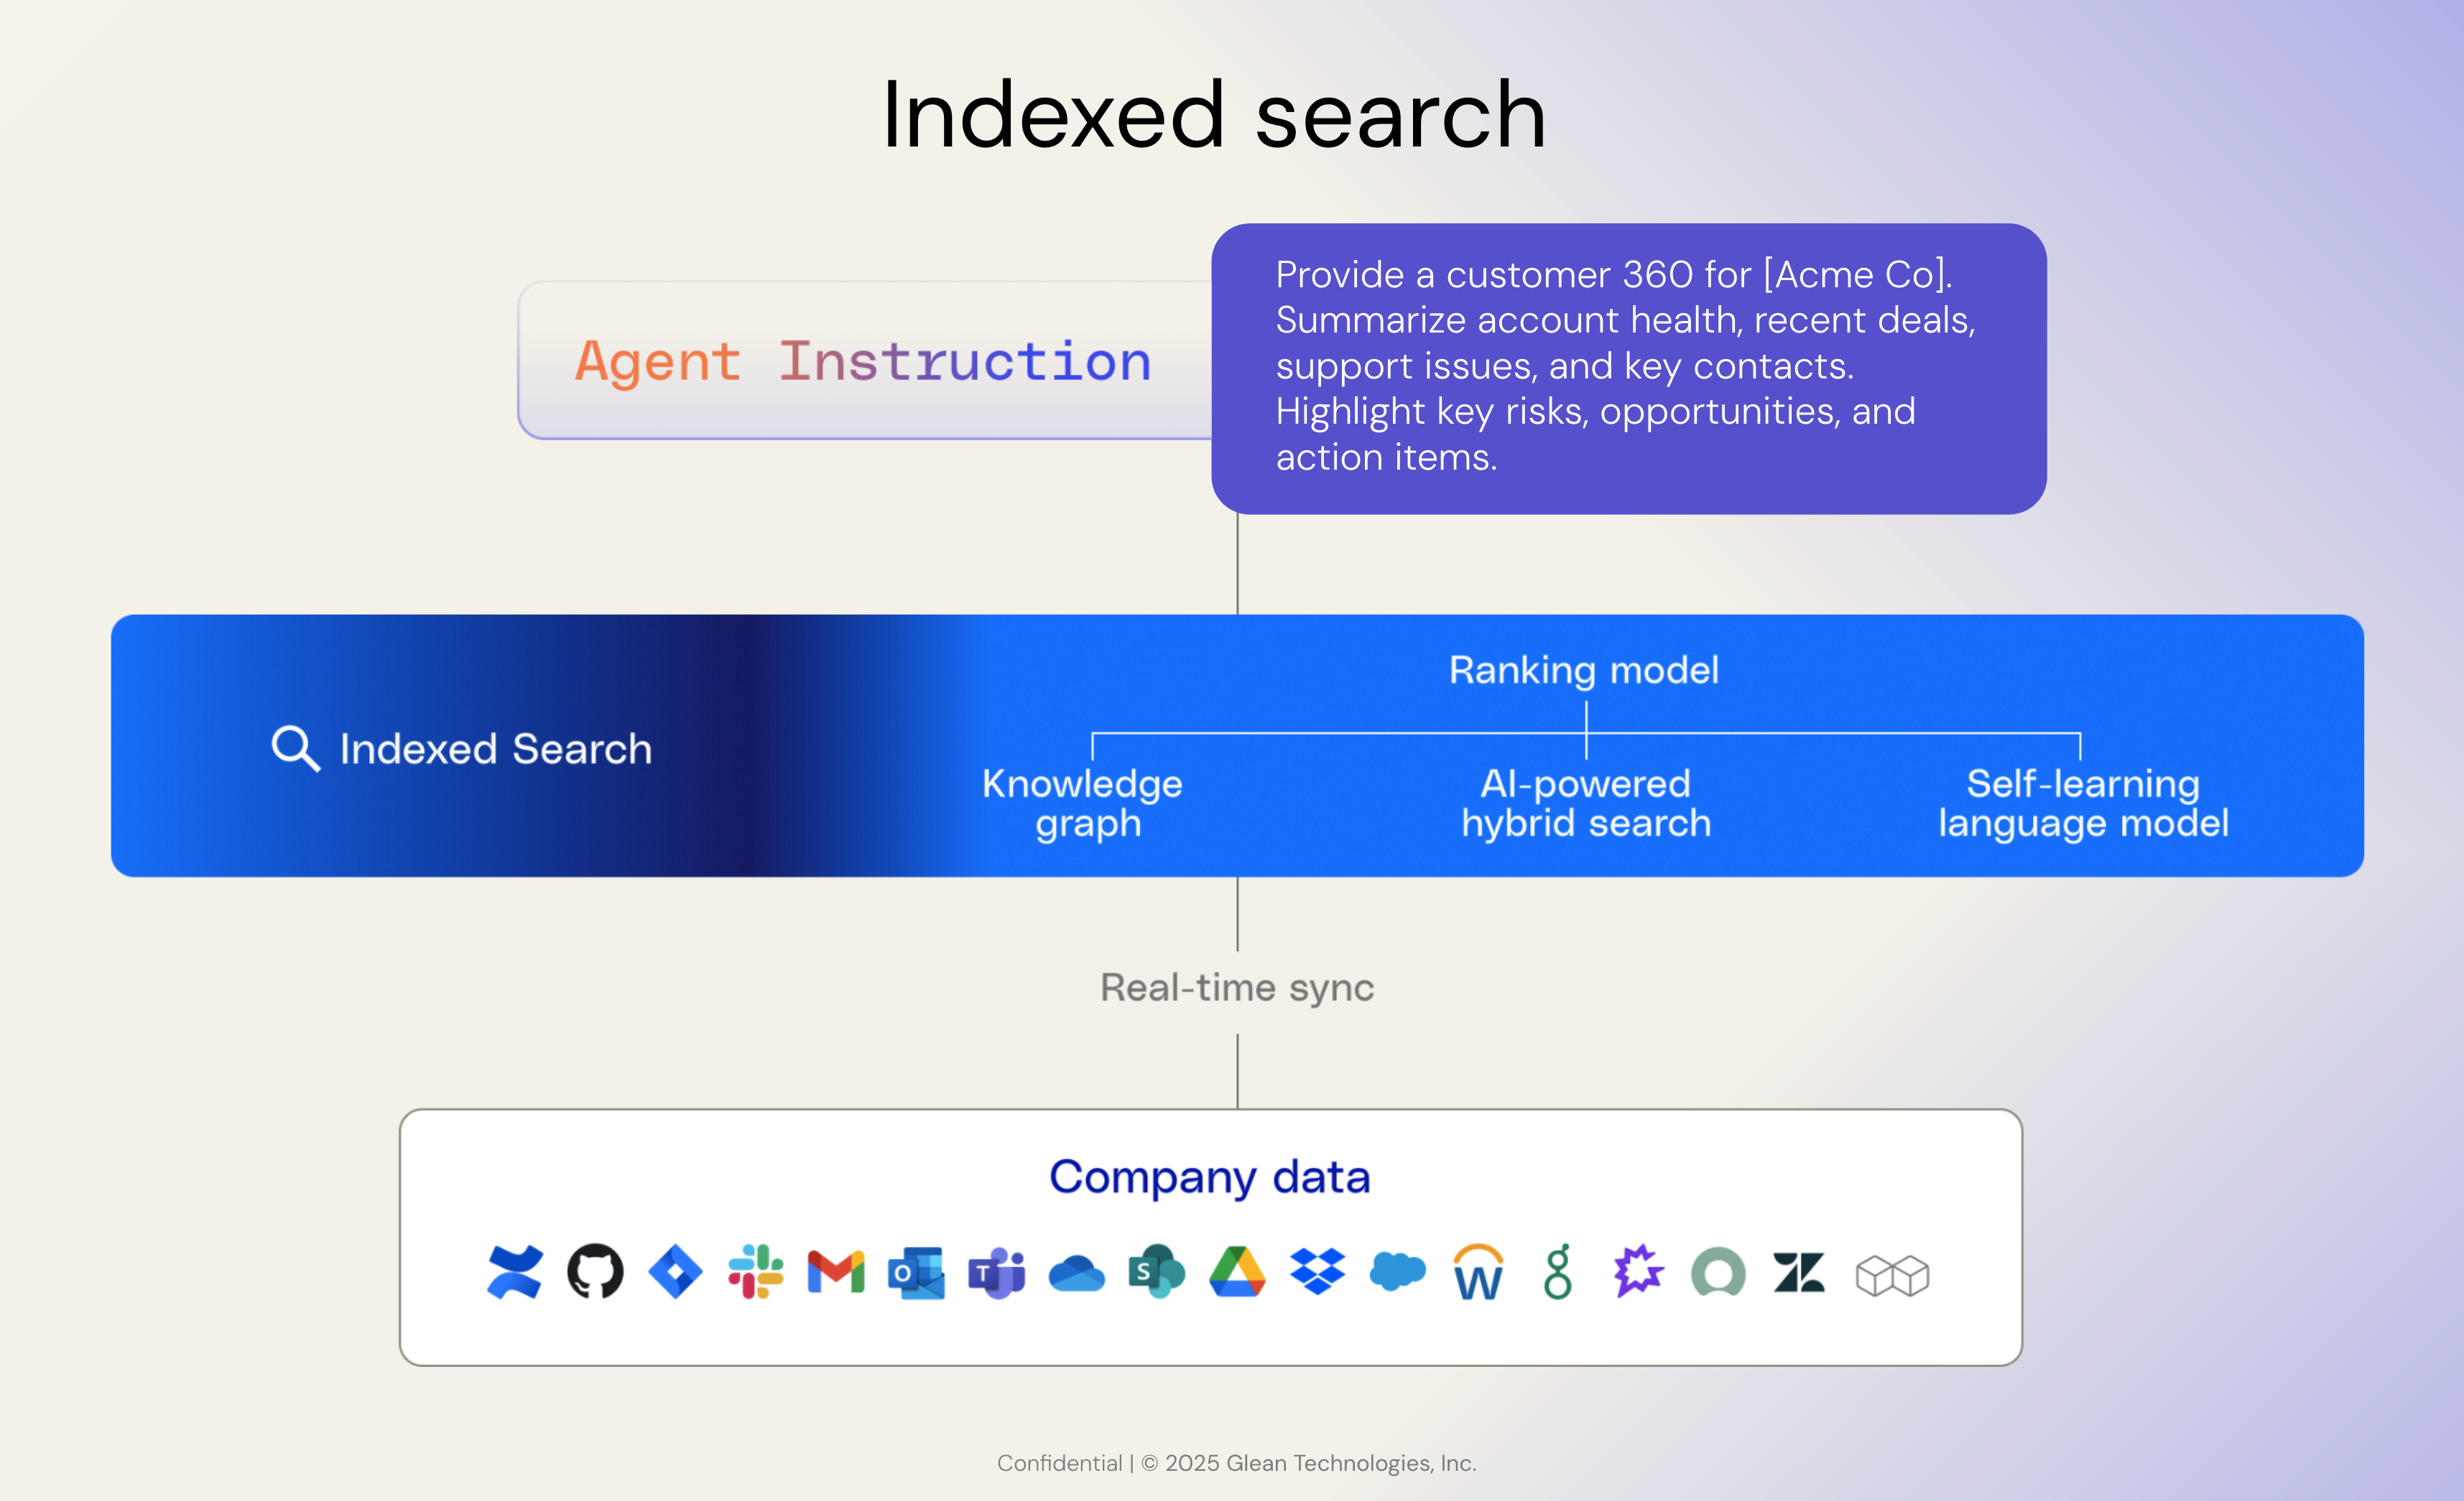
Les index pour la recherche d'entreprise constituent une catégorie à part entière et s'accompagnent des problèmes complexes de systèmes et de science suivants :
1. Crawlers personnalisés
Vous devez déterminer ce qu'il faut explorer, comment respecter les limites de débit et comment extraire non seulement le contenu, mais aussi les autorisations et les métadonnées. Les crawlers doivent être hiérarchisés intelligemment — les données d'autorisation comptent souvent plus que le contenu — et ils ont besoin d'une logique de temporisation et de nouvelle tentative pour gérer avec élégance les limitations de débit et les échecs d'API.
2. Indexation et classement adaptés à l'entreprise
Les méthodes lexicales comme BM25 et TF-IDF supposent des données homogènes — ce qui manque aux applications d'entreprise diverses. Une recherche efficace nécessite de concevoir et d'affiner des algorithmes d'indexation adaptés à la complexité du contenu d'entreprise. Par exemple, les commentaires sont un contenu à faible valeur qui se déprécie plus rapidement avec le temps, et les messages sans titre dans Slack nécessitent une logique personnalisée. Cela signifie que l'algorithme d'indexation doit comprendre la conception et la valeur de chaque application individuelle.
La recherche sémantique a été fondamentale pour la recherche d'entreprise. Elle a permis aux systèmes de recherche d'aller au-delà des mots-clés littéraux, en apprenant comment les noms internes se rapportent aux concepts. Chez Glean, nous désignons en interne notre « moteur de requête » comme « Scholastic » plutôt que le magazine pour enfants ; la recherche sémantique est capable de faire cette association. En s'entraînant sur un corpus d'entreprise unique, les index sémantiques peuvent trouver un contenu qu'une recherche fédérée manquerait.
3. Compréhension au niveau des entités grâce aux graphes de connaissances
Un index seul ne capture pas les relations. Savoir simplement qu'un terme apparaît dans un document ne suffit pas — vous devez comprendre à quoi ce terme fait référence. S'agit-il d'un client ? D'une technologie ? D'un collègue ?
Les humains établissent naturellement ce genre d'associations lorsqu'ils lisent du contenu, mais les LLM ont besoin d'un contexte structuré pour en faire autant. Sans cela, ils peuvent confondre des termes qui se ressemblent et formuler des hypothèses erronées. Cela arrive souvent avec les noms de produits ou les versions en entreprise — comme Gemini 2.5 Pro et Gemini 2.0 Flash. Un LLM pourrait accidentellement confondre les deux, entraînant des réponses inexactes.
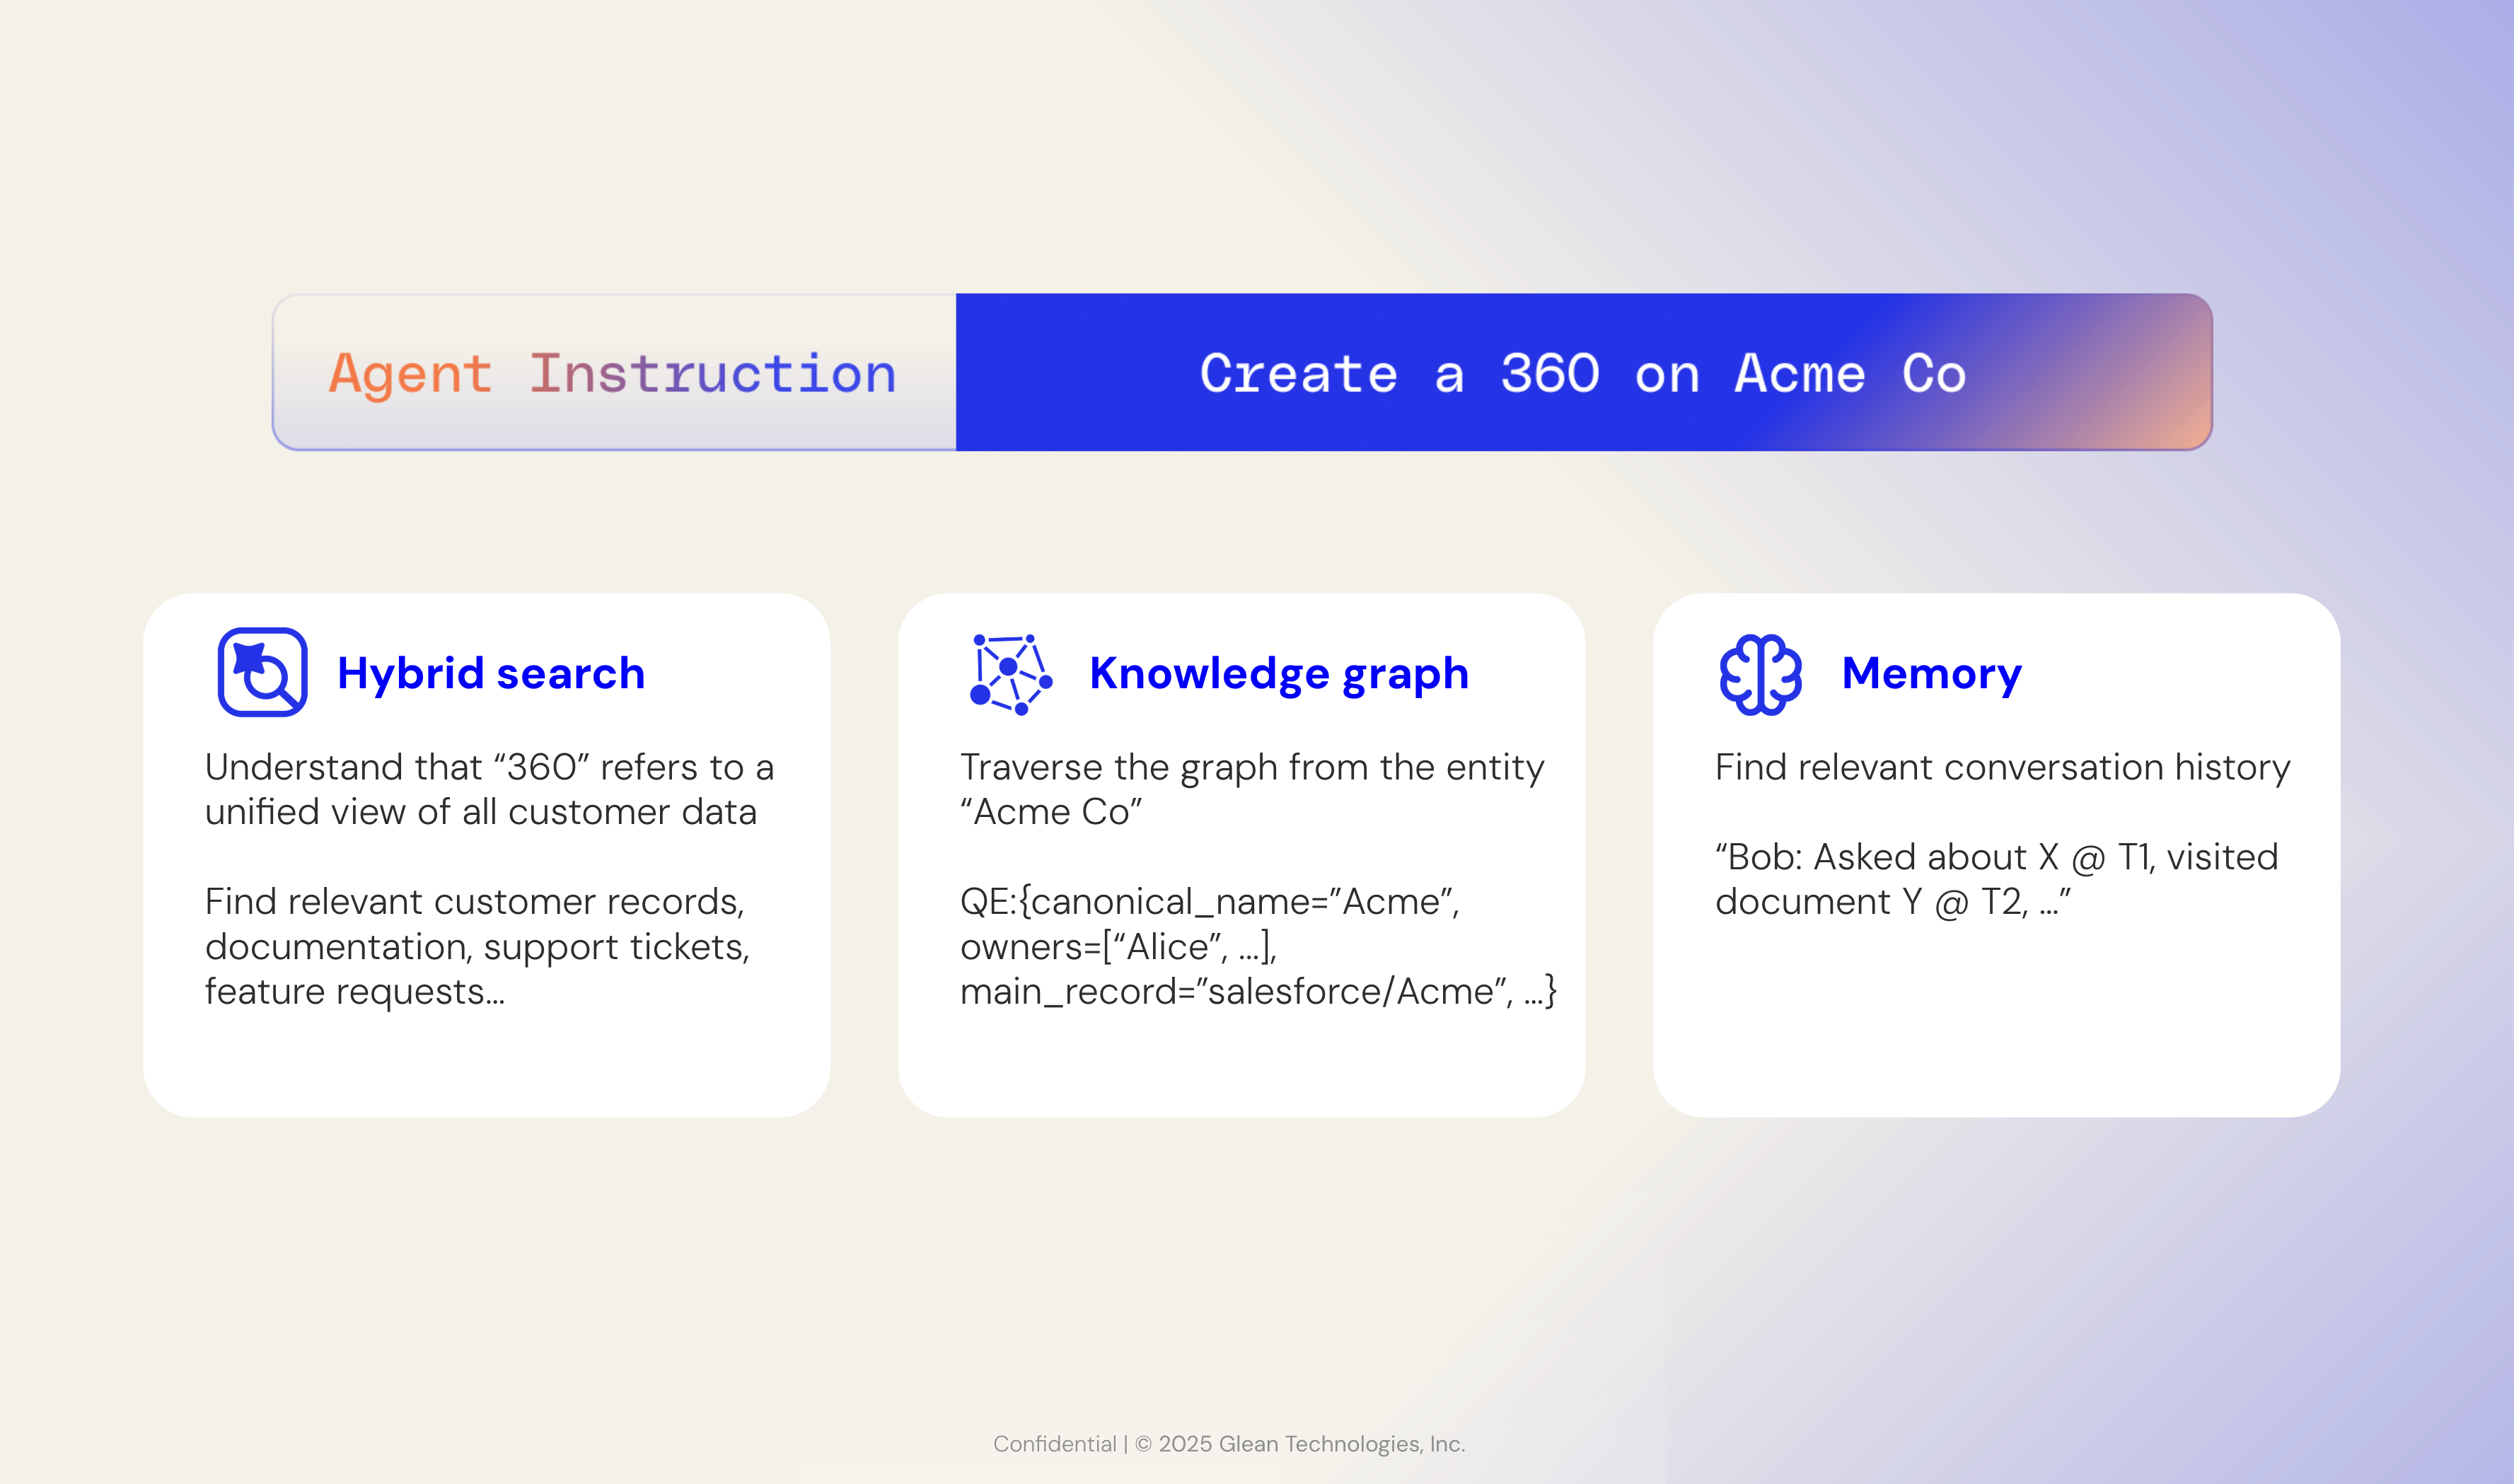
4. Expérimentation continue
La recherche n'est pas statique. Vous devez mener des expériences en direct pour améliorer les résultats de recherche et des agents. Il y a aussi toujours de nouvelles entités et de nouveaux points de données à ajouter à une expérience de recherche.
Chez Glean, nous avons mené des centaines d'expériences pour déterminer les solutions suivantes concernant l'autorité, les déploiements à démarrage à froid et l'évolution des schémas de recherche avec l'essor de la recherche sémantique et des agents :
- Déploiement à démarrage à froid : nous amorçons les nouveaux environnements avec des données d'entraînement publiques et synthétiques de haute qualité pour offrir de la valeur dès le premier jour.
- Classement sensible à la pertinence thématique : met en avant le contenu intemporel comme les politiques RH, même s'il est ancien ou rarement consulté.
- Boucles de calibration : nous affinons en permanence nos modèles de classement à apprentissage autonome pour nous adapter à l'évolution des comportements, des cas d'usage et des schémas de requête.
Au cours des dernières années, nous avons vu les schémas de recherche en entreprise évoluer. Les requêtes courtes par mots-clés ont évolué vers des questions plus longues et plus ouvertes — portées par l'essor de l'IA. De nouveaux schémas de requête et d'agents émergent également : énumération, ticketing, recherche d'experts, vues client 360, et bien plus — reflétant les diverses façons dont les gens interagissent avec l'IA au travail. À mesure que les manières dont les gens génèrent et interagissent avec les données se multiplient, l'intelligence de recherche sous-jacente doit elle aussi évoluer.
Le rôle des index avec les LLM
Même avec des LLM puissants, s'appuyer sur des données d'entreprise indexées — plutôt que d'entraîner des modèles dessus — offre une approche plus sûre et plus flexible. L'indexation étend les connaissances d'un modèle sans intégrer les données sensibles directement dans le modèle, en gardant les informations sécurisées et gouvernées grâce à une récupération tenant compte des autorisations. Contrairement aux modèles affinés, qui deviennent statiques et difficiles à mettre à jour, les données indexées restent vivantes et réactives aux changements — garantissant des résultats conformes et à jour. Les LLM seuls ne suffisent pas pour une IA d'entreprise sécurisée.
On observe une tendance croissante vers des fenêtres de contexte plus grandes, donnant aux LLM accès à plus de données lors de la prise de décision. Une question courante qui en découle est : si le modèle peut voir davantage, la précision de la recherche compte-t-elle encore ? Chez Glean, nous avons constaté que la réponse est oui. Des fenêtres de contexte plus grandes ne corrigent pas de mauvais inputs — lorsque des informations contradictoires ou non pertinentes y sont entassées, cela entraîne souvent de la confusion et des réponses inexactes. Il ne s'agit pas seulement de la quantité de données que vous fournissez — il s'agit de sélectionner le bon contexte. Cela prend encore plus d'importance à mesure que nous passons de la recherche d'informations aux cas d'usage agentiques. La meilleure façon d'obtenir des résultats déterministes d'un agent est de fournir exactement les bonnes informations au LLM à chaque étape de l'agent.
Nous avons également constaté un intérêt pour l'association de connecteurs fédérés à un raisonnement approfondi. Si le raisonnement approfondi peut aider à masquer la latence de la recherche fédérée et permettre des appels LLM plus itératifs, il s'agit d'une solution de contournement coûteuse. Lorsque les données sont déjà indexées, les modèles peuvent répondre plus rapidement et raisonner plus profondément dans le même laps de temps. Sans cela, le LLM passe du temps à attendre des points de terminaison fédérés lents et compense l'imprécision par des cycles de raisonnement excessifs — ce que la recherche indexée évite.
Avec le passage des assistants aux agents, l'ancrage dans les données d'entreprise devient encore plus important, car les agents entreprennent des actions autonomes. L'index n'est qu'une pièce du puzzle : c'est la création de graphes de connaissances par-dessus l'index qui apporte le contexte aux agents. C'est essentiel pour les utilisateurs d'entreprise qui souhaitent un moyen simple d'exploiter les agents, en les dirigeant à l'aide d'instructions en langage naturel, tandis que le moteur de raisonnement agentique orchestre tout le contexte, les actions et les déclencheurs en coulisses.
Impossible d'atteindre cette expérience fluide sans un index centralisé couvrant l'ensemble des données d'entreprise horizontales. Négliger cet index revient à recréer pour l'IA les mêmes silos de données apparus avec le SaaS, ou à s'enfermer dans un ensemble de données restreint et bientôt obsolète pour chaque agent.
