






En 2025, le concept d’« agent » s’est véritablement imposé : une IA capable de raisonner, d’itérer et d’agir sur les données pour accomplir un travail réel. Depuis, nous avons assisté à une vague de technologies open source autour des agents : SDK d’agents, MCP, A2A, bibliothèques de compétences, bacs à sable et autres briques conçues pour les standards ouverts et l’interopérabilité. Cette ouverture compte. C’est elle qui permet aux agents d’assumer davantage de tâches : vous pouvez vous connecter à plus d’outils et pousser les agents au-delà d’une simple zone de chat, vers les IDE, les applications internes et les systèmes d’entreprise.
Les modèles qui animent ces agents sont devenus remarquablement meilleurs face au travail réel. Ils sont capables d’écrire et de corriger du code, de raisonner à travers des problèmes à plusieurs étapes, de générer des images complexes et de gérer des tâches de longue durée, même si ces progrès n’apparaissaient pas dans les benchmarks. En conséquence, nous avons constaté une spécialisation accrue des modèles : Claude pour le code, GPT pour le raisonnement, Nano Banana pour la génération d’images, avec un nouveau modèle « bluffant » tous les quelques mois qui ouvre de nouvelles possibilités. Cela ne fait que confirmer que l’avenir repose sur des modèles différents pour des tâches différentes.
Au cours de l’année écoulée, les équipes ont mis ces agents à rude épreuve pour voir combien de tâches ils pouvaient prendre en charge et quelle part d’« ingénierie du contexte » était nécessaire pour y parvenir. La question était partout la même : Que faut-il pour que les agents soient suffisamment fiables pour un usage en entreprise ? Chez Glean, nous l’avons constaté de première main dans la résolution de tickets d’assistance, la prévision des comptes commerciaux et le débogage en ingénierie.
Ce qui émerge désormais, c’est un passage des expérimentations ponctuelles d’agents à la création et à l’exploitation de dizaines, parfois de centaines, d’agents au sein d’une entreprise. Les collaborateurs utilisent individuellement des agents pour redéfinir leur productivité personnelle, et les départements repensent leurs processus métier fondamentaux au-delà des capacités des applications systèmes de référence. Les organisations veulent quelque chose d’évolutif : un contexte fiable, des moyens sûrs d’exploiter leurs données avec l’IA, et la capacité d’absorber les innovations fulgurantes des modèles et des outils sans avoir à reconstruire leur stack de zéro.
Nous assistons à la prise de forme de ce stack d’agents. On en voit des variantes chez tous les fournisseurs cloud, chez des plateformes de données comme Databricks et Snowflake, et chez des acteurs de systèmes de référence départementaux comme ServiceNow et Salesforce. Même les fournisseurs de modèles créent des plateformes d’agents, à l’image de Frontier d’OpenAI, présenté la semaine dernière.
Glean, bien sûr, propose une architecture d’agents qui s’appuie sur notre socle solide de contexte d’entreprise, de connectivité des données et de sécurité. Contrairement à la plupart, nous avons mis l’accent sur la transformation de notre produit en un stack ouvert à chaque couche. Aujourd’hui, je souhaite vous en dire plus sur cette stratégie horizontale et ouverte.
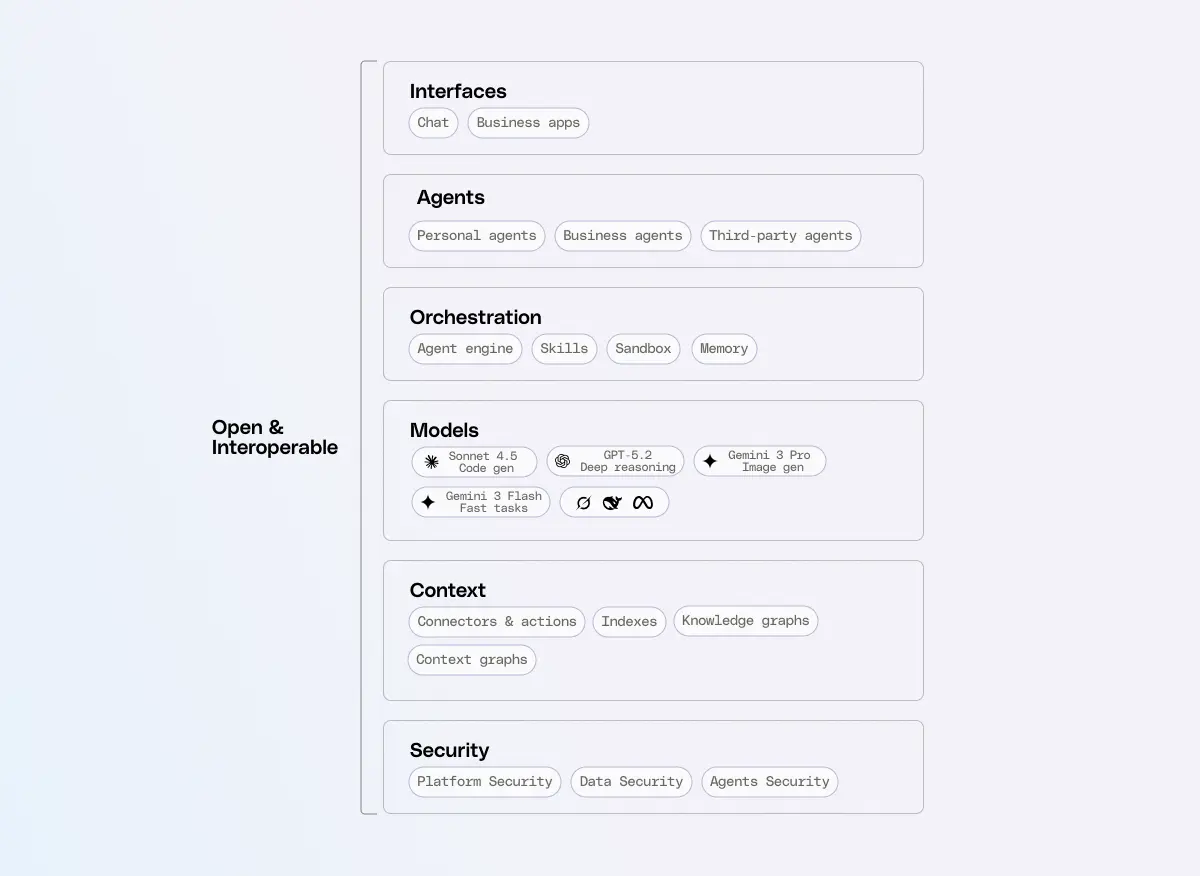
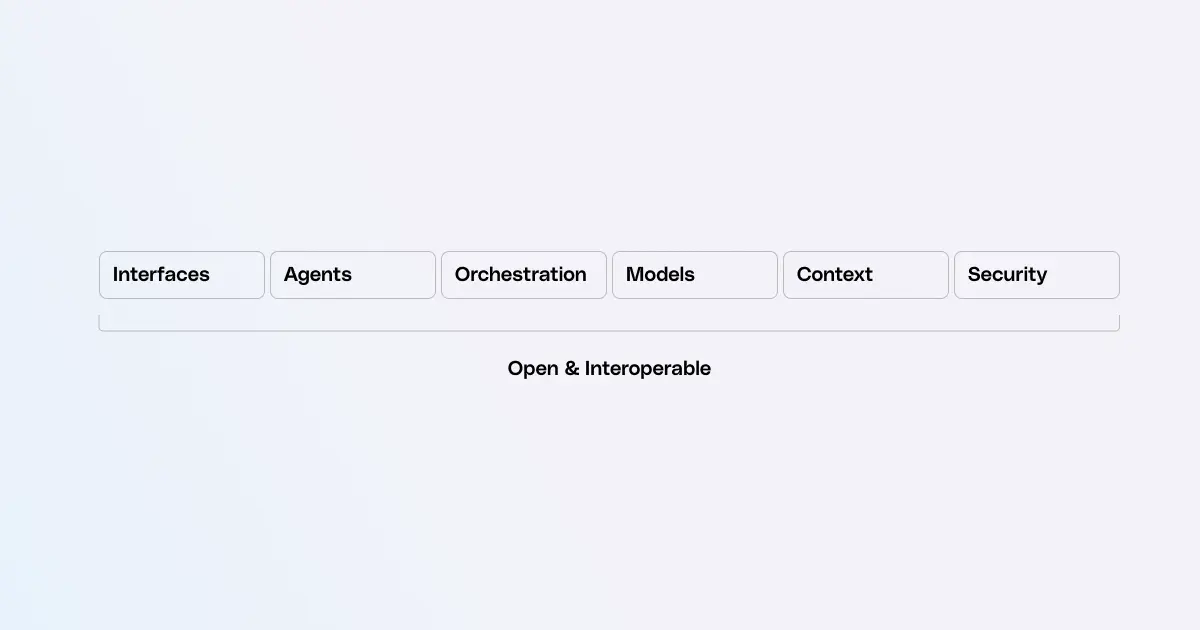
Ce que j’entends par stratégie ouverte, c’est que nous avons conçu l’architecture d’agents de sorte qu’elle ne soit la propriété d’aucun acteur ni d’aucune technologie unique. J’aime la voir comme un stack : les couches individuelles deviennent trop spécialisées pour qu’un seul fournisseur puisse toutes les dominer. La force d’un stack réside dans le fait que ses couches restent interopérables et se renforcent mutuellement : les progrès dans une couche démultiplient la valeur des autres.
Le rythme de l’IA est sans précédent. Plus que jamais, vous ne voulez pas être l’entreprise qui mise sur une plateforme monolithique qui vous enferme : parier sur un acteur unique crée un point de défaillance unique.
Le stack d’agents d’entreprise
Contexte
L’ingénierie du contexte a été définie en 2025 par Andrej Karpathy : « Dans toute application LLM de qualité industrielle, l’ingénierie du contexte est l’art et la science délicats de remplir la fenêtre de contexte avec exactement les bonnes informations pour l’étape suivante. Science, parce que bien le faire implique des descriptions et des explications de tâches, des exemples à quelques coups, le RAG, des données connexes (éventuellement multimodales), des outils, l’état et l’historique, la compaction... Trop peu ou sous la mauvaise forme, et le LLM n’a pas le bon contexte pour une performance optimale. Trop ou trop peu pertinent, et les coûts du LLM peuvent grimper tandis que la performance peut chuter. Bien faire cela est hautement non trivial. »
Cela a marqué un tournant : les modèles étaient enfin entraînés à l’utilisation d’outils, et MCP a émergé comme un standard qui a amené les outils dans un large éventail d’applications dotées d’IA. Mais l’ingénierie du contexte a aussi mis en lumière un véritable problème : connecter des outils entre eux est difficile, et le refaire encore et encore pour chaque nouvel agent devient une charge d’ingénierie considérable.
Pour décharger les ingénieurs de ce fardeau, il faut monter dans le stack. Il ne suffit pas de fournir aux équipes des points de terminaison de données et des actions prêts à l’emploi en espérant qu’ils se comportent de manière fiable dans un environnement d’entreprise. Vous avez besoin d’un socle contextualisé en dessous :
- Des connecteurs de données qui récupèrent des informations complètes et autorisées
- Des index qui offrent une recherche rapide et précise
- Des graphes de connaissances qui cartographient les relations et permettent un raisonnement multi-saut
- Des graphes de contexte qui comprennent les processus de travail
Sans ce socle, vous ne pouvez pas tirer de valeur de vos données, les décisions sont mal informées et erronées, et vous vous retrouvez avec ce que 2025 nous a aussi permis de nommer : le work slop.
Ce que j’ai été ravi de voir pendant les fêtes, c’est que le contexte est passé de la simple compréhension de vos données à la compréhension de votre entreprise et de vos façons de travailler, grâce aux graphes de contexte. Lors des précédentes ères des données, nous nous concentrions uniquement sur l’enregistrement des décisions (c’est-à-dire les systèmes de référence), sans chercher à comprendre comment ces décisions avaient été prises. Mais aujourd’hui, avec les agents, il y a de la valeur à comprendre ces processus : l’automatisation agentique. Cela donne davantage de travail à faire aux agents, car ils peuvent prendre de meilleures décisions en apprenant comment le travail s’accomplit réellement.
Il y a une autre raison pour laquelle vous voulez tout votre contexte au même endroit. C’est parce que chaque cas d’usage significatif de l’IA s’étend sur plusieurs systèmes. Lorsque chaque produit vertical construit ses propres connecteurs, vous obtenez N copies d’intégrations fragiles, des sémantiques incohérentes, des revues de sécurité plus longues et une charge de maintenance croissante.
Enfin, les entreprises avec lesquelles nous travaillons commencent à comprendre que le contexte constitue un domaine clé de verrouillage potentiel pour la pile d'agents. Si vous passez des années à entraîner un système d'IA à vraiment comprendre votre entreprise et que vous développez sa mémoire au fil d'années d'interactions avec l'ensemble de vos collaborateurs et de vos processus métier, que se passe-t-il lorsque vous souhaitez passer à un nouveau modèle d'IA ou à un nouveau fournisseur ? Tout ce contexte et cet apprentissage sont-ils perdus, et devez-vous recommencer à zéro ? Avec la bonne architecture d'agents, vous pouvez séparer tout votre contexte de la couche du modèle. Vous conservez ainsi votre propriété intellectuelle, et les données précieuses qu'elle contient ne sont pas verrouillées à un seul modèle ou fournisseur.
Modèles
Nous ne serions pas là où nous en sommes aujourd'hui avec les agents sans les modèles de raisonnement modernes. GPT-5 a fait progresser le raisonnement à long horizon, Claude reste le plus performant pour le code et l'utilisation d'outils, et Gemini Flash montre ce qui est possible avec une inférence extrêmement rapide et à faible latence. Les modèles d'aujourd'hui sont remarquables par l'éventail de tâches qu'ils peuvent prendre en charge.
Mais malgré les discours sur la banalisation, il est clair que nous nous dirigeons vers un avenir fait de modèles et de fournisseurs multiples. Chez Glean, nous sélectionnons déjà différents modèles pour différentes tâches : génération d'images, génération de code, recherche approfondie, routage léger, quel que soit le fournisseur. Des tâches différentes exigent des modèles différents ; cela ne changera pas. Être agnostique vis-à-vis des modèles vous garantit toujours l'accès aux dernières capacités.
Il existe également une raison plus fondamentale pour laquelle les fournisseurs de modèles ne posséderont pas la couche de contexte : l'économie. Les coûts d'entraînement ont été multipliés par 2 à 3 à chaque génération, chaque modèle de pointe coûtant désormais des centaines de millions de dollars rien qu'en puissance de calcul pour l'entraînement. Seule une poignée d'organisations peuvent opérer à cette échelle, ce qui signifie que les modèles de pointe deviennent une infrastructure partagée plutôt que quelque chose que chaque entreprise construit.
Et cette ligne de démarcation est importante : les fournisseurs de modèles resteront concentrés sur le développement des modèles, car construire et maintenir la couche de contexte représente un investissement entièrement différent, tout aussi massif, qu'il faut réussir.
Orchestration
L'orchestration a beaucoup fait parler d'elle récemment, et pour de bonnes raisons. L'orchestration est ce qui se rapproche le plus de véritables applications : elle utilise les données de l'entreprise, applique les bonnes compétences, orchestre l'automatisation à partir des systèmes métier et apprend de l'exécution répétée pour accomplir le travail de manière fiable. Par conséquent, nous allons voir émerger des orchestrateurs incroyables pour des cas d'usage de niche et départementaux, tout comme nous l'avons déjà vu avec des outils tels que Cursor pour l'ingénierie, Trupeer pour les vidéos produit et Airops pour le contenu SEO.
Mais il existe aussi un réel besoin d'orchestration horizontale, car ces centaines d'agents personnalisés pour votre entreprise couvrent de multiples systèmes, équipes et sources de données. C'est là qu'une pile horizontale apporte une valeur exceptionnelle. Chez Glean, nous nous concentrons sur une IA qui transforme le fonctionnement de départements entiers : assistance, ventes, ingénierie et au-delà. Pour bien y parvenir, il faut comprendre comment ces fonctions opèrent réellement : leurs processus, leurs transmissions, leurs flux de données et leurs points de décision. Une fois cela compris, vous pouvez coordonner les bonnes données et les bonnes actions pour automatiser de véritables workflows.
Si vous zoomez, vous remarquerez que les deux parties de la pile qui doivent être étroitement couplées sont la couche de données et la couche d'orchestration. Sans contexte d'entreprise — connecteurs, index, signaux, modèles de processus et relations — un orchestrateur ne peut pas prendre de bonnes décisions ni automatiser le travail de manière fiable. Et dans l'autre sens, chaque exécution d'agent produit de nouvelles traces et de nouveaux retours qui améliorent la couche de contexte. Chaque exécution apprend au système ce qui a fonctionné, ce qui n'a pas fonctionné et comment optimiser la prochaine exécution.
Cette boucle de rétroaction — le contexte qui alimente l'orchestration, et l'orchestration qui renforce le contexte — est ce qui rend possible une automatisation fiable et durable.
Sécurité
La sécurité est le seul domaine où les entreprises ne peuvent tout simplement pas tolérer la fragmentation. Si chaque solution ponctuelle requiert son propre modèle de sécurité, vous finissez par dupliquer les efforts, élargir votre surface d'attaque et appliquer les politiques de manière incohérente.
Chaque vague d'innovation en IA — du RAG aux agents en passant par la génération de code — a introduit de nouveaux besoins en matière de sécurité, obligeant les entreprises à développer de nouvelles stratégies. Chaque vague d'IA doit reposer sur les mêmes fondations de sécurité : isoler les données et les modèles pour empêcher les fuites, appliquer des normes solides de réseau et de chiffrement, et garantir une identité de niveau entreprise grâce au SSO.
Ce que vous attendez vraiment des acteurs horizontaux, ce n'est pas d'assumer la responsabilité de trouver comment protéger chaque nouvelle innovation : vous voulez une sécurité intégrée. Lorsque vous recherchez dans les données de votre entreprise, le contenu sensible ne devrait pas apparaître accidentellement. Lorsque vous confiez une tâche à un agent, il ne devrait pas entreprendre d'actions que vous n'avez pas autorisées. Lorsque vous générez du code, il ne devrait pas s'échapper de votre environnement privé. Ces protections devraient être activées par défaut.
Vous pouvez assumer ce fardeau vous-même, ou vous pouvez vous associer à des fournisseurs horizontaux qui appliquent un modèle de sécurité unifié à l'ensemble de vos données, de vos applications et de vos workflows d'agents. Cette prise de conscience — le besoin d'une sécurité cohérente et centralisée — est l'une des forces majeures qui pousse à la consolidation des architectures d'agents.
Interfaces
Nous avons passé une grande partie de 2025 ancrés à l'interface de chat. Et même si le chat ne va pas disparaître, il ne sera pas le seul moyen par lequel les collaborateurs interagissent avec les agents. Chez Glean, nous le constatons déjà dans les schémas d'utilisation : l'adoption est la plus forte lorsque les agents sont intégrés directement dans les applications métier que les gens utilisent chaque jour. À mesure que les organisations introduisent davantage d'agents, elles auront besoin que ces agents apparaissent partout où le travail se fait.
C'est pourquoi je crois que 2026 ouvrira une nouvelle vague d'interfaces d'agents. Au-dessus des couches horizontales de la pile, nous verrons des agents et des interfaces verticaux, spécifiques à un domaine : des copilotes d'assistance pour le service client, des assistants commerciaux, des outils de productivité pour l'ingénierie, des tableaux de bord pour les CIO, des copilotes RH et financiers, et des agents intégrés au sein des applications SaaS.
Ces expériences ne devraient pas réinventer le contexte et la sécurité : elles devraient s'appuyer sur les couches qui existent déjà, tout en y superposant les outils et workflows spécifiques au domaine qui les rendent utiles. Avec la bonne architecture d'agents, vous pouvez construire et entraîner votre pile de contexte d'entreprise une seule fois, et la connecter largement à travers votre entreprise de manière pérenne.
L'architecture d'agents
Alors que les entreprises convergent vers des plateformes d'IA, elles auraient tout intérêt à ne pas opter pour le monolithique : choisir un seul fournisseur qui tente de tout faire, finit par ne rien faire en profondeur et rejette le dur travail d'intégration sur vous, le client. Vous vous retrouvez à câbler des outils, réconcilier des modèles de données, greffer de la gouvernance et assembler des workflows qui auraient dû être des citoyens de première classe.
L'état d'esprit d'une architecture ouverte est différent. Il reconnaît qu'aucun monolithe unique ne peut suivre le rythme de l'innovation en IA. Au lieu de cela, une pile technologique se compose de couches différenciées — modèles, contexte et orchestration, interfaces — dont chacune peut évoluer indépendamment tout en fonctionnant de concert. Les piles permettent aux fournisseurs de choisir leurs domaines de spécialisation, leurs partenariats et les points où ils restent ouverts à l'intégration et aux nouveaux standards.
Cette approche a bien plus de valeur pour les entreprises. Elle vous offre de la flexibilité sans sacrifier la qualité, vous permet d'adopter de nouvelles capacités dès leur apparition et vous évite de vous enfermer dans un écosystème fermé incapable de suivre le rythme. Une pile d'agents bien conçue est par nature pérenne et centralisée, car chaque couche horizontale peut s'améliorer selon son propre calendrier — sans vous obliger à tout reconstruire autour d'elle.
