
Comment les agents alimentés par l’IA apprennent-ils ? Mécanismes clés expliqués
Un agent IA apprend lorsqu’il modifie son comportement futur en fonction des résultats de ses actions passées, plutôt que d’exécuter plus vite un script figé. Il observe les résultats, les compare à un objectif et ajuste la façon dont il planifie, décide ou agit la prochaine fois.
Tous les systèmes d’IA ne fonctionnent pas ainsi. Les agents réflexes simples, les agents basés sur des objectifs et les agents basés sur l’utilité suivent des règles ou des modèles prédéfinis et ne mettent jamais à jour leur comportement. Un agent apprenant fonctionne différemment : il associe un élément de performance qui prend les décisions, un élément d’apprentissage qui les ajuste, et un critique qui évalue chaque action et attribue des récompenses ou des pénalités.
Cette distinction compte lorsque vous décidez où appliquer l’IA dans vos workflows. Une automatisation statique répète les mêmes étapes quels que soient les résultats, tandis qu’un agent adaptatif s’améliore grâce à l’interaction avec des données réelles et des utilisateurs — et cela reste rare, avec seulement 16 % des déploiements en entreprise qui se qualifient comme de véritables agents capables de planifier, d’observer les retours et de s’adapter. Les sections ci-dessous détaillent les mécanismes qui rendent cette amélioration possible.
Comment le machine learning alimente l’adaptation des agents IA
Le machine learning est la base qui permet à un agent IA de s’adapter. Au lieu de suivre des règles codées en dur, l’agent identifie des motifs, fait des prédictions et affine ses décisions à partir des données. Trois méthodes d’entraînement réalisent l’essentiel de ce travail, et chacune correspond à un type de problème différent.
L’apprentissage supervisé entraîne un agent à partir de paires d’entrées et de sorties étiquetées, par exemple d’anciens échanges de support associés à leurs résultats de résolution. L’agent mesure l’écart entre sa prédiction et la bonne réponse connue, puis ajuste ses paramètres pour le réduire. Le transfer learning prolonge cette approche en affinant un modèle général pour un domaine spécifique, de sorte qu’un modèle entraîné de façon large puisse être adapté au langage des métiers juridiques, médicaux ou financiers.
L’apprentissage non supervisé identifie une structure dans des données non étiquetées. L’agent regroupe des documents similaires, fait ressortir des clusters de comportements clients et signale des anomalies comme des entrées inhabituelles dans un journal de sécurité, sans qu’on lui dise à l’avance quoi rechercher.
L’apprentissage par renforcement enseigne par essais et erreurs. L’agent entreprend une action, reçoit une récompense ou une pénalité, et apprend à optimiser une récompense cumulative à long terme plutôt qu’une unique réponse correcte. Cette méthode prend toute sa valeur dans des contextes dynamiques et multi-étapes, comme le routage d’une demande, l’allocation de ressources ou l’orchestration d’un workflow, où des règles figées ne peuvent pas anticiper tous les scénarios.
Pourquoi les boucles de feedback sont le moteur de l’amélioration continue
Les boucles de feedback transforment l’expérience brute en meilleures performances, et c’est ce qui distingue un agent qui progresse d’un agent qui ne fait que répéter. Sans signal indiquant à l’agent si une action a fonctionné, il n’a aucun moyen de distinguer un bon résultat d’un mauvais, donc rien ne change.
Trois types de feedback pilotent le processus. Le feedback sur les résultats provient des résultats eux-mêmes : temps de résolution, précision, réalisation des tâches et scores de satisfaction. Le feedback humain prend la forme d’approbations, de corrections, de modifications et de rejets qui deviennent de nouvelles données d’entraînement — un signal si puissant qu’un modèle de 1,3B de paramètres affiné avec du feedback humain a produit des sorties que les gens ont préférées à celles d’un modèle 100 fois plus grand. Le feedback auto-généré se produit lorsque l’agent critique son propre brouillon pour en vérifier la cohérence et l’ancrage avant de finaliser une réponse.
Ensemble, ils alimentent un cycle répétitif. L’agent exécute une action, évalue le résultat par rapport à des critères de réussite, analyse où il a échoué, ajuste son approche et recommence, en faisant tourner cette boucle automatiquement à chaque interaction plutôt que lors d’une revue trimestrielle.
La qualité du signal détermine la vitesse des progrès. Les rejets étiquetés, les sorties notées et des KPI mesurables donnent à l’agent une direction précise, tandis que des commentaires ponctuels et dispersés le laissent deviner. Lorsque vous concevez dès le départ un feedback structuré dans un workflow, vous réduisez la distance entre une erreur et sa correction.
Comment la mémoire et le contexte rendent les agents plus intelligents au fil du temps
La mémoire permet à un agent IA de conserver les enseignements au lieu de résoudre chaque problème à partir de zéro. Sans mémoire, chaque requête repart à zéro, et l’agent qui a traité hier une question presque identique n’en retire aucun bénéfice.
Deux types de mémoire font le travail. La mémoire sémantique est une base de connaissances structurée de faits, de règles et de politiques sur laquelle l’agent peut s’appuyer. La mémoire épisodique conserve des traces des interactions passées, des décisions prises et de leurs résultats.
L’interaction entre les deux est à l’origine de la reconnaissance de motifs. Chaque nouvelle expérience enrichit la base de connaissances, et la base de connaissances donne du sens à l’expérience suivante : l’agent commence ainsi à reconnaître qu’une certaine formulation signale un problème de facturation, ou qu’un document résout systématiquement une catégorie de tickets.
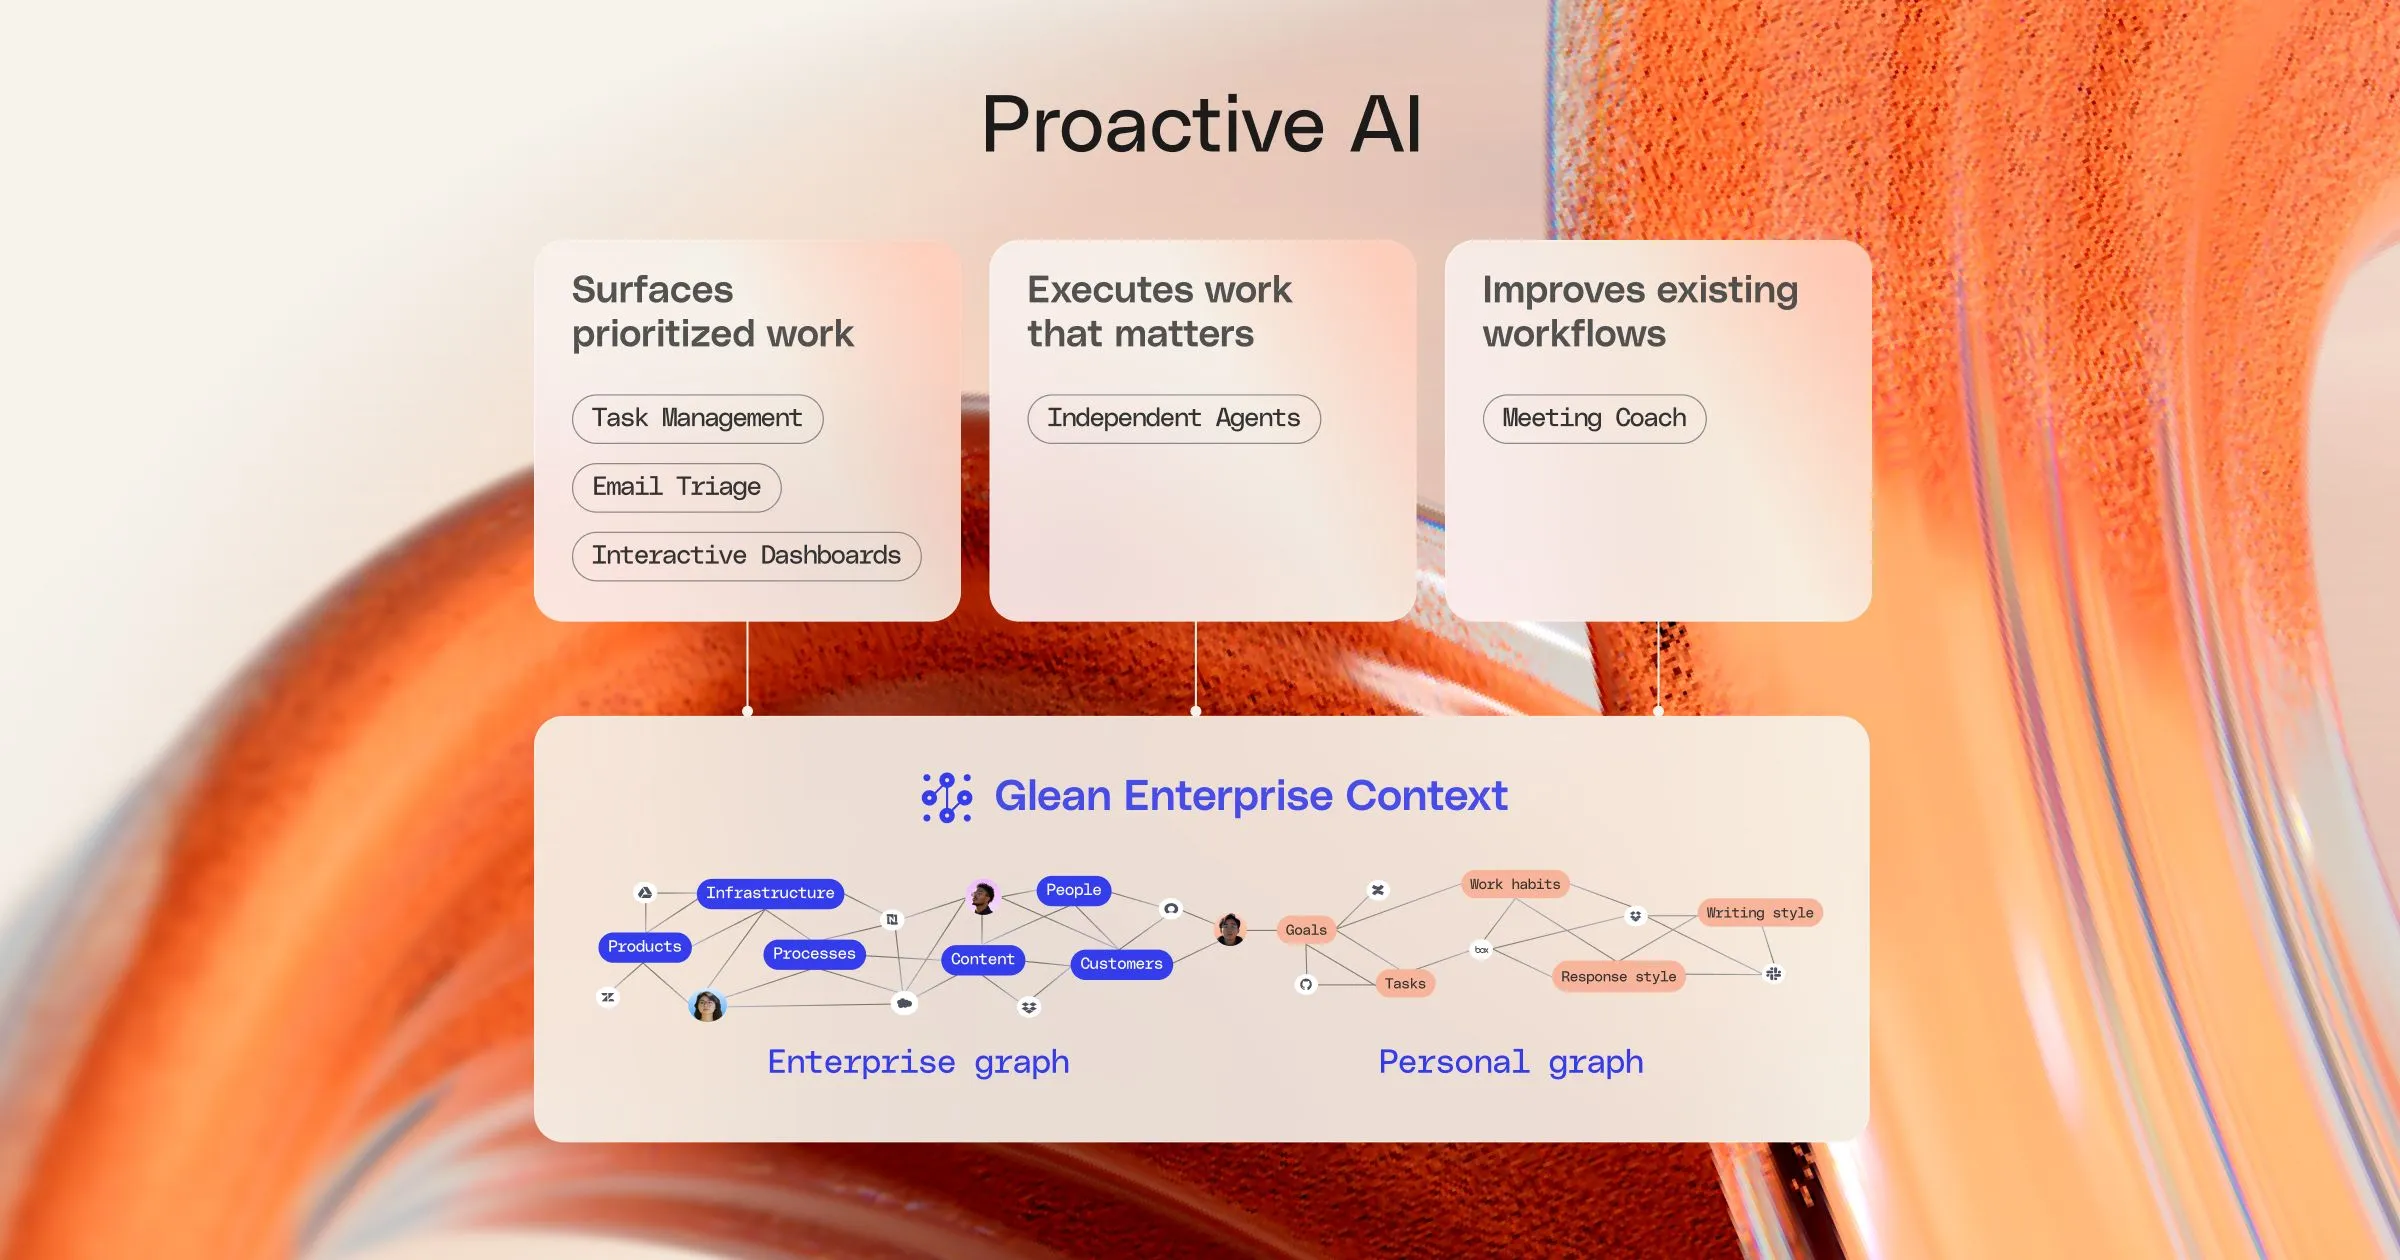
Le contexte affine l’ensemble. Savoir qui pose la question, dans quelle équipe la personne se trouve, quels outils elle utilise et ce qu’elle a demandé auparavant permet à l’agent de pondérer la pertinence au lieu de traiter chaque requête comme générique. Un graphe de connaissances d’entreprise qui cartographie les relations entre les personnes, les contenus et les workflows est fondamental ici ; c’est la couche que des plateformes comme Glean utilisent pour ancrer un agent dans la réalité spécifique de votre organisation plutôt que dans le web ouvert.
Comment la collaboration multi-agents accélère l’apprentissage
La collaboration multi-agents accélère l’apprentissage, car un groupe d’agents met en commun une expérience qu’aucun agent ne pourrait acquérir seul. Un agent isolé n’apprend que des demandes qu’il traite personnellement, ce qui limite la vitesse à laquelle il peut s’améliorer.
Placez plusieurs agents dans une architecture partagée, et les règles du jeu changent. Dans une configuration coopérative, les agents travaillent vers un objectif commun et se transmettent des connaissances, de sorte qu’une leçon découverte par un agent devient accessible aux autres. Une couche d’orchestration se situe au-dessus d’eux, en acheminant chaque tâche vers le bon agent et en faisant circuler l’information là où elle doit aller.
La spécialisation est ce qui rend cet agencement puissant. Un agent dédié au support client, un autre à la préparation commerciale, et un troisième à l’accès aux connaissances internes vont chacun très loin dans leur domaine tout en renvoyant des signaux vers le système partagé.
Le résultat se cumule. Parce que chaque spécialiste apporte ce qu’il apprend et exploite ce que les autres apprennent, le système dans son ensemble devient plus intelligent plus vite que ne le pourrait jamais un agent individuel opérant en isolation.
Quels garde-fous garantissent un apprentissage sûr et fiable des agents IA
Les garde-fous empêchent un agent auto-améliorant de s’enseigner de mauvaises leçons, et ils deviennent d’autant plus importants que l’autonomie augmente. Plus un agent a de liberté pour planifier et agir, plus il a besoin de gouvernance pour rester digne de confiance.
Le risque principal est qu’un agent apprenne avec assurance à partir d’entrées erronées. Des données biaisées, de rares cas limites, et des objectifs qui dérivent de ce que vous voulez réellement peuvent tous orienter le comportement dans la mauvaise direction, et un mauvais schéma appris silencieusement est difficile à repérer plus tard.
Une architecture tenant compte des autorisations constitue la première ligne de défense. Lorsque les autorisations se situent en amont du modèle, l’agent ne peut apprendre qu’à partir de données qu’il est autorisé à voir, ce qui maintient les informations sensibles hors de son signal d’entraînement par conception. Des étapes d’approbation et des règles d’escalade ajoutent une deuxième couche, en soumettant les actions à fort enjeu à une validation humaine avant exécution.
Deux autres contrôles comblent l’écart. L’évaluation et les tests continus détectent les régressions silencieuses avant qu’elles n’atteignent les utilisateurs, et des pistes d’audit détaillées enregistrent ce que l’agent a fait et pourquoi, afin que la responsabilité reste intacte lorsque vous devez retracer une décision.
Comment évaluer si vos agents IA s’améliorent réellement
Vous évaluez un agent IA en le mesurant, pas en supposant que les gains sont réels. Des progrès qui ne sont pas suivis ne sont qu’une intuition, et les intuitions ont tendance à flatter la technologie pour laquelle vous avez payé.
Regroupez vos mesures en trois familles. Les métriques de qualité couvrent l’exactitude, la pertinence et la cohérence des résultats de l’agent. Les métriques de résultat relient l’agent au business : temps de résolution, taux de déflexion, délai de montée en productivité, vélocité du pipeline, et coût par interaction. Les métriques de vitesse d’apprentissage indiquent si l’agent s’améliore, via des taux d’approbation en hausse au fil du temps, une fréquence de révision en baisse, des réussites répétées sur des tâches similaires, et un temps de débogage plus court.
L’évaluation automatisée rend cela praticable à grande échelle. Un évaluateur IA peut noter en continu chaque sortie, ce qui vous donne une lecture de la qualité sans demander à une personne de passer en revue chaque interaction manuellement. Des travaux de recherche sur l’utilisation de grands modèles de langage comme évaluateurs ont constaté qu’un juge de modèle performant tel que GPT-4 est d’accord avec les préférences humaines plus de 80 % du temps, soit le même taux d’accord entre deux évaluateurs humains (Zheng et al., 2023). À ce niveau de concordance, vous pouvez faire confiance à un évaluateur automatisé pour fonctionner de manière autonome et réserver la revue humaine aux cas les plus importants.
Lisez les chiffres le long d’une courbe de maturité. Les équipes commencent généralement par des revues manuelles, passent au scoring automatisé, puis opérationnalisent l’apprentissage continu : suivez donc où vous vous situez et ce que l’étape suivante exige.
Comment mettre en place des agents IA pour un apprentissage efficace dans votre organisation
Configurez vos agents pour apprendre en commençant là où les données sont les plus riches et les volumes les plus élevés. Des workflows à fort trafic et bien documentés donnent à un agent la répétition dont il a besoin pour s’améliorer rapidement, c’est pourquoi le support client, l’onboarding des employés, l’activation commerciale, et l’accès aux connaissances internes constituent de solides premiers déploiements — une priorité pour les 62 % d’organisations qui expérimentent déjà avec des agents IA.
Poser les bonnes fondations compte plus que d’aller vite. Suivez un ordre clair :
- Construisez l’infrastructure de feedback et définissez à quoi ressemble le succès avant de déployer, afin que l’agent ait, dès sa première interaction, une base concrète sur laquelle apprendre.
- Préparez des données propres, connectées et tenant compte des autorisations, car un agent entraîné sur des informations désordonnées ou trop exposées apprend des habitudes désordonnées et risquées.
- Concevez une revue human-in-the-loop dès le premier jour, en gardant des personnes dans le circuit d’approbation tant que l’exactitude n’est pas encore prouvée.
- Réduisez la surface d’approbation à mesure que l’agent gagne en confiance, en faisant passer les humains de la vérification systématique au contrôle ponctuel des exceptions.
- Montez en charge progressivement sur de nouveaux workflows une fois que les premiers montrent des gains stables et mesurables.
Cet ordre vous protège à deux reprises. Vous collectez le signal qui alimente l’apprentissage, et vous gardez une personne dans la boucle exactement aussi longtemps que les données indiquent que vous le devez.
Questions fréquentes
Quels sont les mécanismes clés par lesquels les agents IA apprennent ?
Les agents IA apprennent via le machine learning sur les données, des boucles de feedback qui évaluent leurs actions, une mémoire qui stocke les interactions passées et les connaissances, et le contexte qui affine la pertinence. Dans des systèmes partagés, ils apprennent aussi les uns des autres. Les garde-fous sécurisent le processus, et les métriques confirment si l’apprentissage est réel.
Comment les boucles de feedback contribuent-elles à l’amélioration des agents IA ?
Les boucles de feedback donnent à un agent un signal indiquant si une action a réussi, ce qui est le seul moyen pour lui de distinguer un bon résultat d’un mauvais. L’agent agit, évalue selon des critères de succès, ajuste, et recommence. Un feedback structuré, comme des sorties scorées et des rejets étiquetés, accélère fortement ce processus.
Quels types de données les agents IA utilisent-ils pour apprendre et s’adapter ?
Les agents apprennent à partir d’exemples étiquetés, comme des tickets passés associés à leurs résultats, de données non étiquetées où ils identifient des clusters et des anomalies, ainsi que de signaux de récompense issus d’essais et d’erreurs. Ils s’appuient aussi sur les interactions enregistrées, une base de connaissances structurée, et le contexte sur qui pose la question et pourquoi.
Les agents IA peuvent-ils apprendre grâce aux retours humains, et si oui, comment ?
Oui. Les retours humains sont l’un des signaux d’apprentissage les plus puissants dont dispose un agent. Les validations, corrections, modifications et refus deviennent des données d’entraînement qui apprennent à l’agent à quoi ressemble une bonne réponse. Étiqueter ce feedback, plutôt que de laisser des notes en texte libre, donne à l’agent une direction plus claire et accélère les progrès.
Quel rôle l’apprentissage par renforcement joue-t-il dans le développement des agents IA ?
L’apprentissage par renforcement enseigne un agent par essais et erreurs, en récompensant les bonnes actions et en pénalisant les mauvaises, afin qu’il optimise les résultats à long terme. Sa valeur se manifeste dans des tâches dynamiques et multi-étapes comme l’acheminement des demandes, l’allocation des ressources et l’orchestration des workflows, où des règles fixes ne peuvent pas anticiper toutes les situations auxquelles l’agent sera confronté.
À mesure que vos agents IA intègrent les retours, conservent le contexte et se coordonnent à travers les workflows, ils deviennent meilleurs dans le travail spécifique que vos équipes réalisent chaque jour. Les mécanismes derrière cette amélioration — du machine learning et de l’évaluation aux garde-fous et à la mémoire — ne portent leurs fruits que s’ils s’appuient sur des connaissances auxquelles votre organisation peut faire confiance et sur des permissions qu’elle respecte déjà. Si vous souhaitez voir comment les agents apprennent et s’adaptent au sein de votre propre environnement, demandez une démo et nous vous montrerons comment Glean met cela en pratique.